O23390
Gene name |
BARS1 (PEN2, At4g15370, dl3730c, FCAALL.279) |
Protein name |
Baruol synthase |
Names |
AtBARS1, Pentacyclic triterpene synthase 2, AtPEN2 |
Species |
Arabidopsis thaliana (Mouse-ear cress) |
KEGG Pathway |
ath:AT4G15370 |
EC number |
5.4.99.57: Transferring other groups |
Protein Class |
|
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
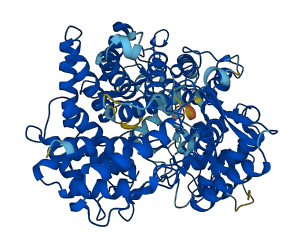
1 structures for O23390
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-O23390-F1 | Predicted | AlphaFoldDB |
116 variants for O23390
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
| ENSVATH06675577 | 7 | G>D | No | 1000Genomes | |
| ENSVATH06675576 | 17 | F>L | No | 1000Genomes | |
| ENSVATH11783259 | 33 | N>D | No | 1000Genomes | |
| ENSVATH11783258 | 37 | P>S | No | 1000Genomes | |
| ENSVATH02841899 | 48 | R>Q | No | 1000Genomes | |
| tmp_4_8779541_T_C | 49 | N>D | No | 1000Genomes | |
| tmp_4_8779507_C_G | 60 | S>T | No | 1000Genomes | |
| ENSVATH14203374 | 62 | D>G | No | 1000Genomes | |
| tmp_4_8779484_G_T | 68 | Q>K | No | 1000Genomes | |
| ENSVATH11783255 | 76 | E>G | No | 1000Genomes | |
| tmp_4_8779323_T_C | 89 | K>E | No | 1000Genomes | |
| tmp_4_8779316_G_A | 91 | T>M | No | 1000Genomes | |
| tmp_4_8779301_T_A | 96 | K>M | No | 1000Genomes | |
| ENSVATH02841881 | 103 | L>I | No | 1000Genomes | |
| tmp_4_8779278_G_C | 104 | L>V | No | 1000Genomes | |
| tmp_4_8779269_T_A | 107 | T>S | No | 1000Genomes | |
| tmp_4_8779059_T_C | 142 | K>E | No | 1000Genomes | |
| tmp_4_8779044_C_T | 147 | E>K | No | 1000Genomes | |
| ENSVATH11783232 | 149 | R>H | No | 1000Genomes | |
| ENSVATH11783225 | 166 | W>R | No | 1000Genomes | |
| ENSVATH02841861 | 170 | V>I | No | 1000Genomes | |
| tmp_4_8778623_T_C | 175 | N>S | No | 1000Genomes | |
| tmp_4_8778614_C_T | 178 | C>Y | No | 1000Genomes | |
| ENSVATH02841859 | 179 | S>T | No | 1000Genomes | |
| ENSVATH02841857 | 195 | H>Y | No | 1000Genomes | |
| tmp_4_8778558_C_A | 197 | D>Y | No | 1000Genomes | |
| ENSVATH02841855 | 198 | K>E | No | 1000Genomes | |
| tmp_4_8778545_G_A | 201 | A>V | No | 1000Genomes | |
| ENSVATH11783204 | 215 | A>S | No | 1000Genomes | |
| ENSVATH06675561 | 219 | P>T | No | 1000Genomes | |
| ENSVATH02841839 | 246 | F>L | No | 1000Genomes | |
| ENSVATH02841837 | 251 | F>L | No | 1000Genomes | |
| tmp_4_8778166_A_G | 251 | F>S | No | 1000Genomes | |
| tmp_4_8778157_T_C | 254 | N>S | No | 1000Genomes | |
| ENSVATH06675551 | 260 | I>V | No | 1000Genomes | |
| ENSVATH02841830 | 276 | N>K | No | 1000Genomes | |
| tmp_4_8777972_G_A | 280 | T>I | No | 1000Genomes | |
| tmp_4_8777930_G_A | 294 | P>L | No | 1000Genomes | |
| ENSVATH00507504 | 295 | E>D | No | 1000Genomes | |
| ENSVATH02841826 | 296 | P>A | No | 1000Genomes | |
| tmp_4_8777924_G_A | 296 | P>L | No | 1000Genomes | |
| ENSVATH02841825 | 299 | N>K | No | 1000Genomes | |
| ENSVATH02841824 | 301 | S>N | No | 1000Genomes | |
| ENSVATH14203340 | 305 | A>S | No | 1000Genomes | |
| ENSVATH11783105 | 305 | A>V | No | 1000Genomes | |
| ENSVATH11782734 | 313 | D>V | No | 1000Genomes | |
| tmp_4_8776589_A_T | 320 | F>L | No | 1000Genomes | |
| tmp_4_8776585_G_T | 322 | Q>K | No | 1000Genomes | |
| ENSVATH14203287 | 323 | D>Y | No | 1000Genomes | |
| tmp_4_8776573_A_T | 326 | W>R | No | 1000Genomes | |
| ENSVATH06675532 | 328 | G>S | No | 1000Genomes | |
| ENSVATH02841780 | 330 | H>Q | No | 1000Genomes | |
| ENSVATH02841779 | 331 | V>I | No | 1000Genomes | |
| tmp_4_8776483_C_T | 356 | E>K | No | 1000Genomes | |
| tmp_4_8776480_G_A | 357 | L>F | No | 1000Genomes | |
| tmp_4_8776459_C_A | 364 | A>S | No | 1000Genomes | |
| ENSVATH06675531 | 370 | G>C | No | 1000Genomes | |
| ENSVATH06675530 | 374 | P>L | No | 1000Genomes | |
| tmp_4_8776306_C_G | 385 | C>S | No | 1000Genomes | |
| ENSVATH06675522 | 389 | D>N | No | 1000Genomes | |
| ENSVATH02841769 | 402 | V>I | No | 1000Genomes | |
| ENSVATH02841767 | 415 | I>F | No | 1000Genomes | |
| tmp_4_8776078_G_A | 421 | Q>* | No | 1000Genomes | |
| ENSVATH02841761 | 422 | V>L | No | 1000Genomes | |
| tmp_4_8776048_C_G | 431 | V>L | No | 1000Genomes | |
| ENSVATH02841757 | 439 | D>H | No | 1000Genomes | |
| ENSVATH00507498 | 445 | R>K | No | 1000Genomes | |
| ENSVATH02841754 | 456 | E>K | No | 1000Genomes | |
| tmp_4_8775948_G_A | 464 | P>L | No | 1000Genomes | |
| ENSVATH06675517 | 467 | D>N | No | 1000Genomes | |
| ENSVATH06675516 | 469 | M>V | No | 1000Genomes | |
| ENSVATH11782727 | 519 | V>E | No | 1000Genomes | |
| tmp_4_8775677_T_C | 523 | Y>C | No | 1000Genomes | |
| tmp_4_8775669_C_T | 526 | V>I | No | 1000Genomes | |
| tmp_4_8775665_T_C | 527 | D>G | No | 1000Genomes | |
| tmp_4_8775657_G_A | 530 | L>F | No | 1000Genomes | |
| ENSVATH02841721 | 546 | D>E | No | 1000Genomes | |
| tmp_4_8774660_C_T | 557 | V>I | No | 1000Genomes | |
| ENSVATH14203220 | 571 | V>L | No | 1000Genomes | |
| tmp_4_8774508_G_A | 574 | A>V | No | 1000Genomes | |
| tmp_4_8774497_T_C | 578 | K>E | No | 1000Genomes | |
| ENSVATH06675488 | 586 | E>K | No | 1000Genomes | |
| ENSVATH00507491 | 601 | D>N | No | 1000Genomes | |
| ENSVATH00507490 | 602 | L>F | No | 1000Genomes | |
| tmp_4_8774419_T_C | 604 | M>V | No | 1000Genomes | |
| ENSVATH06675483 | 627 | G>S | No | 1000Genomes | |
| ENSVATH06675482 | 631 | A>G | No | 1000Genomes | |
| ENSVATH11782518 | 640 | A>T | No | 1000Genomes | |
| ENSVATH02841714 | 642 | R>C | No | 1000Genomes | |
| tmp_4_8774296_C_A | 645 | V>F | No | 1000Genomes | |
| ENSVATH06675480 | 646 | R>H | No | 1000Genomes | |
| ENSVATH06675478 | 651 | T>N | No | 1000Genomes | |
| ENSVATH06675477 | 654 | T>M | No | 1000Genomes | |
| ENSVATH02841712 | 654 | T>P | No | 1000Genomes | |
| ENSVATH02841712 | 654 | T>S | No | 1000Genomes | |
| ENSVATH02841709 | 671 | I>S | No | 1000Genomes | |
| tmp_4_8774208_A_G | 674 | I>T | No | 1000Genomes | |
| ENSVATH02841707 | 674 | I>V | No | 1000Genomes | |
| tmp_4_8774190_A_T | 680 | V>E | No | 1000Genomes | |
| tmp_4_8774165_C_G | 688 | M>I | No | 1000Genomes | |
| ENSVATH14203219 | 689 | V>L | No | 1000Genomes | |
| ENSVATH02841706 | 693 | G>R | No | 1000Genomes | |
| ENSVATH08342457 | 694 | N>D | No | 1000Genomes | |
| ENSVATH08342456 | 697 | K>E | No | 1000Genomes | |
| ENSVATH02841705 | 700 | P>L | No | 1000Genomes | |
| ENSVATH14203218 | 701 | L>F | No | 1000Genomes | |
| tmp_4_8774116_G_A | 705 | R>C | No | 1000Genomes | |
| ENSVATH02841702 | 715 | M>L | No | 1000Genomes | |
| tmp_4_8774061_T_G | 723 | Q>P | No | 1000Genomes | |
| ENSVATH06675474 | 738 | P>A | No | 1000Genomes | |
| tmp_4_8773847_T_A | 740 | Y>F | No | 1000Genomes | |
| ENSVATH06675473 | 743 | M>I | No | 1000Genomes | |
| tmp_4_8773830_G_A | 746 | L>F | No | 1000Genomes | |
| tmp_4_8773793_C_A | 758 | G>V | No | 1000Genomes | |
| tmp_4_8773791_G_A | 759 | L>F | No | 1000Genomes | |
| tmp_4_8773788_A_T | 760 | L>R | No | 1000Genomes |
No associated diseases with O23390
No regional properties for O23390
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| No domain, repeats, and functional sites for O23390 | |||
Functions
| Description | ||
|---|---|---|
| EC Number | 5.4.99.57 | Transferring other groups |
| Subcellular Localization |
|
|
| PANTHER Family | ||
| PANTHER Subfamily | ||
| PANTHER Protein Class | ||
| PANTHER Pathway Category | No pathway information available | |
1 GO annotations of cellular component
| Name | Definition |
|---|---|
| lipid droplet | An intracellular non-membrane-bounded organelle comprising a matrix of coalesced lipids surrounded by a phospholipid monolayer. May include associated proteins. |
2 GO annotations of molecular function
| Name | Definition |
|---|---|
| baruol synthase activity | Catalysis of the reaction: (S)-2,3-epoxysqualene = baruol. Baruol is also known as D:B-Friedo-Baccharan-5,21-dien-3-ol. |
| beta-amyrin synthase activity | Catalysis of the reaction: (S)-2,3-epoxysqualene = beta-amyrin. This reaction is the cyclization and rearrangement of (S)-2,3-epoxysqualene (2,3-oxidosqualene) into beta-amyrin. |
2 GO annotations of biological process
| Name | Definition |
|---|---|
| tetracyclic triterpenoid biosynthetic process | The chemical reactions and pathways resulting in the formation of tetracyclic triterpenoid compounds, terpenoids with six isoprene units and 4 carbon rings. |
| triterpenoid biosynthetic process | The chemical reactions and pathways resulting in the formation of triterpenoid compounds, terpenoids with six isoprene units. |
11 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| P38604 | ERG7 | Lanosterol synthase ERG7 | Saccharomyces cerevisiae (strain ATCC 204508 / S288c) (Baker's yeast) | PR |
| Q6Z2X6 | Os02g0139700 | Cycloartenol synthase | Oryza sativa subsp japonica (Rice) | PR |
| B6EXY6 | BAS | Beta-amyrin synthase | Arabidopsis thaliana (Mouse-ear cress) | PR |
| P38605 | CAS1 | Cycloartenol synthase | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q1G1A4 | LAS1 | Lanosterol synthase | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9FJV8 | MRN1 | Marneral synthase | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9FR95 | PEN1 | Arabidiol synthase | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9FZI2 | LUP5 | Lupeol synthase 5 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9LVY2 | PEN3 | Tirucalladienol synthase | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9SYN1 | PEN6 | Seco-amyrin synthase | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9FI37 | THAS1 | Thalianol synthase 1 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MWRLRIGAKA | KDNTHLFTTN | NYVGRQIWEF | DANAGSPEEL | AEVEEARRNF | SNNRSRFKAS |
| 70 | 80 | 90 | 100 | 110 | 120 |
| ADLLWRMQFL | REKKFEQKIP | RVIVEDAEKI | TYEDAKTALR | RGLLYFTALQ | ADDGHWPAEN |
| 130 | 140 | 150 | 160 | 170 | 180 |
| AGSIFFNAPF | VICLYITGHL | EKIFTHEHRV | ELLRYMYNHQ | NEDGGWGLHV | ESPSNMFCSV |
| 190 | 200 | 210 | 220 | 230 | 240 |
| INYICLRILG | VEAGHDDKGS | ACARARKWIL | DHGGATYSPL | IGKAWLSVLG | VYDWSGCKPI |
| 250 | 260 | 270 | 280 | 290 | 300 |
| PPEFWFLPSF | FPVNGGTLWI | YLRDIFMGLS | YLYGKNFVAT | STPLILQLRE | EIYPEPYTNI |
| 310 | 320 | 330 | 340 | 350 | 360 |
| SWRQARNRCA | KEDLYYPQSF | LQDLFWKGVH | VFSENILNRW | PFNNLIRQRA | LRTTMELVHY |
| 370 | 380 | 390 | 400 | 410 | 420 |
| HDEATRYITG | GSVPKVIAVF | HMLACWVEDP | ESDYFKKHLA | RVPDFIWIGE | DGLKIQSFGS |
| 430 | 440 | 450 | 460 | 470 | 480 |
| QVWDTALSLH | VFIDGFDDDV | DEEIRSTLLK | GYDYLEKSQV | TENPPGDYMK | MFRHMAKGGW |
| 490 | 500 | 510 | 520 | 530 | 540 |
| TFSDQDQGWP | VSDCTAESLE | CCLFFESMSS | EFIGKKMDVE | KLYDAVDFLL | YLQSDNGGIT |
| 550 | 560 | 570 | 580 | 590 | 600 |
| AWQPADGKLV | EFIEDAVVEH | EYVECTGSAI | VALAQFNKQF | PGYKKEEVER | FITKGVKYIE |
| 610 | 620 | 630 | 640 | 650 | 660 |
| DLQMVDGSWY | GNWGVCFIYG | TFFAVRGLVA | AGKCYNNCEA | IRRAVRFILD | TQNTEGGWGE |
| 670 | 680 | 690 | 700 | 710 | 720 |
| SYLSCPRKKY | IPLIGNKTNV | VNTGQALMVL | IMGNQMKRDP | LPVHRAAKVL | INSQMDNGDF |
| 730 | 740 | 750 | |||
| PQQEIMGVFK | MNVMLHFPTY | RNMFTLWALT | HYTKALRGL |