A6NMX2
Gene name |
EIF4E1B |
Protein name |
Eukaryotic translation initiation factor 4E type 1B |
Names |
|
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:253314 |
EC number |
|
Protein Class |
|
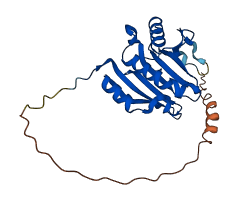
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for A6NMX2
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-A6NMX2-F1 | Predicted | AlphaFoldDB |
234 variants for A6NMX2
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
CA362265171 rs1161156440 |
2 | L>F | No |
ClinGen gnomAD |
|
|
CA362265205 rs1456665243 |
4 | V>I | No |
ClinGen gnomAD |
|
|
CA362265208 rs1456665243 |
4 | V>L | No |
ClinGen gnomAD |
|
|
CA362265248 rs1351122391 |
5 | E>D | No |
ClinGen gnomAD |
|
|
CA362265242 rs1323606026 |
5 | E>V | No |
ClinGen gnomAD |
|
|
rs1213995384 CA362265386 |
6 | V>L | No |
ClinGen TOPMed gnomAD |
|
|
rs781279936 CA3572377 |
7 | S>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs781279936 CA362265397 |
7 | S>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA131882802 rs1019312901 |
9 | A>G | No |
ClinGen Ensembl |
|
|
rs900958550 CA131882803 |
10 | E>Q | No |
ClinGen Ensembl |
|
|
rs1561910516 CA362265445 |
10 | E>V | No |
ClinGen Ensembl |
|
|
CA362265477 rs1445863382 |
12 | G>E | No |
ClinGen TOPMed |
|
|
rs1446506394 CA362265497 |
13 | I>L | No |
ClinGen gnomAD |
|
|
rs114992074 CA3572379 |
13 | I>M | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1342984580 CA362265517 |
14 | R>* | No |
ClinGen TOPMed gnomAD |
|
|
CA362265515 rs1342984580 |
14 | R>G | No |
ClinGen TOPMed gnomAD |
|
|
CA362265524 rs73332163 |
14 | R>L | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs73332163 CA3572380 |
14 | R>Q | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
| TCGA novel | 15 | E>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1272748512 CA362265553 |
16 | W>R | No |
ClinGen TOPMed gnomAD |
|
|
rs774936946 CA362265617 |
19 | E>A | No |
ClinGen ExAC gnomAD |
|
|
CA3572385 rs774936946 |
19 | E>G | No |
ClinGen ExAC gnomAD |
|
|
CA3572384 rs201972753 |
19 | E>K | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
| TCGA novel | 20 | E>G | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs759996438 CA3572387 |
20 | E>K | No |
ClinGen ExAC TOPMed |
|
|
rs73806058 CA3572388 |
21 | K>E | No |
ClinGen 1000Genomes ESP ExAC TOPMed |
|
|
rs775713860 CA3572389 |
21 | K>N | No |
ClinGen ExAC gnomAD |
|
| rs762488024 | 21 | K>missing | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA362265704 rs1456677911 |
25 | A>T | No |
ClinGen TOPMed |
|
|
rs1450775045 CA362265738 |
26 | A>V | No |
ClinGen gnomAD |
|
|
CA362265773 rs1186194856 |
28 | R>S | No |
ClinGen gnomAD |
|
|
CA362265769 rs1245360884 |
28 | R>T | No |
ClinGen TOPMed |
|
|
CA3572391 rs767320217 |
29 | T>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3572392 rs767320217 |
29 | T>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA362265797 rs1173485960 |
30 | P>A | No |
ClinGen TOPMed gnomAD |
|
|
CA362265796 rs1173485960 |
30 | P>T | No |
ClinGen TOPMed gnomAD |
|
|
rs1468649643 CA362265831 |
32 | G>R | No |
ClinGen gnomAD |
|
| TCGA novel | 33 | E>* | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs369219894 CA3572396 |
34 | K>N | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1581186780 CA362265890 |
36 | P>T | No |
ClinGen Ensembl |
|
|
CA131882940 rs940779961 |
37 | N>D | No |
ClinGen TOPMed gnomAD |
|
|
rs1326023499 CA362265959 |
39 | P>R | No |
ClinGen gnomAD |
|
|
rs751278327 CA3572399 |
39 | P>S | No |
ClinGen ExAC |
|
|
rs1234279209 CA362265981 |
41 | T>A | No |
ClinGen TOPMed gnomAD |
|
|
CA3572400 rs756406076 |
41 | T>I | No |
ClinGen ExAC gnomAD |
|
|
CA362265984 rs1234279209 |
41 | T>S | No |
ClinGen TOPMed gnomAD |
|
|
rs899559206 CA131882976 |
42 | L>F | No |
ClinGen TOPMed |
|
|
CA3572401 rs777820315 |
43 | L>P | No |
ClinGen ExAC gnomAD |
|
|
CA131882997 rs996610932 |
44 | S>C | No |
ClinGen TOPMed gnomAD |
|
|
CA362266015 rs996610932 |
44 | S>F | No |
ClinGen TOPMed gnomAD |
|
|
rs1156505496 CA362266021 |
45 | L>R | No |
ClinGen gnomAD |
|
|
CA362266044 rs1402589417 |
47 | G>V | No |
ClinGen TOPMed |
|
|
rs1466227983 CA362266066 |
49 | A>T | No |
ClinGen gnomAD |
|
|
rs117586833 CA3572403 |
50 | R>Q | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA3572402 rs749386549 |
50 | R>W | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA gnomAD |
|
CA3572405 rs779126438 |
51 | T>K | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs779126438 COSM300286 CA3572407 |
51 | T>M | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ExAC NCI-TCGA TOPMed gnomAD |
|
rs775973116 CA362266114 |
52 | G>E | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA362266112 rs1200569664 |
52 | G>R | No |
ClinGen gnomAD |
|
|
rs775973116 CA3572409 |
52 | G>V | No |
ClinGen ExAC TOPMed gnomAD |
|
| rs751393132 | 53 | G>A | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA3572412 rs780180060 |
53 | G>D | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs747289836 CA3572410 |
53 | G>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3572411 rs780180060 |
53 | G>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA362266141 rs772701144 CA3572415 |
55 | M>L | No |
ClinGen ExAC gnomAD |
|
|
CA3572416 rs762984605 |
55 | M>T | No |
ClinGen ExAC gnomAD |
|
|
CA362266190 rs1316862965 |
59 | L>M | No |
ClinGen TOPMed |
|
|
rs1387508185 CA362266213 |
61 | L>P | No |
ClinGen gnomAD |
|
| TCGA novel | 62 | H>Q | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA131883062 rs942366045 |
62 | H>Y | No |
ClinGen Ensembl |
|
|
rs1329632376 CA362266234 |
63 | P>L | No |
ClinGen gnomAD |
|
|
rs751404509 CA3572418 |
65 | Q>K | No |
ClinGen ExAC TOPMed |
|
|
rs1040708758 CA362266270 |
66 | N>K | No |
ClinGen TOPMed gnomAD |
|
|
CA3572419 rs754665422 |
67 | R>K | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3572443 CA131883384 rs750550082 |
67 | R>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1169456790 CA362266925 |
69 | A>V | No |
ClinGen gnomAD |
|
|
rs780623437 CA3572444 |
71 | W>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1297442648 CA362266950 |
71 | W>* | No |
ClinGen gnomAD |
|
|
rs1397748831 CA362267010 |
74 | K>E | No |
ClinGen gnomAD |
|
|
CA3572445 rs752064162 |
74 | K>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs752064162 CA362267015 |
74 | K>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA131883399 rs199787356 |
77 | R>C | No |
ClinGen ExAC gnomAD |
|
|
CA3572447 rs373687912 |
77 | R>H | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs199787356 CA3572446 |
77 | R>S | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 79 | R>L | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA131883405 rs756896801 |
79 | R>Q | No |
ClinGen TOPMed gnomAD |
|
|
rs765322594 CA3572448 |
79 | R>W | Variant assessed as Somatic; 0.0001427 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA gnomAD |
|
CA362267115 rs1561910913 |
80 | A>S | No |
ClinGen Ensembl |
|
|
rs982779454 CA131883409 |
80 | A>V | No |
ClinGen TOPMed |
|
|
rs1352978214 CA362267142 |
82 | Q>K | No |
ClinGen TOPMed |
|
|
CA3572449 rs367830438 |
82 | Q>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1581187065 CA362267160 |
83 | D>G | No |
ClinGen Ensembl |
|
|
rs1483840642 CA362267170 |
84 | N>Y | No |
ClinGen gnomAD |
|
|
CA3572450 rs777342115 |
85 | L>M | No |
ClinGen ExAC gnomAD |
|
|
CA362267192 rs1420205702 |
85 | L>Q | No |
ClinGen TOPMed |
|
|
CA3572452 rs770409222 |
86 | H>N | No |
ClinGen ExAC gnomAD |
|
|
CA362267205 rs770409222 |
86 | H>Y | No |
ClinGen ExAC gnomAD |
|
|
CA131883425 rs367869260 |
87 | L>V | No |
ClinGen Ensembl |
|
|
rs1189346100 CA362267229 |
88 | V>I | No |
ClinGen gnomAD |
|
|
CA362267256 rs1156603792 |
89 | T>I | No |
ClinGen TOPMed |
|
|
CA131883426 rs561940055 |
90 | K>N | No |
ClinGen 1000Genomes |
|
|
COSM3365992 rs1408455034 CA362267281 |
91 | V>M | kidney [Cosmic] | No |
ClinGen cosmic curated gnomAD |
|
CA3572453 rs773912010 |
92 | D>N | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 93 | T>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA3572455 rs772113105 |
94 | V>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA362267367 rs1382029630 |
95 | E>K | No |
ClinGen gnomAD |
|
|
CA3572458 rs765558809 |
96 | D>H | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 97 | F>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA362267498 rs750551455 |
99 | A>E | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
rs750551455 CA3572459 |
99 | A>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs980489223 CA131884139 |
100 | L>I | No |
ClinGen TOPMed gnomAD |
|
|
rs1428374253 CA362267714 |
101 | Y>C | No |
ClinGen gnomAD |
|
|
CA362267749 rs1472838264 |
102 | S>N | No |
ClinGen gnomAD |
|
|
rs1161270162 CA362267765 |
103 | H>R | No |
ClinGen gnomAD |
|
|
rs1399585413 CA362267799 |
105 | Q>* | No |
ClinGen gnomAD |
|
|
CA362267850 rs1351215062 |
107 | A>V | No |
ClinGen gnomAD |
|
|
rs759570203 CA3572486 |
109 | K>R | No |
ClinGen ExAC gnomAD |
|
|
rs368584564 CA3572487 |
110 | L>F | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs752001341 CA131884158 |
110 | L>P | No |
ClinGen TOPMed |
|
|
rs1420028464 CA362267945 |
113 | G>S | No |
ClinGen TOPMed |
|
| TCGA novel | 115 | D>E | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA362268031 rs1349208093 COSM1731802 |
117 | A>T | liver NS [Cosmic] | No |
ClinGen cosmic curated TOPMed gnomAD |
|
rs756611934 CA362268046 |
118 | L>F | No |
ClinGen ExAC gnomAD |
|
|
rs756611934 CA3572489 |
118 | L>V | No |
ClinGen ExAC gnomAD |
|
|
CA131884859 rs867836421 |
121 | D>G | No |
ClinGen Ensembl |
|
|
rs1561911416 CA362268226 |
122 | G>A | No |
ClinGen Ensembl |
|
|
rs368333419 CA362268255 |
124 | Q>* | No |
ClinGen TOPMed gnomAD |
|
|
rs368333419 CA131884880 |
124 | Q>E | No |
ClinGen TOPMed gnomAD |
|
|
CA362268289 rs1182486166 |
125 | P>S | No |
ClinGen gnomAD |
|
|
rs578195752 CA131884884 |
126 | M>I | No |
ClinGen 1000Genomes |
|
|
CA362268334 rs1395419592 |
127 | W>C | No |
ClinGen TOPMed gnomAD |
|
|
CA3572508 rs761219911 |
128 | E>D | No |
ClinGen ExAC gnomAD |
|
|
CA362268395 rs764616658 |
130 | S>I | No |
ClinGen ExAC gnomAD |
|
|
CA3572509 rs764616658 |
130 | S>N | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 132 | N>D | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA3572511 rs576924607 |
134 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs879776215 CA131884937 |
134 | R>W | No |
ClinGen TOPMed gnomAD |
|
|
rs1333271712 CA362268470 |
135 | G>D | No |
ClinGen gnomAD |
|
|
CA362268495 rs1450516793 |
137 | R>C | No |
ClinGen gnomAD |
|
|
CA3572513 rs750156083 |
137 | R>H | No |
ClinGen ExAC gnomAD |
|
|
CA362268508 rs750156083 |
137 | R>L | No |
ClinGen ExAC gnomAD |
|
|
rs1229898905 CA362268537 |
139 | L>P | No |
ClinGen gnomAD |
|
|
CA362268535 rs1366153462 |
139 | L>V | No |
ClinGen gnomAD |
|
|
CA362268557 rs1581187757 |
140 | V>G | No |
ClinGen Ensembl |
|
|
rs1268141705 CA362268544 |
140 | V>I | No |
ClinGen gnomAD |
|
|
rs1268141705 CA362268546 |
140 | V>L | No |
ClinGen gnomAD |
|
|
rs1338494487 CA362268599 |
143 | A>T | No |
ClinGen gnomAD |
|
|
rs758116063 CA362268643 |
144 | K>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1203004622 CA362268649 |
145 | Q>E | No |
ClinGen TOPMed |
|
|
CA362268675 rs1264890847 |
146 | Q>* | No |
ClinGen TOPMed gnomAD |
|
|
rs867316543 CA131884984 |
147 | R>C | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA TOPMed gnomAD |
|
CA3572517 rs115365515 |
147 | R>H | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs867316543 CA362268697 |
147 | R>S | No |
ClinGen TOPMed gnomAD |
|
|
rs1298658023 CA362268724 |
148 | H>R | No |
ClinGen TOPMed |
|
|
rs1429857091 CA362268787 |
150 | E>D | No |
ClinGen gnomAD |
|
|
CA3572518 rs746491387 |
151 | L>V | No |
ClinGen ExAC gnomAD |
|
|
rs754894044 CA3572519 |
152 | D>H | No |
ClinGen ExAC gnomAD |
|
|
rs369337202 CA3572521 |
153 | R>Q | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA3572520 rs762675292 |
153 | R>W | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
CA362268872 rs1336091367 |
155 | W>C | No |
ClinGen gnomAD |
|
|
rs75547884 CA131885021 |
155 | W>G | No |
ClinGen Ensembl |
|
|
rs1385786428 CA362268914 |
157 | E>G | No |
ClinGen gnomAD |
|
|
CA3572522 rs201024089 |
158 | T>M | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs370738911 CA3572550 |
159 | L>Q | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs199835250 CA3572552 |
161 | C>Y | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs974918867 CA131885272 |
163 | I>F | No |
ClinGen gnomAD |
|
|
CA3572553 rs770398185 |
163 | I>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3572554 rs773730956 CA362269121 |
164 | G>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3572555 rs763370432 |
164 | G>V | No |
ClinGen ExAC gnomAD |
|
|
CA362269123 rs773730956 |
164 | G>W | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs766132677 CA3572556 |
165 | E>G | No |
ClinGen ExAC gnomAD |
|
|
rs1423729008 CA362269127 |
165 | E>Q | No |
ClinGen gnomAD |
|
|
rs1375393924 CA362269199 |
168 | E>* | No |
ClinGen gnomAD |
|
|
rs534960290 CA3572557 |
168 | E>D | No |
ClinGen ExAC |
|
|
CA362269223 rs1389609779 |
169 | E>K | No |
ClinGen gnomAD |
|
|
rs202006112 CA3572559 |
170 | H>P | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA3572558 rs759107650 |
170 | H>Y | No |
ClinGen ExAC gnomAD |
|
|
rs756099664 CA3572561 |
172 | R>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs756099664 CA131885299 COSM1205140 |
172 | R>G | large_intestine [Cosmic] | No |
ClinGen cosmic curated ExAC TOPMed gnomAD |
|
CA131885303 rs954932855 |
176 | G>E | No |
ClinGen Ensembl |
|
|
CA3572563 rs753638257 |
177 | A>S | No |
ClinGen ExAC gnomAD |
|
|
rs756991362 CA3572564 |
178 | V>I | No |
ClinGen ExAC gnomAD |
|
|
CA362269403 rs1250509685 |
179 | V>I | No |
ClinGen TOPMed gnomAD |
|
|
rs778668845 CA3572565 |
182 | R>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1395285185 CA362269491 |
184 | K>T | No |
ClinGen TOPMed |
|
|
rs1404364899 CA362269508 |
185 | G>R | No |
ClinGen gnomAD |
|
|
CA3572569 rs201530441 |
186 | D>E | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA362269516 rs755120311 |
186 | D>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs755120311 CA3572568 |
186 | D>Y | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1036553652 CA131885360 |
187 | K>E | No |
ClinGen TOPMed |
|
|
CA362269562 rs1297537373 |
189 | A>D | No |
ClinGen gnomAD |
|
|
CA131885374 rs796378834 |
189 | A>T | No |
ClinGen Ensembl |
|
|
rs1406791263 CA362269565 |
190 | V>M | No |
ClinGen gnomAD |
|
|
CA131885390 rs994577136 |
191 | W>C | No |
ClinGen TOPMed |
|
|
rs937813392 CA131885379 |
191 | W>R | No |
ClinGen Ensembl |
|
|
rs1454100556 CA362269596 |
192 | T>M | No |
ClinGen gnomAD |
|
|
rs770455070 CA3572571 |
193 | R>G | No |
ClinGen ExAC gnomAD |
|
|
rs773788240 CA3572573 |
193 | R>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA362269601 rs1220821576 |
193 | R>T | No |
ClinGen TOPMed gnomAD |
|
|
CA362269633 rs1296660855 |
195 | A>V | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA TOPMed gnomAD |
|
CA362269679 rs1353665250 |
198 | Q>E | No |
ClinGen TOPMed |
|
|
rs368686706 CA3572575 |
199 | A>S | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs759283330 COSM3786926 CA3572576 |
199 | A>V | Variant assessed as Somatic; 0.0 impact. pancreas [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ExAC NCI-TCGA TOPMed gnomAD |
|
rs1048115730 COSM1436180 CA131885489 |
201 | V>M | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated NCI-TCGA TOPMed gnomAD |
|
CA3572580 rs116717121 |
204 | V>I | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA3572606 rs182336246 |
206 | R>C | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA3572607 rs369631741 |
206 | R>H | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen 1000Genomes ESP ExAC NCI-TCGA TOPMed gnomAD |
|
CA3572608 rs369631741 |
206 | R>L | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA362270465 rs1581188357 |
208 | Y>C | No |
ClinGen Ensembl |
|
|
rs752860930 CA131886008 |
211 | R>C | No |
ClinGen gnomAD |
|
|
CA3572609 rs756399527 |
211 | R>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3572612 rs757870734 |
213 | G>D | No |
ClinGen ExAC gnomAD |
|
|
CA3572611 rs753922679 |
213 | G>S | No |
ClinGen ExAC gnomAD |
|
|
rs757870734 CA362270527 |
213 | G>V | No |
ClinGen ExAC gnomAD |
|
|
rs779221982 CA3572613 |
218 | T>I | No |
ClinGen ExAC gnomAD |
|
|
CA3572614 rs746260963 |
220 | I>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs772381239 CA362270629 CA3572615 |
221 | G>R | No |
ClinGen ExAC gnomAD |
|
|
rs1405183279 CA362270650 |
222 | Y>F | No |
ClinGen gnomAD |
|
|
CA362270679 rs1581188400 |
224 | A>P | No |
ClinGen Ensembl |
|
|
rs780464331 CA3572616 |
224 | A>V | No |
ClinGen ExAC gnomAD |
|
|
CA362270697 rs1426925480 |
225 | H>P | No |
ClinGen gnomAD |
|
|
rs746706986 CA3572618 |
226 | A>E | No |
ClinGen ExAC gnomAD |
|
|
rs746706986 CA3572617 |
226 | A>V | No |
ClinGen ExAC gnomAD |
|
|
CA131886057 VAR_044209 rs13163938 |
227 | D>Y | No |
ClinGen UniProt Ensembl dbSNP |
|
| TCGA novel | 229 | A>S | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA362270749 rs1281293464 |
230 | T>I | No |
ClinGen gnomAD |
|
| TCGA novel | 231 | K>E | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA3572620 rs543131273 |
232 | S>G | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs761268817 CA3572621 |
238 | N>D | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA362270827 rs1361923332 |
238 | N>S | No |
ClinGen gnomAD |
|
|
rs1219914553 CA362270851 |
240 | F>Y | No |
ClinGen gnomAD |
|
|
rs13183830 CA131886078 |
242 | V>G | No |
ClinGen Ensembl |
|
|
CA362270868 rs1288916888 |
242 | V>M | No |
ClinGen TOPMed gnomAD |
|
|
rs1561912090 CA564461632 |
243 | V>L | No |
ClinGen Ensembl |
No associated diseases with A6NMX2
1 regional properties for A6NMX2
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| conserved_site | Eukaryotic translation initiation factor 4E (eIF-4E), conserved site | 115 - 138 | IPR019770 |
2 GO annotations of cellular component
| Name | Definition |
|---|---|
| eukaryotic translation initiation factor 4F complex | The eukaryotic translation initiation factor 4F complex is composed of eIF4E, eIF4A and eIF4G; it is involved in the recognition of the mRNA cap, ATP-dependent unwinding of the 5'-terminal secondary structure and recruitment of the mRNA to the ribosome. |
| mRNA cap binding complex | Any protein complex that binds to an mRNA cap at any time in the lifetime of the mRNA. |
2 GO annotations of molecular function
| Name | Definition |
|---|---|
| RNA 7-methylguanosine cap binding | Binding to a 7-methylguanosine group added cotranscriptionally to the 5' end of RNA molecules transcribed by polymerase II. |
| translation initiation factor activity | Functions in the initiation of ribosome-mediated translation of mRNA into a polypeptide. |
No GO annotations of biological process
| Name | Definition |
|---|---|
| No GO annotations for biological process |
9 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| Q03389 | Eukaryotic translation initiation factor isoform 4E-2 | Triticum aestivum (Wheat) | PR | |
| P07260 | CDC33 | Eukaryotic translation initiation factor 4E | Saccharomyces cerevisiae (strain ATCC 204508 / S288c) (Baker's yeast) | PR |
| Q8N5X7 | EIF4E3 | Eukaryotic translation initiation factor 4E type 3 | Homo sapiens (Human) | PR |
| O60573 | EIF4E2 | Eukaryotic translation initiation factor 4E type 2 | Homo sapiens (Human) | PR |
| P06730 | EIF4E | Eukaryotic translation initiation factor 4E | Homo sapiens (Human) | PR |
| O81482 | Eukaryotic translation initiation factor isoform 4E-2 | Zea mays (Maize) | PR | |
| P63073 | Eif4e | Eukaryotic translation initiation factor 4E | Mus musculus (Mouse) | PR |
| O61955 | ife-3 | Eukaryotic translation initiation factor 4E-3 | Caenorhabditis elegans | PR |
| Q9C7P6 | EIF4E3 | Eukaryotic translation initiation factor 4E-3 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MLAVEVSEAE | GGIREWEEEE | KEEEAAERTP | TGEKSPNSPR | TLLSLRGKAR | TGGPMEVKLE |
| 70 | 80 | 90 | 100 | 110 | 120 |
| LHPLQNRWAL | WFFKNDRSRA | WQDNLHLVTK | VDTVEDFWAL | YSHIQLASKL | SSGCDYALFK |
| 130 | 140 | 150 | 160 | 170 | 180 |
| DGIQPMWEDS | RNKRGGRWLV | SLAKQQRHIE | LDRLWLETLL | CLIGESFEEH | SREVCGAVVN |
| 190 | 200 | 210 | 220 | 230 | 240 |
| IRTKGDKIAV | WTREAENQAG | VLHVGRVYKE | RLGLSPKTII | GYQAHADTAT | KSNSLAKNKF |
| VV |