Q8N5X7
Gene name |
EIF4E3 |
Protein name |
Eukaryotic translation initiation factor 4E type 3 |
Names |
eIF-4E type 3, eIF-4E3, eIF4E type 3, eIF4E-3 |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:317649 |
EC number |
|
Protein Class |
|
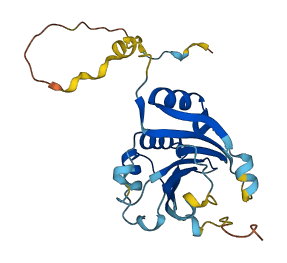
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for Q8N5X7
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-Q8N5X7-F1 | Predicted | AlphaFoldDB |
182 variants for Q8N5X7
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
CA353496092 rs1165573923 |
4 | P>L | No |
ClinGen TOPMed gnomAD |
|
|
CA76536599 rs929661051 |
4 | P>T | No |
ClinGen TOPMed |
|
|
rs1157022019 CA353496069 |
6 | A>V | No |
ClinGen TOPMed |
|
|
CA76536588 rs986281064 |
9 | P>A | No |
ClinGen TOPMed gnomAD |
|
|
CA353496034 rs1416527407 |
9 | P>L | No |
ClinGen TOPMed |
|
|
rs986281064 CA76536587 |
9 | P>S | No |
ClinGen TOPMed gnomAD |
|
|
rs1293901313 CA353496030 |
10 | P>A | No |
ClinGen TOPMed |
|
|
rs932219594 CA353496028 |
10 | P>H | No |
ClinGen TOPMed gnomAD |
|
|
CA353496026 rs932219594 |
10 | P>L | No |
ClinGen TOPMed gnomAD |
|
|
CA76536586 rs932219594 |
10 | P>R | No |
ClinGen TOPMed gnomAD |
|
|
CA76536582 rs978725974 |
11 | A>P | No |
ClinGen TOPMed |
|
|
rs1262228075 CA353496006 |
12 | G>A | No |
ClinGen TOPMed gnomAD |
|
|
CA353495993 rs967310001 |
14 | R>G | No |
ClinGen TOPMed |
|
|
rs866427044 CA76536573 |
14 | R>L | No |
ClinGen TOPMed |
|
|
CA76536578 rs967310001 |
14 | R>W | No |
ClinGen TOPMed |
|
|
CA76536551 rs553499559 |
15 | E>D | No |
ClinGen 1000Genomes |
|
|
CA353495968 rs1484707428 |
16 | P>A | No |
ClinGen TOPMed gnomAD |
|
|
CA353495960 rs1469450318 |
16 | P>L | No |
ClinGen TOPMed |
|
|
CA353495953 rs1407123751 |
17 | P>L | No |
ClinGen TOPMed |
|
|
rs1407123751 CA353495955 |
17 | P>Q | No |
ClinGen TOPMed |
|
|
rs1436397903 CA353495946 |
18 | G>W | No |
ClinGen TOPMed |
|
|
CA353495924 rs1232072975 |
20 | R>C | No |
ClinGen TOPMed |
|
|
CA353495927 rs1232072975 |
20 | R>S | No |
ClinGen TOPMed |
|
|
CA76536550 rs992895762 |
22 | A>S | No |
ClinGen TOPMed gnomAD |
|
|
rs992895762 CA353495902 |
22 | A>T | No |
ClinGen TOPMed gnomAD |
|
|
rs1281532003 CA353495893 |
23 | A>T | No |
ClinGen TOPMed |
|
|
CA76536548 rs960416255 |
25 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
rs1288082957 CA353495858 |
26 | A>T | No |
ClinGen gnomAD |
|
|
CA353495850 rs1353724603 |
27 | A>T | No |
ClinGen TOPMed |
|
|
rs1001398387 CA76536545 |
27 | A>V | No |
ClinGen TOPMed |
|
|
CA353495828 rs1372671165 |
30 | P>Q | No |
ClinGen TOPMed |
|
|
CA353495817 rs1578376951 |
32 | L>F | No |
ClinGen Ensembl |
|
|
rs1417142729 CA353495811 |
33 | G>C | No |
ClinGen Ensembl |
|
|
rs1417142729 CA353495812 |
33 | G>R | No |
ClinGen Ensembl |
|
|
CA353495776 rs1385274093 |
38 | S>L | No |
ClinGen gnomAD |
|
|
CA76536533 rs896785084 |
40 | L>R | No |
ClinGen TOPMed |
|
|
rs994089559 CA76536535 |
40 | L>V | No |
ClinGen TOPMed |
|
|
CA353495762 rs1453577175 |
41 | Q>R | No |
ClinGen gnomAD |
|
|
rs1359127336 CA353495751 |
43 | E>Q | No |
ClinGen gnomAD |
|
|
CA76536531 rs867490944 |
44 | P>Q | No |
ClinGen TOPMed |
|
|
rs867490944 CA353495740 |
44 | P>R | No |
ClinGen TOPMed |
|
|
CA353495737 rs1194570650 |
45 | G>S | No |
ClinGen TOPMed |
|
|
CA76536523 rs943780445 |
50 | H>R | No |
ClinGen TOPMed |
|
|
rs1460883421 CA353495702 |
51 | S>P | No |
ClinGen TOPMed |
|
|
CA76536519 rs889559148 |
51 | S>W | No |
ClinGen TOPMed gnomAD |
|
|
rs1171257332 CA353495653 |
58 | D>H | No |
ClinGen TOPMed gnomAD |
|
|
rs1361657691 CA353495646 |
59 | R>* | No |
ClinGen TOPMed |
|
|
CA353495642 rs1213226449 |
59 | R>I | No |
ClinGen TOPMed |
|
|
CA353494933 rs1300479907 |
60 | S>F | No |
ClinGen gnomAD |
|
|
CA353494937 rs1308871766 |
60 | S>T | No |
ClinGen TOPMed |
|
|
CA353494921 rs1375435312 |
62 | P>L | No |
ClinGen gnomAD |
|
|
CA2491763 rs779891581 |
63 | G>D | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA gnomAD |
|
rs1046318123 CA76528199 |
65 | T>A | No |
ClinGen TOPMed gnomAD |
|
|
rs1467617060 CA353494892 |
68 | E>K | No |
ClinGen TOPMed gnomAD |
|
|
CA353494881 rs1377784052 |
69 | C>Y | No |
ClinGen TOPMed gnomAD |
|
|
rs201768696 CA76528183 |
70 | A>T | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA2491761 rs751819819 |
70 | A>V | No |
ClinGen ExAC gnomAD |
|
|
CA76528176 rs535559537 |
72 | N>T | No |
ClinGen 1000Genomes |
|
|
CA353494832 rs1194174480 |
76 | I>M | No |
ClinGen gnomAD |
|
| TCGA novel | 76 | I>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1485295407 CA353494827 |
77 | Y>C | No |
ClinGen gnomAD |
|
| TCGA novel | 77 | Y>D | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA353494804 rs1459635103 CA353494805 |
80 | Q>H | No |
ClinGen TOPMed |
|
|
rs1255394725 CA353494807 |
80 | Q>R | No |
ClinGen TOPMed gnomAD |
|
|
CA76528172 rs368266310 |
81 | T>I | No |
ClinGen ESP TOPMed |
|
|
CA76528169 rs921231866 |
82 | V>I | No |
ClinGen Ensembl |
|
|
rs1460695368 CA353493988 |
85 | F>L | No |
ClinGen gnomAD |
|
|
CA353493897 rs1267503233 |
90 | N>D | No |
ClinGen TOPMed |
|
|
rs1311597858 CA353493891 |
90 | N>S | No |
ClinGen gnomAD |
|
|
CA2491738 rs758594727 |
93 | P>T | No |
ClinGen ExAC gnomAD |
|
|
rs1178027331 CA353493844 |
94 | P>S | No |
ClinGen TOPMed gnomAD |
|
|
CA353493829 rs1559595300 |
95 | V>A | No |
ClinGen Ensembl |
|
|
CA2491735 rs760057716 |
95 | V>L | No |
ClinGen ExAC gnomAD |
|
|
rs1415471713 CA353493823 |
96 | T>S | No |
ClinGen TOPMed |
|
|
rs1559595291 CA353493825 |
96 | T>S | No |
ClinGen Ensembl |
|
|
CA2491734 rs754412529 |
97 | S>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA2491733 rs766803125 |
97 | S>R | No |
ClinGen ExAC gnomAD |
|
|
CA2491730 rs767176745 |
105 | H>Q | No |
ClinGen ExAC gnomAD |
|
|
rs143818539 CA2491729 |
107 | M>V | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
| TCGA novel | 111 | R>A | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
COSM1425258 CA2491728 rs149437626 COSM1425257 |
112 | R>* | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ESP ExAC NCI-TCGA gnomAD |
|
rs1439683580 CA353493613 |
112 | R>Q | No |
ClinGen TOPMed gnomAD |
|
|
CA2491727 rs768167456 |
113 | P>L | No |
ClinGen ExAC gnomAD |
|
|
rs762417927 CA2491709 |
118 | E>K | No |
ClinGen ExAC gnomAD |
|
|
CA2491707 rs769755377 |
119 | S>T | No |
ClinGen ExAC gnomAD |
|
|
CA2491706 rs552037155 |
120 | N>D | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs1264542674 CA353492431 |
120 | N>K | No |
ClinGen gnomAD |
|
|
CA353492423 rs1303296676 |
122 | K>E | No |
ClinGen TOPMed |
|
|
rs1208748932 CA353492414 |
123 | G>C | No |
ClinGen gnomAD |
|
|
CA2491704 COSM1425256 COSM1425255 rs770648457 |
125 | V>I | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ExAC NCI-TCGA gnomAD |
| TCGA novel | 126 | W>L | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA2491703 rs748334973 |
127 | K>N | No |
ClinGen ExAC |
|
|
CA353492378 rs755292451 CA2491701 |
128 | M>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA2491702 rs779312149 |
128 | M>V | No |
ClinGen ExAC gnomAD |
|
|
CA2491700 rs749358048 |
129 | K>Q | No |
ClinGen ExAC gnomAD |
|
|
CA353492365 rs1340973645 |
130 | V>D | No |
ClinGen gnomAD |
|
|
rs756639426 CA76519974 |
131 | P>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA2491698 rs756639426 |
131 | P>R | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 132 | K>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA2491697 rs750907767 |
132 | K>R | No |
ClinGen ExAC gnomAD |
|
|
rs1415245274 CA353492350 |
133 | D>N | No |
ClinGen gnomAD |
|
|
rs757593083 CA2491695 |
134 | S>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA2491696 rs757593083 |
134 | S>G | No |
ClinGen ExAC TOPMed gnomAD |
|
| rs530682446 | 135 | T>= | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA2491694 rs751958629 |
135 | T>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA76518291 rs868739510 |
136 | S>F | No |
ClinGen Ensembl |
|
|
rs371755881 CA2491668 |
136 | S>T | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1313262761 CA353491852 |
138 | V>I | No |
ClinGen gnomAD |
|
|
rs369981173 CA2491665 |
139 | W>* | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA2491666 rs773137821 |
139 | W>* | No |
ClinGen ExAC gnomAD |
|
|
rs773137821 CA2491667 |
139 | W>S | No |
ClinGen ExAC gnomAD |
|
|
CA353491806 rs1352064995 |
140 | K>R | No |
ClinGen TOPMed gnomAD |
|
|
CA353491807 rs1352064995 |
140 | K>T | No |
ClinGen TOPMed gnomAD |
|
|
rs763217075 CA2491664 |
141 | E>D | No |
ClinGen ExAC gnomAD |
|
|
CA353491756 rs1001950395 |
142 | L>F | No |
ClinGen TOPMed gnomAD |
|
|
CA2491663 rs376785193 |
145 | A>T | No |
ClinGen ESP ExAC gnomAD |
|
|
rs770093039 CA76518250 |
146 | T>A | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
rs770093039 CA2491662 |
146 | T>P | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA353491680 rs1189189187 |
146 | T>S | No |
ClinGen gnomAD |
|
|
CA2491661 rs564940815 |
147 | I>T | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA353491670 rs1489355694 |
147 | I>V | No |
ClinGen TOPMed gnomAD |
|
|
CA2491659 rs543372855 |
148 | G>R | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA76518246 rs906175812 |
149 | E>* | No |
ClinGen gnomAD |
|
|
CA353491588 rs1242487181 |
150 | Q>H | No |
ClinGen gnomAD |
|
|
rs1278156384 CA353491497 |
154 | C>R | No |
ClinGen TOPMed |
|
|
rs747514588 CA2491658 |
155 | A>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs866131789 CA76518241 |
155 | A>V | No |
ClinGen gnomAD |
|
|
rs562733184 CA2491657 |
156 | A>T | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 159 | D>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1235275719 CA353490501 |
163 | G>R | No |
ClinGen TOPMed |
|
|
rs1309952742 CA353490468 |
164 | V>D | No |
ClinGen gnomAD |
|
|
CA2491627 rs748975219 |
165 | S>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA353490439 rs1382990894 |
165 | S>R | No |
ClinGen TOPMed gnomAD |
|
|
rs1207029516 CA353490432 |
166 | V>F | No |
ClinGen TOPMed |
|
|
CA353490418 rs1249685643 |
167 | S>G | No |
ClinGen TOPMed |
|
|
rs1330291248 CA353490386 |
168 | V>I | No |
ClinGen gnomAD |
|
|
rs145879433 CA353490360 |
169 | R>G | No |
ClinGen ESP TOPMed gnomAD |
|
|
CA353490353 rs1164880439 |
169 | R>Q | No |
ClinGen TOPMed gnomAD |
|
|
rs145879433 CA76516253 |
169 | R>W | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ESP NCI-TCGA TOPMed gnomAD |
|
CA353490324 rs1473730443 |
170 | D>E | No |
ClinGen TOPMed |
|
|
rs199804601 CA2491626 |
170 | D>Y | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA353490317 rs1165101955 |
171 | R>G | No |
ClinGen TOPMed |
|
|
rs564748464 CA76516246 |
171 | R>Q | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA353490308 rs1474427228 |
172 | E>K | No |
ClinGen gnomAD |
|
|
rs1366712780 CA353490267 |
174 | V>I | No |
ClinGen gnomAD |
|
|
CA353490253 rs749992800 |
175 | V>F | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs749992800 CA2491624 |
175 | V>I | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 175 | V>missing | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA2491623 rs767537876 |
178 | W>C | No |
ClinGen ExAC gnomAD |
|
|
rs1553660003 CA2491620 |
181 | N>K | No |
ClinGen Ensembl |
|
|
CA353490204 rs1178228784 |
181 | N>T | No |
ClinGen gnomAD |
|
|
rs1387639898 CA353490190 |
182 | A>P | No |
ClinGen TOPMed |
|
|
rs1240401437 CA353490161 |
184 | L>S | No |
ClinGen gnomAD |
|
|
CA76516202 rs975581533 |
186 | G>D | No |
ClinGen TOPMed gnomAD |
|
|
CA353490136 rs1196813167 |
186 | G>R | No |
ClinGen TOPMed gnomAD |
|
|
rs1196813167 CA353490134 |
186 | G>S | No |
ClinGen TOPMed gnomAD |
|
|
rs1339292058 CA353490097 |
188 | A>V | No |
ClinGen TOPMed |
|
|
rs1264216684 CA353490075 |
190 | V>A | No |
ClinGen gnomAD |
|
|
rs1359570883 CA353490009 |
194 | I>M | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA gnomAD |
|
rs1294031426 CA353489989 |
196 | E>K | No |
ClinGen TOPMed |
|
|
rs1022877113 CA353489970 |
197 | L>F | No |
ClinGen TOPMed gnomAD |
|
|
rs1022877113 CA76516200 |
197 | L>V | No |
ClinGen TOPMed gnomAD |
|
|
rs1378726030 CA353489948 |
198 | L>R | No |
ClinGen gnomAD |
|
|
rs776930576 CA2491615 |
200 | H>Q | No |
ClinGen ExAC gnomAD |
|
|
rs759614882 CA2491616 |
200 | H>Y | No |
ClinGen ExAC gnomAD |
|
|
rs1385918519 CA353489909 |
201 | I>K | No |
ClinGen gnomAD |
|
|
rs766410412 CA2491614 |
201 | I>V | No |
ClinGen ExAC gnomAD |
|
|
CA353489843 rs1438064359 |
206 | V>L | No |
ClinGen gnomAD |
|
|
CA2491612 rs773332075 |
208 | Y>C | No |
ClinGen ExAC gnomAD |
|
|
rs1559589858 CA353489818 |
209 | K>T | No |
ClinGen Ensembl |
|
|
rs1182908669 CA353489813 |
210 | P>A | No |
ClinGen gnomAD |
|
|
rs1448260347 CA353489066 |
211 | H>D | No |
ClinGen gnomAD |
|
|
CA76513566 rs147569869 |
211 | H>R | No |
ClinGen ESP |
|
|
rs1448260347 CA353489065 |
211 | H>Y | No |
ClinGen gnomAD |
|
|
rs1199509279 CA353489043 |
212 | E>A | No |
ClinGen gnomAD |
|
|
rs1334821716 CA353489014 |
214 | H>D | No |
ClinGen TOPMed |
|
|
rs866136283 CA76513559 |
218 | E>K | No |
ClinGen Ensembl |
|
|
rs1342512281 CA353488955 |
219 | G>S | No |
ClinGen gnomAD |
|
|
CA353488945 rs1385150083 |
220 | G>A | No |
ClinGen TOPMed |
|
|
rs752533191 CA2491593 |
221 | R>C | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
rs760948130 CA2491592 |
221 | R>H | No |
ClinGen ExAC gnomAD |
|
|
rs760948130 COSM584580 CA2491591 |
221 | R>L | lung Variant assessed as Somatic; 0.0 impact. [Cosmic, NCI-TCGA] | No |
ClinGen cosmic curated ExAC NCI-TCGA gnomAD |
No associated diseases with Q8N5X7
No regional properties for Q8N5X7
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| No domain, repeats, and functional sites for Q8N5X7 | |||
3 GO annotations of cellular component
| Name | Definition |
|---|---|
| cytosol | The part of the cytoplasm that does not contain organelles but which does contain other particulate matter, such as protein complexes. |
| eukaryotic translation initiation factor 4F complex | The eukaryotic translation initiation factor 4F complex is composed of eIF4E, eIF4A and eIF4G; it is involved in the recognition of the mRNA cap, ATP-dependent unwinding of the 5'-terminal secondary structure and recruitment of the mRNA to the ribosome. |
| mRNA cap binding complex | Any protein complex that binds to an mRNA cap at any time in the lifetime of the mRNA. |
2 GO annotations of molecular function
| Name | Definition |
|---|---|
| RNA 7-methylguanosine cap binding | Binding to a 7-methylguanosine group added cotranscriptionally to the 5' end of RNA molecules transcribed by polymerase II. |
| translation initiation factor activity | Functions in the initiation of ribosome-mediated translation of mRNA into a polypeptide. |
No GO annotations of biological process
| Name | Definition |
|---|---|
| No GO annotations for biological process |
7 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| A3RCV9 | NCBP | Eukaryotic translation initiation factor NCBP | Triticum aestivum (Wheat) | PR |
| O60573 | EIF4E2 | Eukaryotic translation initiation factor 4E type 2 | Homo sapiens (Human) | PR |
| A6NMX2 | EIF4E1B | Eukaryotic translation initiation factor 4E type 1B | Homo sapiens (Human) | PR |
| P06730 | EIF4E | Eukaryotic translation initiation factor 4E | Homo sapiens (Human) | PR |
| Q10NQ9 | NCBP | Eukaryotic translation initiation factor NCBP | Oryza sativa subsp japonica (Rice) | PR |
| Q28ET8 | eif4e3 | Eukaryotic translation initiation factor 4E type 3 | Xenopus tropicalis (Western clawed frog) (Silurana tropicalis) | PR |
| Q66HY7 | eif4e3 | Eukaryotic translation initiation factor 4E type 3 | Danio rerio (Zebrafish) (Brachydanio rerio) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MALPPAAAPP | AGAREPPGSR | AAAAAAAPEP | PLGLQQLSAL | QPEPGGVPLH | SSWTFWLDRS |
| 70 | 80 | 90 | 100 | 110 | 120 |
| LPGATAAECA | SNLKKIYTVQ | TVQIFWSVYN | NIPPVTSLPL | RCSYHLMRGE | RRPLWEEESN |
| 130 | 140 | 150 | 160 | 170 | 180 |
| AKGGVWKMKV | PKDSTSTVWK | ELLLATIGEQ | FTDCAAADDE | VIGVSVSVRD | REDVVQVWNV |
| 190 | 200 | 210 | 220 | ||
| NASLVGEATV | LEKIYELLPH | ITFKAVFYKP | HEEHHAFEGG | RGKH |