Q8IZP1
Gene name |
TBC1D3 (PRC17, TBC1D3A) |
Protein name |
TBC1 domain family member 3 |
Names |
Prostate cancer gene 17 protein, Protein TRE17-alpha, Rab GTPase-activating protein PRC17 |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:729873 |
EC number |
|
Protein Class |
|
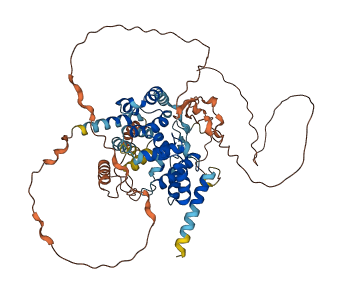
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for Q8IZP1
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-Q8IZP1-F1 | Predicted | AlphaFoldDB |
170 variants for Q8IZP1
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
rs1404463730 CA398775059 |
7 | A>T | No |
ClinGen gnomAD |
|
|
CA398774882 rs1240014374 |
29 | G>V | No |
ClinGen Ensembl |
|
|
CA398774825 rs1555551619 |
38 | P>A | No |
ClinGen Ensembl |
|
|
rs1555551618 CA398774761 |
47 | D>N | No |
ClinGen Ensembl |
|
|
rs1189861388 CA398774750 |
48 | H>R | No |
ClinGen gnomAD |
|
|
rs1477756907 CA398774641 |
63 | R>Q | No |
ClinGen gnomAD |
|
|
rs1555551589 CA398774642 |
63 | R>W | No |
ClinGen Ensembl |
|
|
rs1555551588 CA398774625 |
65 | A>V | No |
ClinGen Ensembl |
|
|
rs1555551574 CA398774555 |
74 | R>* | No |
ClinGen Ensembl |
|
|
rs1379891827 CA398774478 |
84 | D>E | No |
ClinGen gnomAD |
|
|
rs1237641505 CA398774369 |
97 | R>Q | No |
ClinGen gnomAD |
|
|
rs1397272498 CA398774295 |
107 | R>Q | No |
ClinGen gnomAD |
|
|
rs1336912298 CA398774298 |
107 | R>W | No |
ClinGen gnomAD |
|
|
CA398774291 rs1399361262 |
108 | G>D | No |
ClinGen Ensembl |
|
|
CA398774283 rs1399425598 |
109 | P>L | No |
ClinGen gnomAD |
|
|
CA398774247 rs1301659483 |
114 | L>H | No |
ClinGen gnomAD |
|
|
CA398774228 rs1567682697 |
117 | T>I | No |
ClinGen Ensembl |
|
|
CA398774189 rs1598931276 |
122 | L>F | No |
ClinGen Ensembl |
|
|
rs1555551557 CA398774191 |
122 | L>W | No |
ClinGen Ensembl |
|
|
rs1160846265 CA398774145 |
129 | Q>K | No |
ClinGen gnomAD |
|
|
CA398774069 rs1349057727 |
137 | R>K | No |
ClinGen Ensembl |
|
|
CA398774023 rs1425697727 |
143 | Q>H | No |
ClinGen gnomAD |
|
|
rs1254141043 CA398774021 |
144 | R>C | No |
ClinGen gnomAD |
|
|
rs1199838317 CA398774018 |
144 | R>H | No |
ClinGen gnomAD |
|
|
rs1199838317 CA398774016 |
144 | R>L | No |
ClinGen gnomAD |
|
|
rs1488592133 CA398774008 |
146 | D>N | No |
ClinGen gnomAD |
|
|
CA398773996 rs1288012542 |
147 | R>L | No |
ClinGen gnomAD |
|
|
CA398773998 rs1288012542 |
147 | R>Q | No |
ClinGen gnomAD |
|
|
CA398773999 rs1555551542 |
147 | R>W | No |
ClinGen Ensembl |
|
|
rs1247314319 CA398773987 |
149 | V>I | No |
ClinGen gnomAD |
|
|
rs1352626489 CA398773971 |
151 | G>R | No |
ClinGen gnomAD |
|
|
CA398773915 rs1338234763 |
159 | F>I | No |
ClinGen gnomAD |
|
|
CA398773840 rs1201295114 |
168 | R>W | No |
ClinGen TOPMed gnomAD |
|
|
CA398773820 rs1445425810 |
171 | L>F | No |
ClinGen gnomAD |
|
|
rs1262284602 CA398773814 |
172 | H>Y | No |
ClinGen gnomAD |
|
|
CA398773807 rs1260960835 |
173 | I>V | No |
ClinGen TOPMed |
|
|
CA398773787 rs1355822089 |
176 | A>E | No |
ClinGen gnomAD |
|
|
rs1278148202 CA398773780 |
177 | Y>C | No |
ClinGen gnomAD |
|
|
CA398773774 rs1218527819 |
178 | E>* | No |
ClinGen gnomAD |
|
|
CA398773771 rs1345131113 |
178 | E>A | No |
ClinGen gnomAD |
|
|
rs1276041886 CA398773760 |
180 | Y>N | No |
ClinGen gnomAD |
|
|
CA398773739 rs1339430478 |
182 | P>L | No |
ClinGen TOPMed gnomAD |
|
|
rs1339430478 CA398773741 |
182 | P>Q | No |
ClinGen TOPMed gnomAD |
|
|
CA398773696 rs1450054717 |
187 | C>G | No |
ClinGen TOPMed |
|
|
CA398773660 rs1264438414 |
192 | H>Y | No |
ClinGen gnomAD |
|
|
CA398773647 rs1199011684 |
194 | A>T | No |
ClinGen TOPMed |
|
|
CA398773605 rs1480648980 |
200 | Y>C | No |
ClinGen TOPMed |
|
|
CA398773598 rs1178419593 |
201 | L>F | No |
ClinGen TOPMed |
|
|
CA398773580 rs1555551425 |
204 | E>K | No |
ClinGen Ensembl |
|
|
CA398773376 rs1555551408 |
232 | V>I | No |
ClinGen Ensembl |
|
|
rs1555551407 CA398773360 |
234 | G>W | No |
ClinGen Ensembl |
|
|
CA398773299 rs1555551405 |
242 | V>E | No |
ClinGen Ensembl |
|
|
rs1442932402 CA398773086 |
271 | R>Q | No |
ClinGen gnomAD |
|
|
CA398773087 rs1209342478 |
271 | R>W | No |
ClinGen gnomAD |
|
|
rs1555551393 CA398773053 |
276 | G>R | No |
ClinGen Ensembl |
|
|
CA398773025 rs1360235271 |
278 | S>C | No |
ClinGen gnomAD |
|
|
CA398773024 rs1360235271 |
278 | S>F | No |
ClinGen gnomAD |
|
|
rs1336295071 CA398773022 |
279 | L>V | No |
ClinGen gnomAD |
|
|
rs1598930587 CA398773017 |
280 | G>R | No |
ClinGen Ensembl |
|
|
rs1171674550 CA398773009 |
281 | L>F | No |
ClinGen gnomAD |
|
|
rs1478888982 CA398773008 |
281 | L>H | No |
ClinGen gnomAD |
|
|
rs1171674550 CA398773010 |
281 | L>V | No |
ClinGen gnomAD |
|
|
rs1473114318 CA398772992 |
284 | R>C | No |
ClinGen gnomAD |
|
|
rs1239098108 CA398772991 |
284 | R>H | No |
ClinGen gnomAD |
|
|
rs1473114318 CA398772994 |
284 | R>S | No |
ClinGen gnomAD |
|
|
rs1258076635 CA398772977 |
286 | W>* | No |
ClinGen gnomAD |
|
|
rs1228082728 CA398772963 |
288 | V>A | No |
ClinGen gnomAD |
|
|
rs764562204 CA398772965 |
288 | V>L | No |
ClinGen ExAC gnomAD |
|
|
CA290268646 rs764562204 |
288 | V>M | No |
ClinGen ExAC gnomAD |
|
|
rs1388863846 CA398772954 |
289 | Y>* | No |
ClinGen gnomAD |
|
|
rs1162819175 CA398772950 |
290 | L>P | No |
ClinGen gnomAD |
|
|
rs1425853885 CA398772930 |
293 | G>D | No |
ClinGen gnomAD |
|
|
CA398772933 rs1286492327 |
293 | G>R | No |
ClinGen gnomAD |
|
|
CA290268641 rs762506156 |
294 | E>K | No |
ClinGen ExAC gnomAD |
|
|
rs762506156 CA398772928 |
294 | E>Q | No |
ClinGen ExAC gnomAD |
|
|
CA398772919 rs1467433694 |
295 | Q>* | No |
ClinGen gnomAD |
|
|
CA398772920 rs1467433694 |
295 | Q>E | No |
ClinGen gnomAD |
|
|
rs1348339886 CA398772917 |
295 | Q>R | No |
ClinGen gnomAD |
|
|
rs1247164727 CA398772913 |
296 | A>T | No |
ClinGen gnomAD |
|
|
rs752196308 CA290268634 |
296 | A>V | No |
ClinGen ExAC gnomAD |
|
|
CA398772908 rs764871158 |
297 | L>V | No |
ClinGen ExAC gnomAD |
|
|
rs1176715124 CA398772891 |
299 | P>A | No |
ClinGen gnomAD |
|
|
rs1438935055 CA398772887 |
299 | P>L | No |
ClinGen gnomAD |
|
|
rs1176715124 CA398772892 |
299 | P>S | No |
ClinGen gnomAD |
|
|
rs1179953319 CA398772881 |
300 | I>R | No |
ClinGen gnomAD |
|
|
rs1487327884 CA398772875 |
301 | T>I | No |
ClinGen gnomAD |
|
|
rs1322713781 CA398772864 |
303 | I>T | No |
ClinGen gnomAD |
|
|
rs570001833 CA290268628 |
303 | I>V | No |
ClinGen 1000Genomes gnomAD |
|
|
CA290268625 rs759166359 |
304 | A>T | No |
ClinGen ExAC gnomAD |
|
|
CA398772839 rs1310140228 |
307 | V>I | No |
ClinGen gnomAD |
|
|
rs764674344 CA290268483 |
310 | K>R | No |
ClinGen ExAC gnomAD |
|
|
CA398772802 rs764674344 |
310 | K>T | No |
ClinGen ExAC gnomAD |
|
|
rs759138166 CA290268480 |
311 | R>C | No |
ClinGen ExAC gnomAD |
|
|
rs753580401 CA290268473 |
311 | R>H | No |
ClinGen ExAC gnomAD |
|
|
CA290268465 rs765938439 |
313 | T>A | No |
ClinGen ExAC gnomAD |
|
|
CA290268461 rs760588777 |
313 | T>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs760588777 CA398772785 |
313 | T>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1195762221 CA398772777 |
314 | K>N | No |
ClinGen gnomAD |
|
|
rs772151485 CA290268458 |
315 | T>M | No |
ClinGen ExAC gnomAD |
|
|
rs769957741 CA290268455 |
316 | S>F | No |
ClinGen ExAC gnomAD |
|
|
rs775743264 CA290268456 |
316 | S>P | No |
ClinGen ExAC gnomAD |
|
|
CA290268449 rs776969274 |
317 | R>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA290268451 rs745912936 |
317 | R>T | No |
ClinGen ExAC gnomAD |
|
|
rs1555551340 CA398772766 |
317 | R>W | No |
ClinGen Ensembl |
|
|
rs527878050 CA290268448 |
318 | C>* | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA290268446 rs778051729 |
320 | P>L | No |
ClinGen ExAC gnomAD |
|
|
CA290268429 rs779358161 |
321 | W>L | No |
ClinGen ExAC gnomAD |
|
|
CA290268420 rs779358161 |
321 | W>S | No |
ClinGen ExAC gnomAD |
|
|
CA290268417 rs754578525 |
322 | A>P | No |
ClinGen ExAC gnomAD |
|
|
CA290268408 rs766062340 |
323 | R>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA398772732 rs766062340 |
323 | R>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA290268404 rs755667705 |
323 | R>H | No |
ClinGen ExAC gnomAD |
|
|
rs766062340 CA290268412 |
323 | R>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA290268385 rs767382380 |
325 | C>W | No |
ClinGen ExAC gnomAD |
|
|
CA398772704 rs774479210 |
327 | R>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA290268366 rs774479210 |
327 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs761669246 CA290268370 |
327 | R>W | No |
ClinGen ExAC gnomAD |
|
|
rs776505607 CA290268349 |
329 | V>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs776505607 CA290268345 |
329 | V>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs771194834 CA290268337 |
331 | T>A | No |
ClinGen ExAC gnomAD |
|
|
CA398772679 rs1236498395 |
331 | T>I | No |
ClinGen gnomAD |
|
|
CA398772681 rs1236498395 |
331 | T>N | No |
ClinGen gnomAD |
|
|
CA290268334 rs747182589 |
332 | W>* | No |
ClinGen ExAC gnomAD |
|
|
rs1458415520 CA398772667 |
333 | A>D | No |
ClinGen gnomAD |
|
|
CA290268330 rs568662214 |
334 | R>G | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA290268329 rs772462211 |
335 | D>V | No |
ClinGen ExAC gnomAD |
|
|
rs748503461 CA398772645 CA290268328 |
336 | E>D | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs779466352 CA290268323 |
339 | V>A | No |
ClinGen ExAC gnomAD |
|
|
CA290268303 rs748846507 |
341 | K>R | No |
ClinGen ExAC gnomAD |
|
|
rs1321197272 CA398772608 |
342 | H>R | No |
ClinGen gnomAD |
|
|
CA398772610 rs1336970867 |
342 | H>Y | No |
ClinGen gnomAD |
|
|
rs1390552664 CA398772597 |
344 | R>W | No |
ClinGen gnomAD |
|
|
rs1164594749 CA398772588 |
345 | A>D | No |
ClinGen gnomAD |
|
|
CA398772585 rs1555551328 |
346 | S>A | No |
ClinGen Ensembl |
|
|
CA398772581 rs1378975538 |
346 | S>C | No |
ClinGen TOPMed gnomAD |
|
|
rs1378975538 CA398772580 |
346 | S>F | No |
ClinGen TOPMed gnomAD |
|
|
rs1440423901 CA398772579 |
347 | M>V | No |
ClinGen TOPMed gnomAD |
|
|
CA398772564 rs1472873745 |
348 | K>N | No |
ClinGen TOPMed gnomAD |
|
|
CA398772566 rs1161706015 |
348 | K>R | No |
ClinGen TOPMed |
|
|
CA398772555 rs1234616615 |
349 | K>N | No |
ClinGen gnomAD |
|
|
CA398772545 rs1197032969 |
351 | T>R | No |
ClinGen gnomAD |
|
|
rs1469695625 CA398772549 |
351 | T>S | No |
ClinGen TOPMed |
|
|
rs1337975026 CA398772522 |
354 | K>N | No |
ClinGen TOPMed |
|
|
rs373252714 CA290268292 |
354 | K>Q | No |
ClinGen ExAC gnomAD |
|
|
rs1487288747 CA398772520 |
355 | G>R | No |
ClinGen gnomAD |
|
|
CA398772510 rs1240720413 |
356 | D>E | No |
ClinGen TOPMed gnomAD |
|
|
rs767257618 CA290268290 |
356 | D>G | No |
ClinGen ExAC |
|
|
rs750141831 CA290268291 |
356 | D>Y | No |
ClinGen ExAC |
|
|
rs62073819 CA290268289 |
357 | L>M | No |
ClinGen ExAC gnomAD |
|
|
rs62073819 CA290268288 |
357 | L>V | No |
ClinGen ExAC gnomAD |
|
|
rs370901010 CA398772503 |
358 | P>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA290268280 rs370901010 |
358 | P>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA290268285 rs764096233 |
358 | P>S | No |
ClinGen ExAC gnomAD |
|
|
CA398772494 rs1304178599 |
360 | P>A | No |
ClinGen gnomAD |
|
|
rs1407179562 CA398772491 |
360 | P>L | No |
ClinGen gnomAD |
|
|
CA398772496 rs1304178599 |
360 | P>S | No |
ClinGen gnomAD |
|
|
CA398772488 rs1298137637 |
361 | A>S | No |
ClinGen gnomAD |
|
|
rs1555551303 CA398772431 |
367 | S>L | No |
ClinGen Ensembl |
|
|
CA398772427 rs1555551302 |
368 | S>L | No |
ClinGen Ensembl |
|
|
CA398772363 rs1555551300 |
379 | G>R | No |
ClinGen Ensembl |
|
|
rs1555551297 CA398772246 |
396 | R>Q | No |
ClinGen Ensembl |
|
|
CA398772230 rs1555551296 |
399 | R>W | No |
ClinGen Ensembl |
|
|
rs1555551295 CA398772181 |
406 | P>L | No |
ClinGen Ensembl |
|
|
rs1555551292 CA398772140 |
413 | S>F | No |
ClinGen Ensembl |
|
|
CA398771728 rs1555551288 |
474 | F>L | No |
ClinGen Ensembl |
|
|
rs1555551286 CA398771682 |
480 | V>A | No |
ClinGen Ensembl |
|
|
CA398771658 rs1555551285 |
484 | S>Y | No |
ClinGen Ensembl |
|
|
rs1555551283 CA398771538 |
501 | R>W | No |
ClinGen Ensembl |
|
|
rs1555551282 CA398771501 |
507 | A>T | No |
ClinGen Ensembl |
|
|
VAR_063088 rs1567681955 CA398771364 |
526 | Q>P | No |
ClinGen UniProt Ensembl dbSNP |
No associated diseases with Q8IZP1
1 regional properties for Q8IZP1
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| domain | Rab-GAP-TBC domain | 98 - 316 | IPR000195 |
2 GO annotations of cellular component
| Name | Definition |
|---|---|
| early endosome membrane | The lipid bilayer surrounding an early endosome. |
| plasma membrane | The membrane surrounding a cell that separates the cell from its external environment. It consists of a phospholipid bilayer and associated proteins. |
1 GO annotations of molecular function
| Name | Definition |
|---|---|
| GTPase activator activity | Binds to and increases the activity of a GTPase, an enzyme that catalyzes the hydrolysis of GTP. |
1 GO annotations of biological process
| Name | Definition |
|---|---|
| activation of GTPase activity | Any process that initiates the activity of an inactive GTPase through the replacement of GDP by GTP. |
29 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| Q5R372 | RABGAP1L | Rab GTPase-activating protein 1-like | Homo sapiens (Human) | PR |
| A0A087X1G2 | TBC1D3K | TBC1 domain family member 3K | Homo sapiens (Human) | PR |
| B9A6J9 | TBC1D3L | TBC1 domain family member 3L | Homo sapiens (Human) | PR |
| Q8WUA7 | TBC1D22A | TBC1 domain family member 22A | Homo sapiens (Human) | PR |
| Q6IPX1 | TBC1D3C | TBC1 domain family member 3C | Homo sapiens (Human) | PR |
| A0A087WVF3 | TBC1D3D | TBC1 domain family member 3D | Homo sapiens (Human) | PR |
| A6NER0 | TBC1D3F | TBC1 domain family member 3F | Homo sapiens (Human) | PR |
| A0A087WXS9 | TBC1D3I | TBC1 domain family member 3I | Homo sapiens (Human) | PR |
| Q6DHY5 | TBC1D3G | TBC1 domain family member 3G | Homo sapiens (Human) | PR |
| A0A087X179 | TBC1D3E | TBC1 domain family member 3E | Homo sapiens (Human) | PR |
| P0C7X1 | TBC1D3H | TBC1 domain family member 3H | Homo sapiens (Human) | PR |
| A6NDS4 | TBC1D3B | TBC1 domain family member 3B | Homo sapiens (Human) | PR |
| Q8IV04 | TBC1D10C | Carabin | Homo sapiens (Human) | PR |
| Q5TC63 | GRTP1 | Growth hormone-regulated TBC protein 1 | Homo sapiens (Human) | PR |
| O60343 | TBC1D4 | TBC1 domain family member 4 | Homo sapiens (Human) | PR |
| Q86TI0 | TBC1D1 | TBC1 domain family member 1 | Homo sapiens (Human) | PR |
| O60447 | EVI5 | Ecotropic viral integration site 5 protein homolog | Homo sapiens (Human) | PR |
| Q3MII6 | TBC1D25 | TBC1 domain family member 25 | Homo sapiens (Human) | PR |
| Q2NKQ1 | SGSM1 | Small G protein signaling modulator 1 | Homo sapiens (Human) | PR |
| Q9HA65 | TBC1D17 | TBC1 domain family member 17 | Homo sapiens (Human) | PR |
| Q8TC07 | TBC1D15 | TBC1 domain family member 15 | Homo sapiens (Human) | PR |
| O95759 | TBC1D8 | TBC1 domain family member 8 | Homo sapiens (Human) | PR |
| Q0IIM8 | TBC1D8B | TBC1 domain family member 8B | Homo sapiens (Human) | PR |
| Q66K14 | TBC1D9B | TBC1 domain family member 9B | Homo sapiens (Human) | PR |
| Q6ZT07 | TBC1D9 | TBC1 domain family member 9 | Homo sapiens (Human) | PR |
| Q8TEA7 | TBCK | TBC domain-containing protein kinase-like protein | Homo sapiens (Human) | PR |
| Q9UPU7 | TBC1D2B | TBC1 domain family member 2B | Homo sapiens (Human) | PR |
| A6H6A9 | Rabgap1l | Rab GTPase-activating protein 1-like | Mus musculus (Mouse) | PR |
| Q80XC3 | Usp6nl | USP6 N-terminal-like protein | Mus musculus (Mouse) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MDVVEVAGSW | WAQEREDIIM | KYEKGHRAGL | PEDKGPKPFR | SYNNNVDHLG | IVHETELPPL |
| 70 | 80 | 90 | 100 | 110 | 120 |
| TAREAKQIRR | EISRKSKWVD | MLGDWEKYKS | SRKLIDRAYK | GMPMNIRGPM | WSVLLNTEEM |
| 130 | 140 | 150 | 160 | 170 | 180 |
| KLKNPGRYQI | MKEKGKRSSE | HIQRIDRDVS | GTLRKHIFFR | DRYGTKQREL | LHILLAYEEY |
| 190 | 200 | 210 | 220 | 230 | 240 |
| NPEVGYCRDL | SHIAALFLLY | LPEEDAFWAL | VQLLASERHS | LQGFHSPNGG | TVQGLQDQQE |
| 250 | 260 | 270 | 280 | 290 | 300 |
| HVVATSQPKT | MGHQDKKDLC | GQCSPLGCLI | RILIDGISLG | LTLRLWDVYL | VEGEQALMPI |
| 310 | 320 | 330 | 340 | 350 | 360 |
| TRIAFKVQQK | RLTKTSRCGP | WARFCNRFVD | TWARDEDTVL | KHLRASMKKL | TRKKGDLPPP |
| 370 | 380 | 390 | 400 | 410 | 420 |
| AKPEQGSSAS | RPVPASRGGK | TLCKGDRQAP | PGPPARFPRP | IWSASPPRAP | RSSTPCPGGA |
| 430 | 440 | 450 | 460 | 470 | 480 |
| VREDTYPVGT | QGVPSPALAQ | GGPQGSWRFL | QWNSMPRLPT | DLDVEGPWFR | HYDFRQSCWV |
| 490 | 500 | 510 | 520 | 530 | 540 |
| RAISQEDQLA | PCWQAEHPAE | RVRSAFAAPS | TDSDQGTPFR | ARDEQQCAPT | SGPCLCGLHL |
| ESSQFPPGF |