B9A6J9
Gene name |
TBC1D3L |
Protein name |
TBC1 domain family member 3L |
Names |
|
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:101060376 |
EC number |
|
Protein Class |
|
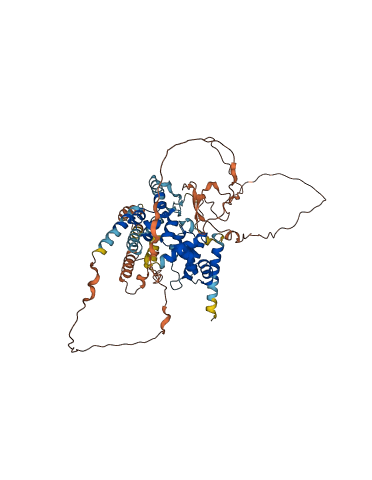
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for B9A6J9
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-B9A6J9-F1 | Predicted | AlphaFoldDB |
75 variants for B9A6J9
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
CA398858384 rs1272663587 |
230 | G>R | No |
ClinGen TOPMed |
|
|
rs1469037720 CA398858355 |
234 | G>E | No |
ClinGen TOPMed |
|
|
CA398857857 rs1185849240 |
303 | I>V | No |
ClinGen TOPMed |
|
| TCGA novel | 313 | T>M | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1567668798 CA398857736 |
318 | C>* | No |
ClinGen Ensembl |
|
| TCGA novel | 318 | C>W | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA398857705 rs1362903119 |
323 | R>C | No |
ClinGen TOPMed |
|
|
rs1413441998 CA398857704 |
323 | R>H | No |
ClinGen TOPMed |
|
| TCGA novel | 325 | C>* | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1312879099 CA398857681 |
326 | N>S | No |
ClinGen TOPMed |
|
|
CA398857674 rs1356165291 |
327 | R>Q | No |
ClinGen TOPMed |
|
|
CA398857665 rs1450232818 |
328 | F>L | No |
ClinGen TOPMed |
|
|
CA398857661 rs1277861494 |
329 | V>D | No |
ClinGen TOPMed |
|
|
rs1350161189 CA398857648 |
331 | T>A | No |
ClinGen TOPMed |
|
|
rs1224588537 CA398857641 |
332 | W>L | No |
ClinGen TOPMed |
|
|
CA398857633 rs1286423922 |
333 | A>S | No |
ClinGen TOPMed |
|
|
rs1355666894 CA398857629 |
334 | R>G | No |
ClinGen TOPMed |
|
|
rs1208623161 CA398857588 |
339 | V>A | No |
ClinGen TOPMed |
|
|
CA398857581 rs1188970290 |
340 | L>R | No |
ClinGen TOPMed |
|
|
rs1469290114 CA398857540 |
346 | S>F | No |
ClinGen TOPMed |
|
| TCGA novel | 347 | M>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1177467289 CA398857511 |
350 | L>P | No |
ClinGen TOPMed |
|
|
CA398857480 rs1173425303 |
355 | G>R | No |
ClinGen TOPMed |
|
| TCGA novel | 359 | P>L | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA398857376 rs1478452244 |
368 | S>L | No |
ClinGen TOPMed |
|
|
rs1172843043 CA398857339 |
374 | P>L | No |
ClinGen TOPMed |
|
|
CA398857199 rs1461091459 |
396 | R>Q | No |
ClinGen TOPMed |
|
|
CA398857181 rs1326912029 |
399 | R>W | No |
ClinGen TOPMed |
|
|
rs1391170435 CA398857134 |
406 | P>L | No |
ClinGen TOPMed |
|
|
rs1388239032 CA398857125 |
408 | R>W | No |
ClinGen TOPMed |
|
|
rs1315971936 CA398857106 |
411 | R>C | No |
ClinGen TOPMed |
|
|
rs1325745919 CA398857038 |
422 | R>Q | No |
ClinGen TOPMed |
|
|
CA398856942 rs1219201357 |
436 | P>L | No |
ClinGen TOPMed |
|
|
rs1279500939 CA398856934 |
438 | L>V | No |
ClinGen TOPMed |
|
|
CA398856801 rs1332112971 |
457 | R>C | No |
ClinGen TOPMed |
|
|
rs1489259994 CA398856756 |
464 | V>I | No |
ClinGen TOPMed |
|
|
rs1203715730 CA398856713 |
470 | R>C | No |
ClinGen TOPMed |
|
|
CA398856711 rs1261496209 |
470 | R>H | No |
ClinGen TOPMed |
|
|
rs1488889903 CA398856633 |
480 | V>A | No |
ClinGen TOPMed |
|
|
CA398856631 rs1196521250 |
481 | R>C | No |
ClinGen TOPMed |
|
|
rs1255488849 CA398856628 |
481 | R>H | No |
ClinGen TOPMed |
|
|
rs1474954695 CA398856609 |
484 | S>Y | No |
ClinGen TOPMed |
|
|
rs1165589690 CA398856564 |
490 | A>V | No |
ClinGen TOPMed |
|
| TCGA novel | 492 | C>A | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1359722155 CA398856533 |
494 | Q>H | No |
ClinGen TOPMed |
|
|
rs1451943190 CA398856540 |
494 | Q>K | No |
ClinGen TOPMed |
|
|
CA398856536 rs1156546577 |
494 | Q>R | No |
ClinGen TOPMed |
|
|
rs1400526895 CA398856523 |
496 | E>G | No |
ClinGen TOPMed |
|
|
rs1300021247 CA398856501 |
499 | A>V | No |
ClinGen TOPMed |
|
|
CA398856489 rs1413555173 |
501 | R>W | No |
ClinGen TOPMed |
|
| TCGA novel | 502 | V>A | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA398856477 rs1312848037 |
503 | R>K | No |
ClinGen TOPMed |
|
|
rs1323097551 CA398856469 |
504 | S>L | No |
ClinGen TOPMed |
|
|
CA398856453 rs1219419148 CA398856454 |
506 | F>L | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA TOPMed |
|
rs1485634231 CA398856451 |
507 | A>P | No |
ClinGen TOPMed |
|
|
CA398856450 rs1485634231 |
507 | A>T | No |
ClinGen TOPMed |
|
|
rs1182484802 CA398856446 |
508 | A>T | No |
ClinGen TOPMed |
|
|
CA398856433 rs1258382056 |
510 | S>G | No |
ClinGen TOPMed |
|
|
CA398856404 rs1417536048 |
514 | D>N | No |
ClinGen TOPMed |
|
|
CA398856389 rs1379435717 |
516 | G>S | No |
ClinGen TOPMed |
|
|
rs1420017775 CA398856383 |
517 | T>A | No |
ClinGen TOPMed |
|
|
rs1373506746 CA398856348 |
522 | R>T | No |
ClinGen TOPMed |
|
|
CA398856344 rs1465503975 |
523 | D>H | No |
ClinGen TOPMed |
|
|
CA398856336 rs1380760310 |
524 | E>K | No |
ClinGen TOPMed |
|
|
rs1389318716 CA398856325 |
525 | Q>R | No |
ClinGen TOPMed |
|
| TCGA novel | 529 | P>H | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA398856298 rs1377204538 |
529 | P>S | No |
ClinGen TOPMed |
|
| TCGA novel | 534 | C>A | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1278681478 CA398856262 |
535 | L>F | No |
ClinGen TOPMed |
|
|
rs1257807665 CA398856248 |
537 | G>S | No |
ClinGen TOPMed |
|
|
rs1195311229 CA398856240 |
538 | L>F | No |
ClinGen TOPMed |
|
| TCGA novel | 538 | L>I | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA398856186 rs1238948002 |
545 | F>S | No |
ClinGen TOPMed |
|
|
CA398856179 rs1441806723 |
546 | P>L | No |
ClinGen TOPMed |
|
|
CA398856151 rs1180221783 |
550 | F>Y | No |
ClinGen TOPMed |
No associated diseases with B9A6J9
1 regional properties for B9A6J9
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| domain | Rab-GAP-TBC domain | 98 - 316 | IPR000195 |
1 GO annotations of cellular component
| Name | Definition |
|---|---|
| plasma membrane | The membrane surrounding a cell that separates the cell from its external environment. It consists of a phospholipid bilayer and associated proteins. |
1 GO annotations of molecular function
| Name | Definition |
|---|---|
| GTPase activator activity | Binds to and increases the activity of a GTPase, an enzyme that catalyzes the hydrolysis of GTP. |
1 GO annotations of biological process
| Name | Definition |
|---|---|
| activation of GTPase activity | Any process that initiates the activity of an inactive GTPase through the replacement of GDP by GTP. |
29 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| Q5R372 | RABGAP1L | Rab GTPase-activating protein 1-like | Homo sapiens (Human) | PR |
| A0A087WVF3 | TBC1D3D | TBC1 domain family member 3D | Homo sapiens (Human) | PR |
| A0A087WXS9 | TBC1D3I | TBC1 domain family member 3I | Homo sapiens (Human) | PR |
| A0A087X179 | TBC1D3E | TBC1 domain family member 3E | Homo sapiens (Human) | PR |
| A0A087X1G2 | TBC1D3K | TBC1 domain family member 3K | Homo sapiens (Human) | PR |
| A6NDS4 | TBC1D3B | TBC1 domain family member 3B | Homo sapiens (Human) | PR |
| A6NER0 | TBC1D3F | TBC1 domain family member 3F | Homo sapiens (Human) | PR |
| O95759 | TBC1D8 | TBC1 domain family member 8 | Homo sapiens (Human) | PR |
| P0C7X1 | TBC1D3H | TBC1 domain family member 3H | Homo sapiens (Human) | PR |
| Q0IIM8 | TBC1D8B | TBC1 domain family member 8B | Homo sapiens (Human) | PR |
| Q2NKQ1 | SGSM1 | Small G protein signaling modulator 1 | Homo sapiens (Human) | PR |
| Q3MII6 | TBC1D25 | TBC1 domain family member 25 | Homo sapiens (Human) | PR |
| Q5TC63 | GRTP1 | Growth hormone-regulated TBC protein 1 | Homo sapiens (Human) | PR |
| Q66K14 | TBC1D9B | TBC1 domain family member 9B | Homo sapiens (Human) | PR |
| Q6DHY5 | TBC1D3G | TBC1 domain family member 3G | Homo sapiens (Human) | PR |
| Q6ZT07 | TBC1D9 | TBC1 domain family member 9 | Homo sapiens (Human) | PR |
| Q8IV04 | TBC1D10C | Carabin | Homo sapiens (Human) | PR |
| Q8IZP1 | TBC1D3 | TBC1 domain family member 3 | Homo sapiens (Human) | PR |
| Q8TC07 | TBC1D15 | TBC1 domain family member 15 | Homo sapiens (Human) | PR |
| Q9HA65 | TBC1D17 | TBC1 domain family member 17 | Homo sapiens (Human) | PR |
| Q9UPU7 | TBC1D2B | TBC1 domain family member 2B | Homo sapiens (Human) | PR |
| Q8WUA7 | TBC1D22A | TBC1 domain family member 22A | Homo sapiens (Human) | PR |
| Q6IPX1 | TBC1D3C | TBC1 domain family member 3C | Homo sapiens (Human) | PR |
| O60343 | TBC1D4 | TBC1 domain family member 4 | Homo sapiens (Human) | PR |
| Q86TI0 | TBC1D1 | TBC1 domain family member 1 | Homo sapiens (Human) | PR |
| O60447 | EVI5 | Ecotropic viral integration site 5 protein homolog | Homo sapiens (Human) | PR |
| Q8TEA7 | TBCK | TBC domain-containing protein kinase-like protein | Homo sapiens (Human) | PR |
| A6H6A9 | Rabgap1l | Rab GTPase-activating protein 1-like | Mus musculus (Mouse) | PR |
| Q80XC3 | Usp6nl | USP6 N-terminal-like protein | Mus musculus (Mouse) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MDVVEVAGSW | WAQEREDIIM | KYEKGHRAGL | PEDKGPKPFR | SYNNNVDHLG | IVHETELPPL |
| 70 | 80 | 90 | 100 | 110 | 120 |
| TAREAKQIRR | EISRKSKWVD | MLGDWEKYKS | SRKLIDRAYK | GMPMNIRGPM | WSVLLNTEEM |
| 130 | 140 | 150 | 160 | 170 | 180 |
| KLKNPGRYQI | MKEKGKRSSE | HIQRIDRDVS | GTLRKHIFFR | DRYGTKQREL | LHILLAYEEY |
| 190 | 200 | 210 | 220 | 230 | 240 |
| NPEVGYCRDL | SHIAALFLLY | LPEEDAFWAL | VQLLASERHS | LQGFHSPNGG | TVQGLQDQQE |
| 250 | 260 | 270 | 280 | 290 | 300 |
| HVVATSQPKT | MGHQDKKDLC | GQCSPLGCLI | RILIDGISLG | LTLRLWDVYL | VEGEQALMPI |
| 310 | 320 | 330 | 340 | 350 | 360 |
| TRIAFKVQQK | RLTKTSRCGP | WARFCNRFVD | TWARDEDTVL | KHLRASMKKL | TRKQGDLQPP |
| 370 | 380 | 390 | 400 | 410 | 420 |
| AKPEQGSSAS | RPVPASRGGK | TLCKGDRQAP | PGPPARFPRP | IWSASPPRAP | RSSTPCPGGA |
| 430 | 440 | 450 | 460 | 470 | 480 |
| VREDTYPVGT | QGVPSPALAQ | GGPQGSWRFL | QWNSMPRLPT | DLDVEGPWFR | HYDFRQSCWV |
| 490 | 500 | 510 | 520 | 530 | 540 |
| RAISQEDQLA | PCWQAEHPAE | RVRSAFAAPS | TDSDQGTPFR | ARDEQPCAPT | SGPCLCGLHL |
| ESSQFPPGF |