A0A087WXS9
Gene name |
TBC1D3I |
Protein name |
TBC1 domain family member 3I |
Names |
|
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:102724862 |
EC number |
|
Protein Class |
|
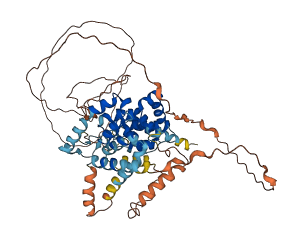
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for A0A087WXS9
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-A0A087WXS9-F1 | Predicted | AlphaFoldDB |
330 variants for A0A087WXS9
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
rs1597758425 CA399254499 |
2 | D>Y | No |
ClinGen Ensembl |
|
|
rs1597758415 CA399254492 |
3 | V>M | No |
ClinGen ESP ExAC gnomAD |
|
|
CA399254487 rs1597758407 |
4 | V>I | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs1597758407 CA399254485 |
4 | V>L | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA399254475 rs1597758402 |
5 | E>D | No |
ClinGen 1000Genomes ESP ExAC gnomAD |
|
|
rs1597758394 CA399254471 |
6 | V>F | No |
1000Genomes ESP ExAC TOPMed gnomAD ClinGen |
|
|
CA399254472 rs1597758394 |
6 | V>L | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1597758385 CA399254467 |
7 | A>T | No |
ClinGen ExAC gnomAD |
|
|
rs1597758377 CA399254462 |
7 | A>V | No |
ClinGen gnomAD |
|
|
CA399254455 rs1597758350 |
9 | S>R | No |
ClinGen ExAC gnomAD |
|
|
rs1597758342 CA399254439 |
10 | W>* | No |
ClinGen gnomAD |
|
|
rs1597758338 CA399254437 |
11 | W>R | No |
gnomAD ClinGen |
|
|
rs1597758334 CA399254421 |
13 | Q>* | No |
gnomAD ClinGen |
|
|
CA399254415 rs1597758329 |
14 | E>K | No |
gnomAD ClinGen |
|
|
rs1597758321 CA399254406 |
15 | R>* | No |
1000Genomes ExAC gnomAD ClinGen |
|
|
CA399254400 rs1597758313 |
16 | E>* | No |
gnomAD ClinGen |
|
|
rs1597758295 CA399254393 |
17 | D>H | No |
gnomAD ClinGen |
|
|
CA399254393 rs1280763788 |
17 | D>H | No |
ClinGen TOPMed |
|
|
CA399254378 rs1597758284 |
19 | I>V | No |
gnomAD ClinGen |
|
|
CA399254350 rs1597758268 |
22 | Y>C | No |
Ensembl ClinGen |
|
|
CA399254354 rs1597758274 |
22 | Y>H | No |
ClinGen gnomAD |
|
|
CA399254347 rs1597758259 |
23 | E>K | No |
ExAC gnomAD ClinGen |
|
|
rs1597758246 CA399254333 |
24 | K>N | No |
ClinGen 1000Genomes gnomAD |
|
|
rs1597758046 CA399254304 |
27 | R>* | No |
ClinGen gnomAD |
|
|
rs1597758043 CA399254302 |
27 | R>Q | No |
gnomAD ClinGen |
|
|
rs1597758025 CA399254267 |
33 | D>N | No |
gnomAD ClinGen |
|
|
CA399254232 rs1597758018 |
38 | P>A | No |
Ensembl ClinGen |
|
|
rs1597758012 CA399254229 |
38 | P>R | No |
gnomAD ClinGen |
|
|
rs1597758006 CA399254218 |
40 | R>* | No |
gnomAD ClinGen |
|
|
rs1597757997 CA399254216 |
40 | R>P | No |
gnomAD ClinGen |
|
|
rs1597757971 CA399254170 |
46 | V>A | No |
ClinGen gnomAD |
|
|
rs1597757980 CA399254173 |
46 | V>I | No |
ClinGen Ensembl |
|
|
CA399254168 rs1597757948 |
47 | D>N | No |
Ensembl ClinGen |
|
|
CA399254157 rs1597757939 |
48 | H>R | No |
ClinGen Ensembl |
|
|
rs1597757928 CA399254122 |
53 | H>R | No |
gnomAD ClinGen |
|
|
CA399254051 rs1597757404 |
62 | A>V | No |
gnomAD ClinGen |
|
|
rs1597757400 CA399254049 |
63 | R>W | No |
gnomAD ClinGen |
|
|
rs1597757388 CA399254032 |
65 | A>V | No |
ClinGen gnomAD |
|
|
CA399253997 rs1597756985 |
68 | I>M | No |
ClinGen ExAC gnomAD |
|
|
CA399253992 rs1597756967 |
69 | R>L | No |
ClinGen ExAC gnomAD |
|
|
CA399253994 rs1597756967 |
69 | R>Q | No |
ClinGen ExAC gnomAD |
|
|
CA399253995 rs1597756979 |
69 | R>W | No |
ClinGen ExAC gnomAD |
|
|
rs1597756953 CA399253990 |
70 | R>W | No |
ExAC gnomAD ClinGen |
|
|
CA399253984 rs1597756948 |
71 | E>* | No |
ExAC gnomAD ClinGen |
|
|
rs1597756936 CA399253972 |
72 | I>M | No |
ClinGen ExAC gnomAD |
|
|
CA399253965 rs1597756923 |
73 | S>R | No |
ClinGen ExAC gnomAD |
|
|
CA399253967 rs1597756931 |
73 | S>T | No |
ExAC gnomAD ClinGen |
|
|
CA399253962 rs1567668318 |
74 | R>* | No |
ClinGen Ensembl |
|
|
CA399253962 rs1597743648 |
74 | R>* | No |
1000Genomes ExAC gnomAD ClinGen |
|
|
CA399253962 rs1597743646 |
74 | R>* | No |
ClinGen Ensembl |
|
|
rs1597743648 CA399253963 |
74 | R>G | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs1597756918 CA399253961 |
74 | R>Q | No |
gnomAD ClinGen |
|
|
rs1597756913 CA399253953 |
75 | K>T | No |
ExAC gnomAD ClinGen |
|
|
CA399253924 rs1597756907 |
79 | V>M | No |
ClinGen ExAC gnomAD |
|
|
CA399253913 rs1597756894 |
80 | D>E | No |
ExAC gnomAD ClinGen |
|
|
CA399253918 rs1597756899 |
80 | D>H | No |
ClinGen gnomAD |
|
|
rs1597756887 CA399253903 CA399253904 |
81 | M>I | No |
ClinGen TOPMed gnomAD |
|
|
CA399253892 rs1597756885 |
83 | G>V | No |
ClinGen ExAC gnomAD |
|
|
CA399253885 rs1597756871 |
84 | D>E | No |
ClinGen ExAC gnomAD |
|
|
CA399253889 rs1597756877 |
84 | D>N | No |
gnomAD ClinGen |
|
|
CA399253874 rs1597756862 |
86 | E>K | No |
ClinGen gnomAD |
|
|
rs1597756851 CA399253863 |
87 | K>I | No |
ClinGen ExAC gnomAD |
|
|
rs1597756851 CA399253861 |
87 | K>T | No |
ClinGen ExAC gnomAD |
|
|
CA399253839 rs1597756833 |
90 | S>N | No |
ExAC gnomAD ClinGen |
|
|
CA399253821 rs1597756816 |
92 | R>S | No |
ExAC gnomAD ClinGen |
|
|
CA399253823 rs1597756822 |
92 | R>T | No |
ClinGen ExAC gnomAD |
|
|
rs1267728852 CA399253793 |
95 | I>L | No |
TOPMed ClinGen |
|
|
CA399253789 rs1597756265 |
95 | I>T | No |
gnomAD ClinGen |
|
|
CA399253778 rs1567668247 |
97 | R>G | No |
Ensembl ClinGen |
|
|
CA399253774 rs1597756260 |
97 | R>L | No |
ClinGen ExAC gnomAD |
|
|
CA399253768 rs1597756254 |
98 | A>V | No |
ExAC gnomAD ClinGen |
|
|
CA399253760 rs1567668241 |
99 | Y>* | No |
Ensembl ClinGen |
|
|
rs1597743549 CA399253760 |
99 | Y>* | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA399253760 rs1597743542 |
99 | Y>* | No |
ClinGen Ensembl |
|
|
rs1183642362 CA399253758 |
100 | K>E | No |
ClinGen TOPMed |
|
|
CA399253737 rs1597756228 |
102 | M>I | No |
ExAC gnomAD ClinGen |
|
|
CA399253722 rs1597756224 |
104 | M>I | No |
ClinGen 1000Genomes gnomAD |
|
|
rs1232978164 CA399253725 |
104 | M>K | No |
TOPMed ClinGen |
|
| TCGA novel | 105 | N>D | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1597756211 CA399253703 |
107 | R>Q | No |
Ensembl ClinGen |
|
|
CA399253705 rs1470777602 |
107 | R>W | No |
TOPMed ClinGen |
|
|
CA399253698 rs1597756201 |
108 | G>D | No |
ClinGen gnomAD |
|
|
rs1597756206 CA399253700 |
108 | G>R | No |
ClinGen gnomAD |
|
| rs201473096 | 109 | P>L | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA399253690 rs1597756194 |
109 | P>L | No |
ExAC gnomAD ClinGen |
|
|
CA399253687 rs1597756175 |
110 | M>L | No |
ClinGen ExAC gnomAD |
|
|
CA399253684 rs1406492254 |
110 | M>T | No |
TOPMed ClinGen |
|
|
rs1597756175 CA399253688 |
110 | M>V | No |
ClinGen ExAC gnomAD |
|
|
rs200426415 CA399253688 |
110 | M>V | No |
ClinGen Ensembl |
|
|
CA399253666 rs1597756169 |
112 | S>L | No |
ClinGen gnomAD |
|
|
CA399253655 rs1407427435 |
114 | L>P | No |
ClinGen TOPMed |
|
|
CA399253653 rs1597756161 |
115 | L>V | No |
ClinGen gnomAD |
|
|
rs1597756155 CA2257891031 |
117 | T>I | No |
gnomAD ClinGen |
|
|
CA728532520 rs1164608695 |
118 | E>K | No |
TOPMed ClinGen |
|
|
CA2257891029 rs1597756146 |
118 | E>Q | No |
ClinGen ExAC gnomAD |
|
|
CA2257891027 rs1597756140 |
120 | M>I | No |
ClinGen ExAC gnomAD |
|
|
rs1403359354 CA399253634 |
122 | M>I | No |
ClinGen TOPMed |
|
|
rs1365127263 CA728532519 |
122 | M>L | No |
TOPMed ClinGen |
|
|
rs1597756132 CA728532519 |
122 | M>L | No |
ClinGen gnomAD |
|
|
CA399253637 rs1597756125 |
122 | M>T | No |
ExAC gnomAD ClinGen |
|
|
CA399253620 rs1597756114 |
124 | N>T | No |
gnomAD ClinGen |
|
|
CA399253614 rs1597756108 |
125 | P>A | No |
ExAC gnomAD ClinGen |
|
| rs748502192 | 126 | G>R | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1597756093 CA399253607 |
126 | G>R | No |
ClinGen ExAC gnomAD |
|
|
rs1597756084 CA399253601 |
127 | R>K | No |
ExAC gnomAD ClinGen |
|
|
rs1597756074 CA399253588 |
129 | Q>K | No |
ClinGen ExAC gnomAD |
|
|
CA399253588 rs201563067 |
129 | Q>K | No |
ClinGen Ensembl |
|
|
CA399253514 rs1597755734 |
136 | K>N | No |
ClinGen gnomAD |
|
|
CA399253511 rs1597755729 |
137 | R>T | No |
gnomAD ClinGen |
|
|
CA399253497 rs1597755719 |
139 | S>Y | No |
ClinGen gnomAD |
|
|
CA399253482 rs1597755709 |
141 | H>R | No |
gnomAD ClinGen |
|
|
CA399253465 rs1597755702 |
143 | Q>H | No |
ClinGen gnomAD |
|
|
CA399253461 rs1597755698 |
144 | R>C | No |
gnomAD ClinGen |
|
|
rs1597755689 CA399253458 |
144 | R>H | No |
gnomAD ClinGen |
|
|
rs1597755689 CA399253459 |
144 | R>P | No |
gnomAD ClinGen |
|
|
CA399253450 rs1597755668 |
146 | D>N | No |
gnomAD ClinGen |
|
|
CA399253442 rs1597755648 |
147 | R>G | No |
ExAC gnomAD ClinGen |
|
|
CA399253438 rs1597755638 |
147 | R>L | No |
ClinGen ExAC gnomAD |
|
|
rs1597755638 CA399253440 |
147 | R>Q | No |
ClinGen ExAC gnomAD |
|
|
rs1453319035 CA399253441 |
147 | R>W | No |
TOPMed ClinGen |
|
|
rs1597755648 CA399253441 |
147 | R>W | No |
ExAC gnomAD ClinGen |
|
|
CA399253435 rs1314061290 |
148 | D>Y | No |
ClinGen TOPMed |
|
|
rs1380270338 CA658682949 |
149 | V>I | No |
TOPMed ClinGen |
|
|
rs1597743536 CA658682949 |
149 | V>I | No |
ClinGen ExAC gnomAD |
|
|
rs1597743530 CA658682949 |
149 | V>I | No |
ClinGen Ensembl |
|
|
CA399253416 rs1597755625 |
151 | G>R | No |
gnomAD ClinGen |
|
|
CA399253405 rs1597755617 |
152 | T>I | No |
gnomAD ClinGen |
|
|
CA399253407 rs1597755617 |
152 | T>K | No |
gnomAD ClinGen |
|
|
CA399253404 rs1597755612 |
153 | L>I | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs1597743518 CA399253386 |
155 | K>R | No |
ClinGen Ensembl |
|
|
rs1597743523 CA399253386 |
155 | K>R | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs1597743498 CA399253381 |
156 | H>D | No |
Ensembl ClinGen |
|
|
CA399253381 rs1597743505 |
156 | H>D | No |
1000Genomes ExAC gnomAD ClinGen |
|
|
CA399253380 rs1597743505 |
156 | H>Y | No |
1000Genomes ExAC gnomAD ClinGen |
|
|
CA399253368 rs1230403606 |
157 | I>M | No |
ClinGen TOPMed |
|
|
CA399253368 rs1597743487 |
157 | I>M | No |
Ensembl ClinGen |
|
|
CA399253368 rs1597743493 |
157 | I>M | No |
ClinGen ExAC gnomAD |
|
|
CA399253365 rs1597755608 |
158 | F>V | No |
ClinGen ExAC gnomAD |
|
|
CA399253354 rs1597755602 |
159 | F>C | No |
ClinGen gnomAD |
|
|
rs1597755586 CA399253348 |
160 | R>K | No |
ExAC ClinGen |
|
|
CA399253335 rs1597755578 |
162 | R>* | No |
ExAC gnomAD ClinGen |
|
|
CA399253334 rs1597755571 |
162 | R>Q | No |
ClinGen ExAC gnomAD |
|
|
rs1597755558 CA399253325 |
163 | Y>* | No |
ExAC gnomAD ClinGen |
|
|
CA399253331 rs1597755567 |
163 | Y>H | No |
ClinGen ExAC gnomAD |
|
|
rs1597755555 CA399253321 |
164 | G>* | No |
ClinGen Ensembl |
|
|
rs1597755550 CA399253317 |
165 | T>S | No |
gnomAD ClinGen |
|
|
rs1597755535 CA399253311 |
166 | K>Q | No |
Ensembl ClinGen |
|
|
rs1158900733 CA399253282 |
168 | R>W | No |
TOPMed ClinGen |
|
|
rs1597754487 CA399253263 |
171 | L>F | No |
ClinGen gnomAD |
|
|
CA399253259 rs1597754481 |
172 | H>Y | No |
gnomAD ClinGen |
|
|
rs1597754471 CA399253242 |
174 | L>F | No |
ClinGen Ensembl |
|
|
rs1597754462 CA399253219 |
178 | E>* | No |
ClinGen gnomAD |
|
|
rs1597754458 CA399253216 |
178 | E>A | No |
ClinGen gnomAD |
|
|
rs1597754455 CA399253201 |
180 | Y>N | No |
gnomAD ClinGen |
|
|
rs1597754447 CA399253182 |
182 | P>L | No |
ClinGen gnomAD |
|
|
rs1335688222 CA399253145 |
186 | Y>S | No |
TOPMed ClinGen |
|
|
CA399253136 rs1597754266 |
187 | C>F | No |
ClinGen Ensembl |
|
|
rs1360404953 CA399253136 |
187 | C>F | No |
TOPMed ClinGen |
|
|
rs1294472977 CA399253141 |
187 | C>R | No |
ClinGen TOPMed |
|
|
rs1597754262 CA399253131 |
188 | R>K | No |
gnomAD ClinGen |
|
|
CA399253115 rs1597754253 |
190 | L>P | No |
ClinGen gnomAD |
|
|
rs1597754235 CA399253090 |
194 | A>T | No |
gnomAD ClinGen |
|
|
rs1481626345 CA399253084 |
195 | A>T | No |
TOPMed ClinGen |
|
|
rs1597754223 CA399253084 |
195 | A>T | No |
ClinGen gnomAD |
|
|
CA399253072 rs1597754212 |
196 | L>F | No |
ClinGen gnomAD |
|
|
CA399253047 rs1597754192 |
200 | Y>C | No |
ClinGen gnomAD |
|
|
CA399253041 rs1177859295 |
201 | L>F | No |
TOPMed ClinGen |
|
|
CA399253027 rs1249727330 |
203 | E>G | No |
TOPMed ClinGen |
|
|
CA399253023 rs1597754188 |
204 | E>K | No |
ClinGen gnomAD |
|
|
CA399252978 rs1597754178 |
210 | L>M | No |
gnomAD ClinGen |
|
|
rs1417306993 CA399252975 |
210 | L>P | No |
TOPMed ClinGen |
|
|
rs1597754172 CA399252960 |
212 | Q>H | No |
gnomAD ClinGen |
|
|
rs1385677220 CA399252946 |
215 | A>D | No |
TOPMed ClinGen |
|
|
rs1597754163 CA399252938 |
216 | S>I | No |
ClinGen gnomAD |
|
|
CA399252940 rs1597754163 |
216 | S>N | No |
ClinGen gnomAD |
|
|
CA399252939 rs1597754163 |
216 | S>T | No |
ClinGen gnomAD |
|
|
CA399252932 rs1597754158 |
217 | E>A | No |
gnomAD ClinGen |
|
|
CA399252931 rs1443811056 |
217 | E>G | No |
TOPMed ClinGen |
|
|
rs1597754153 CA399252924 |
218 | R>T | No |
ClinGen gnomAD |
|
|
rs1597754140 CA399252916 |
219 | H>P | No |
ClinGen gnomAD |
|
|
rs1597754145 CA399252918 |
219 | H>Y | No |
gnomAD ClinGen |
|
|
rs1480821149 CA399252846 |
227 | P>L | No |
TOPMed ClinGen |
|
|
rs1375867356 CA399252831 |
230 | G>R | No |
TOPMed ClinGen |
|
|
rs1597753457 CA399252803 |
234 | G>W | No |
gnomAD ClinGen |
|
|
rs1597753447 CA399252792 |
236 | Q>E | No |
ClinGen gnomAD |
|
|
CA399252740 rs1597753439 |
242 | V>E | No |
gnomAD ClinGen |
|
|
CA399252705 rs1597753435 |
248 | P>S | No |
1000Genomes gnomAD ClinGen |
|
|
CA399252705 rs1158994273 |
248 | P>S | No |
TOPMed ClinGen |
|
|
rs1597753427 CA399252686 |
251 | M>V | No |
Ensembl ClinGen |
|
|
CA399252572 rs1597753299 |
264 | S>F | No |
gnomAD ClinGen |
|
|
rs1597753282 CA399252496 |
276 | G>R | No |
ClinGen Ensembl |
|
|
CA399252407 rs1597753033 |
288 | V>M | No |
ClinGen gnomAD |
|
|
rs1597752846 CA399252116 |
317 | R>W | No |
ClinGen Ensembl |
|
|
CA399252048 rs1597743483 |
320 | P>L | No |
ClinGen Ensembl |
|
|
rs1597743478 CA399252048 |
320 | P>L | No |
ClinGen Ensembl |
|
|
CA399251995 rs1597743469 |
323 | R>C | No |
gnomAD ClinGen |
|
|
rs1597743464 CA399251997 |
323 | R>S | No |
Ensembl ClinGen |
|
|
CA399251997 rs1597743469 |
323 | R>S | No |
ClinGen gnomAD |
|
|
rs1597743448 CA399251943 |
325 | C>W | No |
Ensembl ClinGen |
|
|
rs1597743456 CA399251943 |
325 | C>W | No |
ClinGen Ensembl |
|
|
CA399251879 rs1597743435 |
329 | V>L | No |
Ensembl ClinGen |
|
|
CA399251879 rs1597743440 |
329 | V>L | No |
ClinGen Ensembl |
|
|
CA399251729 CA399251725 rs1597752831 |
336 | E>D | No |
ClinGen gnomAD |
|
|
CA399251725 rs1555547420 |
336 | E>D | No |
ClinGen Ensembl |
|
|
rs1597752826 CA399251516 |
347 | M>R | No |
ClinGen gnomAD |
|
|
rs1597752820 CA399251446 |
354 | Q>K | No |
ClinGen gnomAD |
|
|
CA399251394 rs1597752810 |
357 | L>V | No |
ClinGen gnomAD |
|
|
rs1597752805 CA399251377 |
358 | P>Q | No |
Ensembl ClinGen |
|
|
rs1597752797 CA399251363 |
359 | P>H | No |
gnomAD ClinGen |
|
|
rs1215382910 CA399251270 |
364 | E>K | No |
ClinGen TOPMed |
|
|
rs1283456285 CA399251226 |
366 | G>V | No |
TOPMed ClinGen |
|
|
CA399251211 rs1490678448 |
367 | S>* | No |
TOPMed ClinGen |
|
|
CA399251193 rs1247788933 |
368 | S>L | No |
ClinGen TOPMed |
|
|
rs1189810473 CA399251109 |
374 | P>L | No |
TOPMed ClinGen |
|
|
CA399251109 rs1597752350 |
374 | P>L | No |
gnomAD ClinGen |
|
|
rs1597752354 CA399251112 |
374 | P>S | No |
ClinGen gnomAD |
|
|
rs1597752330 CA399251093 |
375 | A>G | No |
ClinGen gnomAD |
|
|
rs1597752336 CA399251102 |
375 | A>T | No |
ClinGen gnomAD |
|
|
rs1597752326 CA399251069 |
377 | R>C | No |
ClinGen gnomAD |
|
|
CA399251045 rs1597752311 |
379 | G>R | No |
ExAC gnomAD ClinGen |
|
|
CA399250998 rs1158209801 |
382 | L>F | No |
TOPMed ClinGen |
|
|
CA399250998 rs1597752305 |
382 | L>F | No |
gnomAD ClinGen |
|
|
rs1597752295 CA399250988 |
382 | L>P | No |
gnomAD ClinGen |
|
|
CA399250988 rs1378699686 |
382 | L>P | No |
TOPMed ClinGen |
|
|
CA399250943 rs1597752291 |
385 | G>A | No |
gnomAD ClinGen |
|
|
CA399250909 rs1324346636 |
387 | R>S | No |
TOPMed ClinGen |
|
|
CA399250909 rs1597752285 |
387 | R>S | No |
ExAC gnomAD ClinGen |
|
|
rs1597752275 CA399250904 |
388 | Q>K | No |
ClinGen Ensembl |
|
|
rs1597752269 CA399250875 |
389 | A>V | No |
ClinGen gnomAD |
|
|
TCGA novel CA399250862 rs1597752257 |
390 | P>H | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
Ensembl ClinGen NCI-TCGA |
|
CA399250868 rs1349201372 |
390 | P>S | No |
ClinGen TOPMed |
|
|
CA399250868 rs1597752262 |
390 | P>S | No |
ClinGen gnomAD |
|
|
CA399250838 rs1434163514 |
392 | G>C | No |
ClinGen TOPMed |
|
|
CA399250828 rs1597752241 |
393 | P>T | No |
ClinGen gnomAD |
|
|
CA399250797 rs1299842746 |
395 | A>T | No |
ClinGen TOPMed |
|
|
CA399250797 rs1597752235 |
395 | A>T | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 396 | R>Q | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1597752231 CA399250783 |
396 | R>W | No |
Ensembl ClinGen |
|
|
rs1377294166 CA399250783 |
396 | R>W | No |
TOPMed ClinGen |
|
|
rs1239164789 CA399250762 |
397 | F>S | No |
ClinGen TOPMed |
|
|
CA399250741 rs1597752220 |
398 | P>L | No |
ClinGen ExAC gnomAD |
|
|
CA399250745 rs1306625595 |
398 | P>Q | No |
TOPMed ClinGen |
|
|
rs1597752220 CA399250745 |
398 | P>Q | No |
ExAC gnomAD ClinGen |
|
|
CA399250733 rs1288574640 |
399 | R>Q | No |
TOPMed ClinGen |
|
|
rs1597752209 CA399250733 |
399 | R>Q | No |
ClinGen ExAC gnomAD |
|
|
rs1597752213 CA399250736 |
399 | R>W | No |
ClinGen ExAC gnomAD |
|
|
rs1228374843 CA399250736 |
399 | R>W | No |
ClinGen TOPMed |
|
|
CA399250700 rs1597752200 |
401 | I>S | No |
ClinGen Ensembl |
|
|
CA399250671 rs1597752196 |
403 | S>A | No |
Ensembl ClinGen |
|
|
rs1597752182 CA399250648 |
404 | A>G | No |
gnomAD ClinGen |
|
|
rs1597752191 CA399250653 |
404 | A>S | No |
gnomAD ClinGen |
|
|
rs1597752182 CA399250646 |
404 | A>V | No |
gnomAD ClinGen |
|
|
CA399250637 rs1597752172 |
405 | S>P | No |
ClinGen Ensembl |
|
|
CA399250613 rs1597752162 |
406 | P>L | No |
ClinGen ExAC gnomAD |
|
|
CA399250613 rs1449407850 |
406 | P>L | No |
TOPMed ClinGen |
|
|
CA399250605 rs1597752145 |
407 | P>S | No |
gnomAD ClinGen |
|
|
rs1597752145 CA399250610 |
407 | P>T | No |
ClinGen gnomAD |
|
|
CA399250590 rs1240582132 |
408 | R>Q | No |
TOPMed ClinGen |
|
|
rs1597752142 CA399250593 |
408 | R>W | No |
gnomAD ClinGen |
|
|
CA399250549 rs1178480301 |
411 | R>C | No |
TOPMed ClinGen |
|
|
CA399250549 rs1597752129 |
411 | R>C | No |
ClinGen gnomAD |
|
|
CA399250543 rs1236564298 |
411 | R>H | No |
TOPMed ClinGen |
|
|
CA399250543 rs1597752122 |
411 | R>H | No |
ClinGen gnomAD |
|
|
rs1597752117 CA399250513 |
413 | S>F | No |
ExAC gnomAD ClinGen |
|
|
rs1473921992 CA399250513 |
413 | S>F | No |
TOPMed ClinGen |
|
|
rs1164084346 CA399250411 |
420 | A>S | No |
ClinGen TOPMed |
|
|
CA399250392 rs1413108312 |
421 | V>A | No |
ClinGen TOPMed |
|
|
rs1172362074 CA399250378 |
422 | R>Q | No |
TOPMed ClinGen |
|
|
CA399250387 rs1403693680 |
422 | R>W | No |
TOPMed ClinGen |
|
|
CA399250321 rs1597752112 |
426 | Y>H | No |
gnomAD ClinGen |
|
|
rs1597752105 CA399250268 |
429 | G>C | No |
ClinGen gnomAD |
|
|
CA399249807 rs1384501187 |
457 | R>H | No |
TOPMed ClinGen |
|
|
CA399249759 rs1283258208 |
460 | T>M | No |
ClinGen TOPMed |
|
|
rs1448247301 CA399249765 |
460 | T>S | No |
TOPMed ClinGen |
|
|
rs1597752084 CA399249748 |
461 | D>A | No |
Ensembl ClinGen |
|
|
rs1215815386 CA399249734 |
462 | L>V | No |
TOPMed ClinGen |
|
|
CA399249708 rs1260542556 |
463 | D>E | No |
TOPMed ClinGen |
|
|
rs1597752078 CA399249701 |
464 | V>L | No |
gnomAD ClinGen |
|
|
rs1198382844 CA399249618 |
469 | F>I | No |
TOPMed ClinGen |
|
|
rs1597752069 CA399249596 |
470 | R>H | No |
Ensembl ClinGen |
|
|
CA399249582 rs1236691399 |
471 | H>L | No |
TOPMed ClinGen |
|
|
CA399249517 rs1597752067 |
474 | F>L | No |
Ensembl ClinGen |
|
|
CA399249404 rs1444517939 |
480 | V>A | No |
ClinGen TOPMed |
|
|
CA399249404 rs1597752060 |
480 | V>A | No |
gnomAD ClinGen |
|
|
rs1471849380 CA399249396 |
481 | R>C | No |
TOPMed ClinGen |
|
|
rs1471849380 CA399249398 |
481 | R>G | No |
ClinGen TOPMed |
|
|
CA399249393 rs1196011172 |
481 | R>H | No |
TOPMed ClinGen |
|
|
CA399249355 rs1597752056 |
483 | I>M | No |
ClinGen gnomAD |
|
|
CA399249346 rs1597752050 |
484 | S>Y | No |
ClinGen gnomAD |
|
|
rs1465077888 CA399249303 |
487 | D>N | No |
TOPMed ClinGen |
|
|
rs1407963712 CA399249181 |
494 | Q>R | No |
TOPMed ClinGen |
|
|
CA399249181 rs1597752049 |
494 | Q>R | No |
gnomAD ClinGen |
|
|
CA399249133 rs1597752037 |
497 | H>Y | No |
gnomAD ClinGen |
|
|
rs1333008750 CA399249092 |
499 | A>V | No |
TOPMed ClinGen |
|
|
rs1597752032 CA399249092 |
499 | A>V | No |
ClinGen gnomAD |
|
|
CA399249069 rs1597752017 |
501 | R>G | No |
ClinGen gnomAD |
|
|
rs1597752014 CA399249064 |
501 | R>Q | No |
ClinGen Ensembl |
|
|
CA399249066 rs1432268559 |
501 | R>W | No |
TOPMed ClinGen |
|
|
CA399249066 rs1597752017 |
501 | R>W | No |
gnomAD ClinGen |
|
|
rs1278330029 CA399249014 |
504 | S>L | No |
ClinGen TOPMed |
|
|
CA399249014 rs1597752003 |
504 | S>L | No |
gnomAD ClinGen |
|
|
CA399249006 rs1597751997 |
505 | A>P | No |
ClinGen gnomAD |
|
|
rs1218513628 CA399249006 |
505 | A>P | No |
ClinGen TOPMed |
|
|
CA399248977 rs1347502607 |
507 | A>T | No |
TOPMed ClinGen |
|
|
rs1597751994 CA399248977 |
507 | A>T | No |
gnomAD ClinGen |
|
|
rs1597751987 CA399248933 |
510 | S>G | No |
ClinGen Ensembl |
|
|
rs1201452405 CA399248933 |
510 | S>G | No |
ClinGen TOPMed |
|
|
CA399248872 rs1597751975 |
514 | D>N | No |
gnomAD ClinGen |
|
|
CA399248816 rs1597751963 |
517 | T>A | No |
ClinGen gnomAD |
|
|
rs1278172586 CA399248795 |
518 | P>R | No |
TOPMed ClinGen |
|
|
rs1597751952 CA399248749 |
521 | A>T | No |
gnomAD ClinGen |
|
|
CA399248749 rs1218849221 |
521 | A>T | No |
TOPMed ClinGen |
|
|
CA399248722 rs1597751943 |
522 | R>S | No |
gnomAD ClinGen |
|
| TCGA novel | 523 | D>G | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA399248686 rs1191341063 |
524 | E>D | No |
TOPMed ClinGen |
|
|
rs1477548006 CA399248698 |
524 | E>K | No |
TOPMed ClinGen |
|
|
rs1597751923 CA399248698 |
524 | E>K | No |
gnomAD ClinGen |
|
|
CA399248636 rs1379298895 |
527 | C>Y | No |
ClinGen TOPMed |
|
|
CA399248623 rs1597751918 |
528 | A>T | No |
ClinGen Ensembl |
|
|
CA399248580 rs1597751910 |
530 | T>I | No |
ClinGen gnomAD |
|
|
CA399248560 rs1478230817 |
532 | G>R | No |
TOPMed ClinGen |
|
|
CA399248560 rs1597751904 |
532 | G>R | No |
ClinGen gnomAD |
|
| TCGA novel | 532 | G>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA399248480 rs1399580585 |
537 | G>S | No |
ClinGen TOPMed |
|
|
rs1597751888 CA399248395 |
541 | E>D | No |
gnomAD ClinGen |
|
|
CA399248383 rs1359286783 |
542 | S>N | No |
TOPMed ClinGen |
|
|
rs1597751883 CA399248383 |
542 | S>N | No |
Ensembl ClinGen |
|
|
rs1397595679 CA399248349 |
544 | Q>P | No |
TOPMed ClinGen |
|
|
CA399248332 rs1597751878 |
545 | F>S | No |
gnomAD ClinGen |
|
|
CA399248303 rs1276852593 |
547 | P>S | No |
TOPMed ClinGen |
No associated diseases with A0A087WXS9
1 regional properties for A0A087WXS9
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| domain | Rab-GAP-TBC domain | 98 - 316 | IPR000195 |
1 GO annotations of cellular component
| Name | Definition |
|---|---|
| plasma membrane | The membrane surrounding a cell that separates the cell from its external environment. It consists of a phospholipid bilayer and associated proteins. |
1 GO annotations of molecular function
| Name | Definition |
|---|---|
| GTPase activator activity | Binds to and increases the activity of a GTPase, an enzyme that catalyzes the hydrolysis of GTP. |
1 GO annotations of biological process
| Name | Definition |
|---|---|
| activation of GTPase activity | Any process that initiates the activity of an inactive GTPase through the replacement of GDP by GTP. |
29 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| Q5R372 | RABGAP1L | Rab GTPase-activating protein 1-like | Homo sapiens (Human) | PR |
| A0A087X1G2 | TBC1D3K | TBC1 domain family member 3K | Homo sapiens (Human) | PR |
| B9A6J9 | TBC1D3L | TBC1 domain family member 3L | Homo sapiens (Human) | PR |
| A0A087WVF3 | TBC1D3D | TBC1 domain family member 3D | Homo sapiens (Human) | PR |
| A0A087X179 | TBC1D3E | TBC1 domain family member 3E | Homo sapiens (Human) | PR |
| A6NDS4 | TBC1D3B | TBC1 domain family member 3B | Homo sapiens (Human) | PR |
| P0C7X1 | TBC1D3H | TBC1 domain family member 3H | Homo sapiens (Human) | PR |
| Q6DHY5 | TBC1D3G | TBC1 domain family member 3G | Homo sapiens (Human) | PR |
| Q9HA65 | TBC1D17 | TBC1 domain family member 17 | Homo sapiens (Human) | PR |
| Q66K14 | TBC1D9B | TBC1 domain family member 9B | Homo sapiens (Human) | PR |
| Q6ZT07 | TBC1D9 | TBC1 domain family member 9 | Homo sapiens (Human) | PR |
| Q8WUA7 | TBC1D22A | TBC1 domain family member 22A | Homo sapiens (Human) | PR |
| Q8IZP1 | TBC1D3 | TBC1 domain family member 3 | Homo sapiens (Human) | PR |
| Q6IPX1 | TBC1D3C | TBC1 domain family member 3C | Homo sapiens (Human) | PR |
| A6NER0 | TBC1D3F | TBC1 domain family member 3F | Homo sapiens (Human) | PR |
| Q8IV04 | TBC1D10C | Carabin | Homo sapiens (Human) | PR |
| Q5TC63 | GRTP1 | Growth hormone-regulated TBC protein 1 | Homo sapiens (Human) | PR |
| O60343 | TBC1D4 | TBC1 domain family member 4 | Homo sapiens (Human) | PR |
| Q86TI0 | TBC1D1 | TBC1 domain family member 1 | Homo sapiens (Human) | PR |
| O60447 | EVI5 | Ecotropic viral integration site 5 protein homolog | Homo sapiens (Human) | PR |
| Q3MII6 | TBC1D25 | TBC1 domain family member 25 | Homo sapiens (Human) | PR |
| Q2NKQ1 | SGSM1 | Small G protein signaling modulator 1 | Homo sapiens (Human) | PR |
| Q8TC07 | TBC1D15 | TBC1 domain family member 15 | Homo sapiens (Human) | PR |
| O95759 | TBC1D8 | TBC1 domain family member 8 | Homo sapiens (Human) | PR |
| Q0IIM8 | TBC1D8B | TBC1 domain family member 8B | Homo sapiens (Human) | PR |
| Q8TEA7 | TBCK | TBC domain-containing protein kinase-like protein | Homo sapiens (Human) | PR |
| Q9UPU7 | TBC1D2B | TBC1 domain family member 2B | Homo sapiens (Human) | PR |
| A6H6A9 | Rabgap1l | Rab GTPase-activating protein 1-like | Mus musculus (Mouse) | PR |
| Q80XC3 | Usp6nl | USP6 N-terminal-like protein | Mus musculus (Mouse) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MDVVEVAGSW | WAQEREDIIM | KYEKGHRAGL | PEDKGPKPFR | SYNNNVDHLG | IVHETELPPL |
| 70 | 80 | 90 | 100 | 110 | 120 |
| TAREAKQIRR | EISRKSKWVD | MLGDWEKYKS | SRKLIDRAYK | GMPMNIRGPM | WSVLLNTEEM |
| 130 | 140 | 150 | 160 | 170 | 180 |
| KMKNPGRYQI | MKEKGKRSSE | HIQRIDRDVS | GTLRKHIFFR | DRYGTKQREL | LHILLAYEEY |
| 190 | 200 | 210 | 220 | 230 | 240 |
| NPEVGYCRDL | SHIAALFLLY | LPEEDAFWAL | VQLLASERHS | LQGFHSPNGG | TVQGLQDQQE |
| 250 | 260 | 270 | 280 | 290 | 300 |
| HVVATSQPKT | MGHQDKKDLC | GQCSPLGCLI | RILIDGISLG | LTLRLWDVYL | VEGEQALMPI |
| 310 | 320 | 330 | 340 | 350 | 360 |
| TRIAFKVQQK | RLTKTSRCGP | WARFCNRFVD | TWARDEDTVL | KHLRASMKKL | TRKQGDLPPP |
| 370 | 380 | 390 | 400 | 410 | 420 |
| AKPEQGSSAS | RPVPASRGGK | TLCKGDRQAP | PGPPARFPRP | IWSASPPRAP | RSSTPCPGGA |
| 430 | 440 | 450 | 460 | 470 | 480 |
| VREDTYPVGT | QGVPSPALAQ | GGPQGSWRFL | QWNSMPRLPT | DLDVEGPWFR | HYDFRQSCWV |
| 490 | 500 | 510 | 520 | 530 | 540 |
| RAISQEDQLA | PCWQAEHPAE | RVRSAFAAPS | TDSDQGTPFR | ARDEQQCAPT | SGPCLCGLHL |
| ESSQFPPGF |