F4IBD7
Gene name |
RXW8 (At1g58520, R18I, X7J) |
Protein name |
CSC1-like protein RXW8 |
Names |
|
Species |
Arabidopsis thaliana (Mouse-ear cress) |
KEGG Pathway |
ath:AT1G58520 |
EC number |
|
Protein Class |
|
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
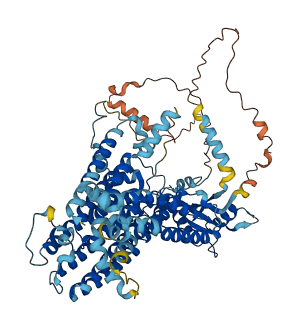
Autoinhibited structure

Activated structure
1 structures for F4IBD7
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-F4IBD7-F1 | Predicted | AlphaFoldDB |
86 variants for F4IBD7
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
| tmp_1_21733590_A_G | 16 | I>M | No | 1000Genomes | |
| ENSVATH14352162 | 49 | R>S | No | 1000Genomes | |
| ENSVATH14352163 | 52 | P>H | No | 1000Genomes | |
| ENSVATH01396646 | 57 | R>W | No | 1000Genomes | |
| ENSVATH14352164 | 66 | V>M | No | 1000Genomes | |
| ENSVATH14352195 | 72 | S>C | No | 1000Genomes | |
| ENSVATH00105104 | 73 | E>Q | No | 1000Genomes | |
| ENSVATH01396650 | 92 | I>V | No | 1000Genomes | |
| tmp_1_21733953_G_C | 105 | C>S | No | 1000Genomes | |
| ENSVATH00105105 | 114 | Y>F | No | 1000Genomes | |
| ENSVATH13636034 | 119 | M>V | No | 1000Genomes | |
| ENSVATH14352197 | 133 | T>A | No | 1000Genomes | |
| ENSVATH14352198 | 139 | E>D | No | 1000Genomes | |
| tmp_1_21734173_T_C | 144 | L>P | No | 1000Genomes | |
| ENSVATH04996033 | 154 | I>L | No | 1000Genomes | |
| ENSVATH04996034 | 156 | S>L | No | 1000Genomes | |
| tmp_1_21734233_T_C | 164 | F>S | No | 1000Genomes | |
| ENSVATH01396678 | 171 | K>T | No | 1000Genomes | |
| ENSVATH13636054 | 175 | G>R | No | 1000Genomes | |
| tmp_1_21734402_G_A | 179 | G>E | No | 1000Genomes | |
| ENSVATH00105110 | 180 | C>S | No | 1000Genomes | |
| tmp_1_21734417_C_T | 184 | P>L | No | 1000Genomes | |
| ENSVATH04996040 | 197 | S>P | No | 1000Genomes | |
| ENSVATH00105111 | 198 | P>S | No | 1000Genomes | |
| ENSVATH00105111 | 198 | P>T | No | 1000Genomes | |
| ENSVATH04996041 | 204 | D>N | No | 1000Genomes | |
| ENSVATH00105112 | 228 | G>S | No | 1000Genomes | |
| ENSVATH13636124 | 235 | R>C | No | 1000Genomes | |
| ENSVATH13636135 | 252 | N>I | No | 1000Genomes | |
| ENSVATH04996068 | 261 | T>I | No | 1000Genomes | |
| tmp_1_21735288_G_A | 265 | G>R | No | 1000Genomes | |
| tmp_1_21735291_C_T | 266 | P>S | No | 1000Genomes | |
| ENSVATH00105119 | 270 | S>N | No | 1000Genomes | |
| ENSVATH13636136 | 282 | V>E | No | 1000Genomes | |
| ENSVATH04996070 | 298 | E>K | No | 1000Genomes | |
| ENSVATH01396708 | 299 | Q>E | No | 1000Genomes | |
| tmp_1_21735822_G_T | 301 | R>L | No | 1000Genomes | |
| tmp_1_21735843_T_G | 308 | F>C | No | 1000Genomes | |
| tmp_1_21735864_T_A | 315 | L>H | No | 1000Genomes | |
| tmp_1_21735888_C_A | 323 | S>* | No | 1000Genomes | |
| tmp_1_21735906_G_T | 329 | W>L | No | 1000Genomes | |
| tmp_1_21735938_G_C | 340 | V>L | No | 1000Genomes | |
| tmp_1_21735943_C_G | 341 | Y>* | No | 1000Genomes | |
| ENSVATH13636162 | 360 | L>V | No | 1000Genomes | |
| tmp_1_21736058_C_A | 380 | L>M | No | 1000Genomes | |
| ENSVATH14352242 | 389 | A>T | No | 1000Genomes | |
| tmp_1_21736419_G_T | 426 | M>I | No | 1000Genomes | |
| tmp_1_21736454_G_A | 438 | R>Q | No | 1000Genomes | |
| ENSVATH14352266 | 440 | I>M | No | 1000Genomes | |
| ENSVATH01396735 | 450 | L>I | No | 1000Genomes | |
| ENSVATH01396735 | 450 | L>V | No | 1000Genomes | |
| ENSVATH04996095 | 457 | V>L | No | 1000Genomes | |
| tmp_1_21736598_G_A | 486 | R>K | No | 1000Genomes | |
| tmp_1_21737000_A_G | 511 | I>M | No | 1000Genomes | |
| ENSVATH04996106 | 525 | V>I | No | 1000Genomes | |
| ENSVATH04996106 | 525 | V>L | No | 1000Genomes | |
| ENSVATH13636217 | 527 | T>A | No | 1000Genomes | |
| ENSVATH13636218 | 530 | E>D | No | 1000Genomes | |
| ENSVATH01396754 | 536 | T>A | No | 1000Genomes | |
| ENSVATH01396755 | 537 | L>F | No | 1000Genomes | |
| tmp_1_21737162_A_G | 565 | I>M | No | 1000Genomes | |
| tmp_1_21737571_A_T | 604 | N>Y | No | 1000Genomes | |
| tmp_1_21737628_T_G | 623 | L>V | No | 1000Genomes | |
| tmp_1_21737718_C_T | 653 | P>S | No | 1000Genomes | |
| ENSVATH13636251 | 665 | D>N | No | 1000Genomes | |
| ENSVATH01396777 | 666 | M>I | No | 1000Genomes | |
| tmp_1_21737849_G_A | 668 | R>K | No | 1000Genomes | |
| ENSVATH13636252 | 677 | E>D | No | 1000Genomes | |
| ENSVATH04996136 | 678 | E>D | No | 1000Genomes | |
| ENSVATH14352271 | 682 | K>I | No | 1000Genomes | |
| tmp_1_21737920_T_A | 692 | L>I | No | 1000Genomes | |
| ENSVATH14352272 | 698 | S>W | No | 1000Genomes | |
| ENSVATH13636253 | 708 | K>E | No | 1000Genomes | |
| tmp_1_21737984_C_A | 713 | P>Q | No | 1000Genomes | |
| tmp_1_21738097_G_A | 725 | A>T | No | 1000Genomes | |
| ENSVATH14352315 | 725 | A>V | No | 1000Genomes | |
| ENSVATH01396784 | 729 | E>D | No | 1000Genomes | |
| tmp_1_21738116_G_T | 731 | W>L | No | 1000Genomes | |
| tmp_1_21738119_G_T | 732 | G>V | No | 1000Genomes | |
| tmp_1_21738137_C_T | 738 | S>F | No | 1000Genomes | |
| tmp_1_21738143_A_G | 740 | Q>R | No | 1000Genomes | |
| tmp_1_21738148_C_G | 742 | H>D | No | 1000Genomes | |
| tmp_1_21738152_A_T | 743 | D>V | No | 1000Genomes | |
| ENSVATH01396786 | 744 | T>A | No | 1000Genomes | |
| tmp_1_21738155_C_G | 744 | T>S | No | 1000Genomes | |
| ENSVATH10018034 | 747 | S>CFNI | No | 1000Genomes |
No associated diseases with F4IBD7
2 GO annotations of cellular component
| Name | Definition |
|---|---|
| integral component of membrane | The component of a membrane consisting of the gene products and protein complexes having at least some part of their peptide sequence embedded in the hydrophobic region of the membrane. |
| plasma membrane | The membrane surrounding a cell that separates the cell from its external environment. It consists of a phospholipid bilayer and associated proteins. |
1 GO annotations of molecular function
| Name | Definition |
|---|---|
| calcium activated cation channel activity | Enables the calcium concentration-regulatable energy-independent passage of cations across a lipid bilayer down a concentration gradient. |
No GO annotations of biological process
| Name | Definition |
|---|---|
| No GO annotations for biological process |
9 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| Q5T3F8 | TMEM63B | CSC1-like protein 2 | Homo sapiens (Human) | PR |
| Q9P1W3 | TMEM63C | Calcium permeable stress-gated cation channel 1 | Homo sapiens (Human) | PR |
| O94886 | TMEM63A | CSC1-like protein 1 | Homo sapiens (Human) | PR |
| Q91YT8 | Tmem63a | CSC1-like protein 1 | Mus musculus (Mouse) | PR |
| B5TYT3 | At1g11960 | CSC1-like protein At1g11960 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| F4HYR3 | At1g62320 | CSC1-like protein At1g62320 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q5XEZ5 | CSC1 | Calcium permeable stress-gated cation channel 1 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q94A87 | At1g10090 | CSC1-like protein At1g10090 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9XEA1 | OSCA1 | Protein OSCA1 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MEISALLTSA | GINISICIVL | LSLYSILRKQ | PANYCVYFGR | RLVCGGARRY | DPFWYERFVP |
| 70 | 80 | 90 | 100 | 110 | 120 |
| SPSWLVKAWE | TSEDELLAAA | GLDAVVFLRM | VIFSIRIFFI | VAVICIAFVL | PVNYYGQPMV |
| 130 | 140 | 150 | 160 | 170 | 180 |
| HKEIHLESSE | VFTIENLKEG | SKWLWVHCLA | LYIITSAACL | LLYFEYSTIA | KMRLGHITGC |
| 190 | 200 | 210 | 220 | 230 | 240 |
| ASKPSQFTVL | IRAIPWSPEQ | SYSDTLSKFF | TNYYSSSYVS | HQMVYHNGII | QRLLRDAERM |
| 250 | 260 | 270 | 280 | 290 | 300 |
| CQTLKHVSPE | INCKPSLRPC | TFCGGPTATS | SFHILSNEAD | SVKGMELGEL | TMTTTTTEQE |
| 310 | 320 | 330 | 340 | 350 | 360 |
| RSAAFVFFKT | RYDALVVSEV | LQSSNPMLWV | TDLAPEPHDV | YWKNLNIPYR | QLWIRKIATL |
| 370 | 380 | 390 | 400 | 410 | 420 |
| VGAVAFMFVF | LIPVTFIQGL | TQLVQLSHAF | PFLRGILSKN | FINQVITGYL | PSVILILFFY |
| 430 | 440 | 450 | 460 | 470 | 480 |
| AVPPLMMYFS | ALEGCISRSI | RKKSACIKVL | YFTIWNVFFV | NILSGSVIRQ | LNVFSSVRDI |
| 490 | 500 | 510 | 520 | 530 | 540 |
| PAQLARAVPT | QAGFFMTYCF | TSGWASLACE | IMQPMALIWN | LVAKVVTKNE | DESYETLRFP |
| 550 | 560 | 570 | 580 | 590 | 600 |
| YHTEIPRLLL | FGLLGFTNSV | IAPLILPFLL | IYFFLAYLIY | KNQILNVYIT | KYESGGQYWP |
| 610 | 620 | 630 | 640 | 650 | 660 |
| IFHNTTIFSL | ILTQIIALGF | FGLKLSTVAS | GFTIPLILLT | LLFSEYCRQR | FAPIFNKNPA |
| 670 | 680 | 690 | 700 | 710 | 720 |
| QVLIDMDRAD | EISGKMEELH | KKLHNVYSQI | PLHSQKSSSK | AECSNPFKKQ | ELPDPEKLKP |
| 730 | 740 | ||||
| EEGDAIAKEL | WGFQGNESGQ | EHDTKS |