O82189
Gene name |
RDR4 (RDRP4, At2g19920, F6F22.5) |
Protein name |
Probable RNA-dependent RNA polymerase 4 |
Names |
AtRDRP4, RNA-directed RNA polymerase 4 |
Species |
Arabidopsis thaliana (Mouse-ear cress) |
KEGG Pathway |
ath:AT2G19920 |
EC number |
2.7.7.48: Nucleotidyltransferases |
Protein Class |
|
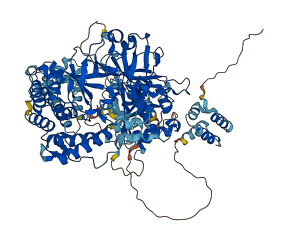
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for O82189
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-O82189-F1 | Predicted | AlphaFoldDB |
128 variants for O82189
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
| ENSVATH05538149 | 4 | T>I | No | 1000Genomes | |
| ENSVATH05538147 | 17 | W>C | No | 1000Genomes | |
| ENSVATH05538145 | 55 | S>A | No | 1000Genomes | |
| tmp_2_8606701_G_A | 63 | L>F | No | 1000Genomes | |
| tmp_2_8606645_A_T | 81 | Y>* | No | 1000Genomes | |
| ENSVATH05538144 | 84 | N>S | No | 1000Genomes | |
| ENSVATH13290906 | 100 | S>F | No | 1000Genomes | |
| ENSVATH01848632 | 109 | G>R | No | 1000Genomes | |
| ENSVATH07885457 | 111 | K>T | No | 1000Genomes | |
| tmp_2_8606554_T_C | 112 | S>G | No | 1000Genomes | |
| ENSVATH00239604 | 128 | S>T | No | 1000Genomes | |
| ENSVATH13290905 | 136 | E>D | No | 1000Genomes | |
| tmp_2_8606326_A_T | 147 | L>* | No | 1000Genomes | |
| ENSVATH14522886 | 150 | G>D | No | 1000Genomes | |
| tmp_2_8606278_T_C | 163 | Y>C | No | 1000Genomes | |
| ENSVATH13290893 | 164 | L>P | No | 1000Genomes | |
| tmp_2_8606193_T_G | 167 | K>N | No | 1000Genomes | |
| ENSVATH01848621 | 192 | A>S | No | 1000Genomes | |
| tmp_2_8606083_A_T | 204 | M>K | No | 1000Genomes | |
| ENSVATH07885430 | 208 | S>A | No | 1000Genomes | |
| ENSVATH05538135 | 208 | S>L | No | 1000Genomes | |
| ENSVATH05538135 | 208 | S>W | No | 1000Genomes | |
| tmp_2_8605866_A_T | 209 | D>E | No | 1000Genomes | |
| tmp_2_8605835_C_A | 220 | V>F | No | 1000Genomes | |
| tmp_2_8605826_C_T | 223 | D>N | No | 1000Genomes | |
| tmp_2_8605822_C_G | 224 | G>A | No | 1000Genomes | |
| ENSVATH07885427 | 227 | R>I | No | 1000Genomes | |
| ENSVATH07885427 | 227 | R>K | No | 1000Genomes | |
| ENSVATH07885423 | 231 | Y>H | No | 1000Genomes | |
| ENSVATH07885422 | 232 | F>L | No | 1000Genomes | |
| ENSVATH01848618 | 236 | T>A | No | 1000Genomes | |
| tmp_2_8605631_TA_AA,T | 250 | L>F | No | 1000Genomes | |
| tmp_2_8605624_T_A | 253 | R>* | No | 1000Genomes | |
| ENSVATH05538131 | 273 | E>G | No | 1000Genomes | |
| tmp_2_8605541_C_T | 280 | M>I | No | 1000Genomes | |
| ENSVATH13290880 | 296 | K>T | No | 1000Genomes | |
| ENSVATH05538129 | 302 | R>K | No | 1000Genomes | |
| ENSVATH01848608 | 304 | S>F | No | 1000Genomes | |
| ENSVATH09472533 | 307 | Q>K | No | 1000Genomes | |
| tmp_2_8605228_C_T | 338 | R>H | No | 1000Genomes | |
| tmp_2_8605213_T_C | 343 | H>R | No | 1000Genomes | |
| ENSVATH13290879 | 348 | P>S | No | 1000Genomes | |
| tmp_2_8605195_G_A | 349 | S>F | No | 1000Genomes | |
| ENSVATH05538123 | 351 | A>P | No | 1000Genomes | |
| ENSVATH01848601 | 363 | K>N | No | 1000Genomes | |
| ENSVATH01848599 | 386 | D>N | No | 1000Genomes | |
| tmp_2_8604844_C_G | 397 | G>A | No | 1000Genomes | |
| tmp_2_8604830_G_C | 402 | H>D | No | 1000Genomes | |
| ENSVATH05538117 | 407 | G>E | No | 1000Genomes | |
| tmp_2_8604796_A_C | 413 | L>R | No | 1000Genomes | |
| tmp_2_8604791_G_A | 415 | R>W | No | 1000Genomes | |
| ENSVATH13290863 | 416 | M>I | No | 1000Genomes | |
| tmp_2_8604778_A_G | 419 | L>S | No | 1000Genomes | |
| ENSVATH01848593 | 419 | L>V | No | 1000Genomes | |
| tmp_2_8604774_A_T | 420 | N>K | No | 1000Genomes | |
| tmp_2_8604768_A_T | 422 | F>L | No | 1000Genomes | |
| ENSVATH01848592 | 427 | M>I | No | 1000Genomes | |
| ENSVATH05538114 | 427 | M>L | No | 1000Genomes | |
| tmp_2_8604754_A_C | 427 | M>R | No | 1000Genomes | |
| ENSVATH01848591 | 434 | G>E | No | 1000Genomes | |
| ENSVATH13290860 | 437 | V>I | No | 1000Genomes | |
| tmp_2_8604638_T_A | 439 | E>V | No | 1000Genomes | |
| ENSVATH05538109 | 445 | Q>* | No | 1000Genomes | |
| tmp_2_8604491_T_A | 458 | I>F | No | 1000Genomes | |
| ENSVATH05538108 | 459 | F>Y | No | 1000Genomes | |
| tmp_2_8604481_A_C | 461 | L>* | No | 1000Genomes | |
| tmp_2_8604479_T_C | 462 | N>D | No | 1000Genomes | |
| tmp_2_8604478_T_G | 462 | N>T | No | 1000Genomes | |
| tmp_2_8604389_G_C | 468 | Q>E | No | 1000Genomes | |
| tmp_2_8604386_T_C | 469 | T>A | No | 1000Genomes | |
| tmp_2_8604367_G_T | 475 | S>Y | No | 1000Genomes | |
| tmp_2_8604364_A_T | 476 | M>K | No | 1000Genomes | |
| ENSVATH13290855 | 484 | N>K | No | 1000Genomes | |
| tmp_2_8604322_G_A | 490 | T>M | No | 1000Genomes | |
| ENSVATH13290854 | 491 | F>L | No | 1000Genomes | |
| ENSVATH05538106 | 506 | A>S | No | 1000Genomes | |
| ENSVATH05538105 | 509 | S>L | No | 1000Genomes | |
| ENSVATH00239600 | 514 | A>S | No | 1000Genomes | |
| ENSVATH05538104 | 531 | L>H | No | 1000Genomes | |
| ENSVATH05538103 | 536 | K>E | No | 1000Genomes | |
| ENSVATH13290851 | 539 | T>I | No | 1000Genomes | |
| tmp_2_8604065_C_A | 546 | A>S | No | 1000Genomes | |
| tmp_2_8604061_G_A | 547 | A>V | No | 1000Genomes | |
| tmp_2_8604054_T_A | 549 | K>N | No | 1000Genomes | |
| tmp_2_8603887_G_A,GT | 552 | L>F | No | 1000Genomes | |
| ENSVATH13290847 | 556 | N>H | No | 1000Genomes | |
| tmp_2_8603787_A_T | 585 | L>* | No | 1000Genomes | |
| tmp_2_8603752_G_T | 597 | L>I | No | 1000Genomes | |
| ENSVATH05538099 | 620 | V>I | No | 1000Genomes | |
| ENSVATH00239598 | 624 | A>G | No | 1000Genomes | |
| tmp_2_8603481_G_C | 638 | H>D | No | 1000Genomes | |
| tmp_2_8603472_C_A | 641 | D>Y | No | 1000Genomes | |
| tmp_2_8603466_G_A | 643 | H>Y | No | 1000Genomes | |
| ENSVATH01848578 | 668 | Q>* | No | 1000Genomes | |
| tmp_2_8603349_C_T | 682 | D>N | No | 1000Genomes | |
| ENSVATH01848576 | 689 | F>L | No | 1000Genomes | |
| ENSVATH05538097 | 690 | I>V | No | 1000Genomes | |
| ENSVATH13290830 | 694 | P>S | No | 1000Genomes | |
| ENSVATH05538096 | 701 | K>N | No | 1000Genomes | |
| ENSVATH13290828 | 704 | E>K | No | 1000Genomes | |
| ENSVATH00239597 | 707 | V>A | No | 1000Genomes | |
| ENSVATH01848574 | 712 | R>P | No | 1000Genomes | |
| tmp_2_8603162_G_A | 717 | T>I | No | 1000Genomes | |
| ENSVATH13290826 | 722 | S>T | No | 1000Genomes | |
| ENSVATH13290824 | 728 | Q>E | No | 1000Genomes | |
| tmp_2_8603106_T_A | 736 | I>F | No | 1000Genomes | |
| ENSVATH05538095 | 736 | I>M | No | 1000Genomes | |
| tmp_2_8603099_A_C | 738 | L>* | No | 1000Genomes | |
| tmp_2_8603095_C_A | 739 | K>N | No | 1000Genomes | |
| tmp_2_8603094_T_C | 740 | T>A | No | 1000Genomes | |
| tmp_2_8603091_C_T | 741 | G>R | No | 1000Genomes | |
| ENSVATH05538094 | 747 | V>D | No | 1000Genomes | |
| ENSVATH13290800 | 788 | Y>D | No | 1000Genomes | |
| tmp_2_8602864_C_T | 790 | A>T | No | 1000Genomes | |
| tmp_2_8602851_G_T | 794 | P>Q | No | 1000Genomes | |
| ENSVATH05538090 | 797 | G>E | No | 1000Genomes | |
| tmp_2_8602839_G_A | 798 | T>I | No | 1000Genomes | |
| ENSVATH05538088 | 816 | E>A | No | 1000Genomes | |
| ENSVATH05538087 | 828 | G>E | No | 1000Genomes | |
| ENSVATH01848568 | 829 | L>S | No | 1000Genomes | |
| ENSVATH14522867 | 831 | F>V | No | 1000Genomes | |
| tmp_2_8602704_G_A | 843 | T>I | No | 1000Genomes | |
| tmp_2_8602696_C_T | 846 | G>R | No | 1000Genomes | |
| ENSVATH01848552 | 911 | K>I | No | 1000Genomes | |
| ENSVATH01848551 | 912 | I>S | No | 1000Genomes | |
| tmp_2_8602254_G_C | 918 | P>A | No | 1000Genomes | |
| tmp_2_8602248_C_T | 920 | A>T | No | 1000Genomes | |
| ENSVATH00239592 | 928 | T>Y | No | 1000Genomes |
No associated diseases with O82189
No regional properties for O82189
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| No domain, repeats, and functional sites for O82189 | |||
Functions
| Description | ||
|---|---|---|
| EC Number | 2.7.7.48 | Nucleotidyltransferases |
| Subcellular Localization |
|
|
| PANTHER Family | ||
| PANTHER Subfamily | ||
| PANTHER Protein Class | ||
| PANTHER Pathway Category | No pathway information available | |
1 GO annotations of cellular component
| Name | Definition |
|---|---|
| nuclear RNA-directed RNA polymerase complex | A complex required for RNAi mediated heterochromatin assembly. In S. pombe this contains RNA-directed RNA polymerase, a putative helicase and a protein containing a pap25 associated domain. |
2 GO annotations of molecular function
| Name | Definition |
|---|---|
| RNA binding | Binding to an RNA molecule or a portion thereof. |
| RNA-directed 5'-3' RNA polymerase activity | Catalysis of the reaction: nucleoside triphosphate + RNA(n) = diphosphate + RNA(n+1); uses an RNA template, i.e. the catalysis of RNA-template-directed extension of the 3'-end of an RNA strand by one nucleotide at a time. |
1 GO annotations of biological process
| Name | Definition |
|---|---|
| siRNA processing | A process leading to the generation of a functional small interfering RNA (siRNA). Includes the cleavage of double-stranded RNA to form small interfering RNA molecules (siRNAs) of 21-23 nucleotides. May also include amplification of the siRNA by RNA-directed RNA polymerase. |
3 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| O82188 | RDR5 | Probable RNA-dependent RNA polymerase 5 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| O82190 | RDR3 | Probable RNA-dependent RNA polymerase 3 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9SG02 | RDR6 | RNA-dependent RNA polymerase 6 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MMTTTMDYNS | SDQGFSWSEI | ALLGSVETML | EKVYGKHNHH | PPIKVETRRR | LSSISEELAL |
| 70 | 80 | 90 | 100 | 110 | 120 |
| ETLRKVLNMP | NVKTLDGIII | YFLNDAVTVD | GSPRLWSGES | PVQFPRTPGK | KSCRASQAEV |
| 130 | 140 | 150 | 160 | 170 | 180 |
| SLDREDPSPK | FLRGDENGES | KHISLLLALG | ELEFKKAFLL | LTYLGGKSLG | EVISGDEIRQ |
| 190 | 200 | 210 | 220 | 230 | 240 |
| WKDLPMVAYE | RAVWFKLGQN | EERMQLESDS | GKTHYYQCHV | APDGSYRLKG | YFLENTGTHL |
| 250 | 260 | 270 | 280 | 290 | 300 |
| HKVLGDDNVL | TVRFDQLPKE | STYCDNPYSK | YKEIAKNGIM | VGLRRYQFFV | FKDGGKAEKK |
| 310 | 320 | 330 | 340 | 350 | 360 |
| KRNSTKQVKC | YFIRTGSTAS | SDMENPYILS | GMSIHEARMH | FMHVHTLPSP | ANYMARFSLI |
| 370 | 380 | 390 | 400 | 410 | 420 |
| LSKTKKLEVD | MTEITVMQID | DIHCHDQSNN | DVLDKNGKPR | IHSDGTGYIS | EDLARMCPLN |
| 430 | 440 | 450 | 460 | 470 | 480 |
| IFKGKSMRSN | NIQGTCVQEP | PLLIQIRMFN | DGSAVKGIFL | LNKNLPPQTV | QVRPSMIKVY |
| 490 | 500 | 510 | 520 | 530 | 540 |
| KDKNLSNFST | FNSLEVVTTS | NPPKRAKLSK | NLVALLSYGG | VPNDFFLDIL | LNTLEKKKTI |
| 550 | 560 | 570 | 580 | 590 | 600 |
| FFKVRAAGKA | ALHYGNMDDK | NALQMIMAGI | PLDEPYLKHY | LSKLLKLEKD | DLKAGKLPID |
| 610 | 620 | 630 | 640 | 650 | 660 |
| ESYYLMGTVD | PTGELKEDEV | SGLAKSQDVL | VYRNPGLHFG | DIHILKATYV | KSLEQYVGNS |
| 670 | 680 | 690 | 700 | 710 | 720 |
| KYGVFFPQKG | PRSLGDEIAG | GDFDGDMYFI | SRNPKLLEHY | KPSEPWVSSS | PRSKIYTGRQ |
| 730 | 740 | 750 | 760 | 770 | 780 |
| PSELSPEQLE | EELFKIFLKT | GFSPSSVIGQ | AADSWLAIMD | RFLTLGDENV | KEKAEMKKKM |
| 790 | 800 | 810 | 820 | 830 | 840 |
| LKLTDIYYDA | IDAPKTGTEV | NLPLDVKVDL | FPHYMERNKT | FKSTSILGLI | FDTVDFHNAE |
| 850 | 860 | 870 | 880 | 890 | 900 |
| DTTPSGISKL | QCFEDEPVSE | FDMEKCKLWH | KDYRKEMCQA | MNSDDDDSCN | EVIQKYKQEF |
| 910 | 920 | ||||
| YSAAGFKESK | KILEELYPKA | LALYNVT |