O43529
Gene name |
CHST10 |
Protein name |
Carbohydrate sulfotransferase 10 |
Names |
HNK-1 sulfotransferase, HNK-1ST, HNK1ST, HuHNK-1ST |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:9486 |
EC number |
|
Protein Class |
|
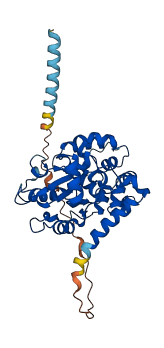
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for O43529
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-O43529-F1 | Predicted | AlphaFoldDB |
280 variants for O43529
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
rs1189220921 CA347891500 |
5 | W>R | No |
ClinGen gnomAD |
|
|
CA52776826 rs755103813 |
8 | L>V | No |
ClinGen ExAC TOPMed |
|
|
CA1802533 rs756692966 |
9 | A>D | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA1802534 rs754256067 |
9 | A>T | No |
ClinGen ExAC |
|
|
rs756692966 CA1802532 |
9 | A>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA1802529 rs150069978 |
10 | A>S | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA1802528 rs150069978 |
10 | A>T | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1356117857 CA347891184 |
11 | C>Y | No |
ClinGen gnomAD |
|
|
rs552799825 CA1802525 |
13 | W>C | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs868015961 CA52776805 |
19 | M>L | No |
ClinGen Ensembl |
|
|
CA1802523 VAR_033737 rs35177621 |
20 | V>L | No |
ClinGen UniProt 1000Genomes ESP ExAC TOPMed dbSNP gnomAD |
|
|
rs141878987 CA1802522 |
23 | K>R | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA1802521 rs141878987 |
23 | K>T | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
COSM199593 rs148953500 CA1802520 |
26 | T>M | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ESP ExAC NCI-TCGA TOPMed gnomAD |
|
CA1802518 rs768959364 |
28 | T>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1457797450 CA347890828 |
31 | D>G | No |
ClinGen TOPMed |
|
|
rs780525416 CA1802516 |
32 | P>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1363223121 CA347890804 |
33 | D>N | No |
ClinGen TOPMed |
|
|
CA1802499 rs138889445 |
34 | V>A | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs968139298 CA52774732 |
36 | S>G | No |
ClinGen gnomAD |
|
|
rs1281612874 CA347890313 |
40 | E>D | No |
ClinGen gnomAD |
|
|
rs1218768016 CA347890311 |
41 | F>L | No |
ClinGen gnomAD |
|
|
rs1218768016 CA347890306 |
41 | F>V | No |
ClinGen gnomAD |
|
| TCGA novel | 42 | L>M | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA52774715 rs573528014 |
44 | L>V | No |
ClinGen Ensembl |
|
|
CA347890273 rs1262546544 |
45 | T>K | No |
ClinGen TOPMed |
|
| TCGA novel | 47 | M>P | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA1802493 rs781657019 |
48 | P>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs554773227 CA1802494 |
48 | P>S | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs1427539508 CA347890241 |
50 | V>E | No |
ClinGen gnomAD |
|
|
rs1399289278 CA347890242 |
50 | V>M | No |
ClinGen gnomAD |
|
|
CA52774685 rs985446230 |
52 | K>E | No |
ClinGen Ensembl |
|
|
CA1802491 rs372598930 |
52 | K>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA347890228 rs372598930 |
52 | K>T | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
| TCGA novel | 55 | E>* | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA347890191 rs1174890219 |
57 | K>M | No |
ClinGen gnomAD |
|
|
rs1426614747 CA347890176 |
59 | I>T | No |
ClinGen gnomAD |
|
|
CA347890170 rs1558639626 |
60 | P>L | No |
ClinGen Ensembl |
|
|
rs1193451216 CA347890167 |
61 | E>K | No |
ClinGen gnomAD |
|
|
rs529604599 CA1802472 |
67 | G>E | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA1802473 rs778152141 |
67 | G>W | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA347889936 rs1400944435 |
68 | K>* | No |
ClinGen TOPMed gnomAD |
|
|
CA347889886 rs142086595 |
71 | P>A | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs142086595 CA1802471 |
71 | P>S | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs779581569 CA1802470 |
72 | D>G | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 73 | S>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA347889819 rs1292644185 |
74 | Q>* | No |
ClinGen TOPMed |
|
|
rs755810122 CA1802468 |
74 | Q>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA1802465 rs781030834 |
75 | L>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs751310530 CA1802463 |
76 | V>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA52772227 rs754052066 |
78 | P>H | No |
ClinGen Ensembl |
|
|
CA347889737 COSM1613225 rs1367089630 |
79 | L>M | liver [Cosmic] | No |
ClinGen cosmic curated TOPMed gnomAD |
|
CA347889734 rs1367089630 |
79 | L>V | No |
ClinGen TOPMed gnomAD |
|
|
CA347889720 rs1164595847 |
80 | V>I | No |
ClinGen gnomAD |
|
|
rs1558635972 CA347889696 |
81 | Y>C | No |
ClinGen Ensembl |
|
|
rs763960184 CA1802462 |
82 | M>V | No |
ClinGen ExAC |
|
|
rs762908706 CA1802461 |
84 | R>C | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
rs765386819 COSM1248308 CA1802459 |
84 | R>H | oesophagus [Cosmic] | No |
ClinGen cosmic curated ExAC TOPMed gnomAD |
|
rs765386819 CA1802460 |
84 | R>L | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 86 | E>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1252213688 CA347889586 |
88 | I>L | No |
ClinGen TOPMed |
|
|
CA52772214 rs761061912 |
88 | I>T | No |
ClinGen TOPMed gnomAD |
|
|
CA1802456 rs148626049 |
90 | N>K | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA1802454 rs773580875 |
91 | V>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs572773940 COSM294246 CA52772189 |
92 | C>F | large_intestine [Cosmic] | No |
ClinGen cosmic curated TOPMed gnomAD |
|
rs1323266268 CA347889508 |
94 | D>G | No |
ClinGen gnomAD |
|
|
CA347889512 rs1245322908 |
94 | D>N | No |
ClinGen gnomAD |
|
|
CA347889464 rs1299421666 |
100 | L>H | No |
ClinGen gnomAD |
|
|
CA1802451 rs376278671 |
100 | L>V | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA347889456 rs1389279650 COSM1398393 |
101 | S>L | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated NCI-TCGA gnomAD |
|
rs1431197504 CA347889442 |
103 | T>I | No |
ClinGen TOPMed |
|
|
CA347889438 rs199997717 |
104 | P>H | No |
ClinGen ExAC gnomAD |
|
|
CA1802446 rs199997717 |
104 | P>R | No |
ClinGen ExAC gnomAD |
|
|
rs756854215 CA1802447 |
104 | P>S | No |
ClinGen ExAC gnomAD |
|
|
rs540545598 CA1802444 |
107 | K>R | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs540545598 CA1802443 |
107 | K>T | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs373432767 CA1802442 |
111 | D>N | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA1802441 rs755116325 |
112 | R>* | No |
ClinGen ExAC gnomAD |
|
|
rs753914854 CA1802440 |
112 | R>Q | No |
ClinGen ExAC gnomAD |
|
|
rs1441925232 CA347889389 |
113 | I>V | No |
ClinGen TOPMed |
|
|
CA347889375 rs1381904592 |
115 | V>I | No |
ClinGen TOPMed |
|
|
CA1802439 rs181915976 |
117 | D>E | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1489351400 CA347889342 |
119 | H>R | No |
ClinGen gnomAD |
|
|
CA347889323 rs1573177099 |
122 | L>I | No |
ClinGen Ensembl |
|
|
CA347889299 rs1255851037 |
125 | Q>* | No |
ClinGen gnomAD |
|
|
CA52772099 rs972220063 |
126 | T>S | No |
ClinGen Ensembl |
|
|
rs1197626514 CA347889279 |
128 | K>T | No |
ClinGen gnomAD |
|
|
CA347889270 rs1573177054 |
129 | V>A | No |
ClinGen Ensembl |
|
|
rs760916749 CA1802438 |
130 | G>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
COSM1631215 rs1329970478 CA347889264 |
130 | G>V | liver [Cosmic] | No |
ClinGen cosmic curated gnomAD |
|
rs772377348 CA52772095 |
133 | Q>P | No |
ClinGen Ensembl |
|
|
rs1373666337 CA347889236 |
134 | W>* | No |
ClinGen gnomAD |
|
|
rs767907084 CA1802436 |
137 | V>L | No |
ClinGen ExAC gnomAD |
|
|
CA1802435 rs762290078 |
140 | V>I | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 141 | L>I | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA347889186 rs1173072291 |
142 | N>S | No |
ClinGen gnomAD |
|
|
rs748002148 CA1802401 |
144 | A>T | No |
ClinGen ExAC gnomAD |
|
|
CA347889157 rs1416755743 |
145 | F>Y | No |
ClinGen gnomAD |
|
|
CA1802400 rs57227647 |
146 | S>P | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs755010421 CA1802399 |
147 | S>Y | No |
ClinGen ExAC gnomAD |
|
|
CA347889126 rs780346361 |
150 | E>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA1802397 rs780346361 |
150 | E>K | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs750410768 CA1802395 |
152 | P>A | No |
ClinGen ExAC gnomAD |
|
|
CA52770855 rs1046876078 |
153 | E>G | No |
ClinGen TOPMed |
|
|
rs751960457 CA1802392 |
153 | E>K | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA347889095 rs1487033030 |
154 | N>K | No |
ClinGen TOPMed gnomAD |
|
|
rs200714829 CA1802391 |
155 | V>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs763509717 CA1802390 |
156 | V>L | No |
ClinGen ExAC gnomAD |
|
|
rs1488938780 CA347889084 |
157 | H>N | No |
ClinGen gnomAD |
|
| TCGA novel | 157 | H>Y | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs776607661 CA347889076 |
158 | D>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs776607661 CA1802388 |
158 | D>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs371551507 CA1802386 |
160 | E>K | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1235326247 CA347889046 |
162 | N>H | No |
ClinGen gnomAD |
|
|
rs1338524866 CA347889043 |
162 | N>T | No |
ClinGen gnomAD |
|
|
CA1802384 rs761530156 |
163 | G>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA347889024 rs1321472978 |
165 | P>L | No |
ClinGen gnomAD |
|
|
CA347889025 rs1224049249 |
165 | P>S | No |
ClinGen TOPMed |
|
|
rs1404598687 CA347889021 |
166 | R>G | No |
ClinGen TOPMed gnomAD |
|
|
CA347889018 rs1391116591 |
166 | R>P | No |
ClinGen gnomAD |
|
|
CA347889020 rs1404598687 |
166 | R>W | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA TOPMed gnomAD |
|
rs776213016 CA52770818 |
167 | L>P | No |
ClinGen Ensembl |
|
|
CA1802381 rs749021703 |
169 | S>F | No |
ClinGen ExAC gnomAD |
|
|
CA52770797 rs915054278 |
171 | S>G | No |
ClinGen TOPMed |
|
|
CA1802378 rs141419211 |
172 | D>E | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs745990434 CA1802377 |
173 | A>T | No |
ClinGen ExAC gnomAD |
|
|
CA1802376 rs182652002 |
173 | A>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
| TCGA novel | 174 | E>D | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1198753092 CA347888919 |
174 | E>G | No |
ClinGen TOPMed |
|
|
CA1802375 rs757548653 |
174 | E>Q | No |
ClinGen ExAC gnomAD |
|
|
rs1573172342 CA347888871 |
176 | Q>R | No |
ClinGen Ensembl |
|
|
rs751768449 CA1802374 |
178 | R>* | No |
ClinGen ExAC gnomAD |
|
|
rs146601037 CA1802373 |
178 | R>Q | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1573168665 CA347896548 |
179 | L>F | No |
ClinGen Ensembl |
|
|
CA347896554 rs756837256 |
179 | L>M | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 181 | T>A | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs546199705 CA1802343 |
182 | Y>F | No |
ClinGen 1000Genomes ExAC |
|
|
rs1486029206 CA347896505 |
185 | F>C | No |
ClinGen TOPMed gnomAD |
|
| TCGA novel | 185 | F>L | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1486029206 CA347896506 |
185 | F>S | No |
ClinGen TOPMed gnomAD |
|
|
rs138468060 CA1802341 |
186 | F>Y | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs368455898 CA1802340 |
190 | D>H | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA52811888 rs973733383 |
190 | D>V | No |
ClinGen TOPMed |
|
|
rs368455898 CA347896474 COSM289665 |
190 | D>Y | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ESP ExAC NCI-TCGA TOPMed gnomAD |
|
rs764927277 CA1802339 COSM297559 |
193 | E>K | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ExAC NCI-TCGA TOPMed gnomAD |
|
CA52811881 rs945574036 |
195 | L>P | No |
ClinGen TOPMed |
|
| TCGA novel | 197 | S>F | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA347896421 rs1225246350 |
198 | A>S | No |
ClinGen gnomAD |
|
|
CA347896405 rs1301867648 |
200 | K>R | No |
ClinGen TOPMed gnomAD |
|
| TCGA novel | 201 | D>E | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA347896397 rs1182308440 |
201 | D>G | No |
ClinGen TOPMed |
|
|
rs532803480 CA52811855 |
204 | V>F | No |
ClinGen 1000Genomes |
|
|
CA1802337 rs368177057 |
205 | H>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs770799123 CA1802336 |
206 | N>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs773239496 CA1802334 |
208 | R>L | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
CA347896350 rs773239496 COSM1201145 |
208 | R>Q | large_intestine Variant assessed as Somatic; impact. [Cosmic, NCI-TCGA] | No |
ClinGen cosmic curated ExAC NCI-TCGA TOPMed gnomAD |
|
CA1802335 rs747117122 |
208 | R>W | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1160378464 CA347896346 |
209 | F>S | No |
ClinGen gnomAD |
|
|
CA1802333 rs772324034 |
209 | F>V | No |
ClinGen ExAC gnomAD |
|
|
rs1035002511 CA52811825 |
212 | W>C | No |
ClinGen gnomAD |
|
|
CA347896316 rs1411961614 |
213 | Y>C | No |
ClinGen gnomAD |
|
|
CA52811816 rs781340202 |
215 | H>Q | No |
ClinGen Ensembl |
|
|
rs1475595842 CA347896290 |
217 | I>L | No |
ClinGen gnomAD |
|
|
CA347896281 rs1401968904 |
218 | A>S | No |
ClinGen TOPMed |
|
|
CA1802330 rs12476171 |
225 | Y>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA52811801 rs12476171 |
225 | Y>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA347896230 rs1487955853 |
226 | R>G | No |
ClinGen gnomAD |
|
|
rs201432165 CA1802329 |
227 | R>K | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA347896211 rs780726705 |
228 | N>K | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA347896213 rs1217726797 |
228 | N>S | No |
ClinGen gnomAD |
|
|
rs751154094 CA1802326 COSM1201144 |
229 | R>Q | large_intestine [Cosmic] | No |
ClinGen cosmic curated ExAC gnomAD |
|
COSM199587 rs756646964 CA1802327 |
229 | R>W | lung Variant assessed as Somatic; 0.0 impact. large_intestine [Cosmic, NCI-TCGA] | No |
ClinGen cosmic curated ExAC NCI-TCGA TOPMed gnomAD |
|
CA347896206 rs1356817954 |
230 | T>A | No |
ClinGen gnomAD |
|
|
rs1398831352 CA347896196 |
231 | E>G | No |
ClinGen gnomAD |
|
|
CA347896200 rs1286401241 |
231 | E>K | No |
ClinGen TOPMed |
|
|
rs149656297 CA1802325 |
232 | T>I | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ESP ExAC NCI-TCGA TOPMed gnomAD |
|
rs201758367 CA1802322 |
233 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA347896161 rs1488428014 |
237 | F>L | No |
ClinGen gnomAD |
|
|
rs759265127 CA347896148 |
238 | E>D | No |
ClinGen ExAC gnomAD |
|
|
rs1475626339 CA347896134 |
240 | F>C | No |
ClinGen gnomAD |
|
|
CA347896137 rs937651746 |
240 | F>I | No |
ClinGen TOPMed gnomAD |
|
|
rs937651746 CA52811774 |
240 | F>V | No |
ClinGen TOPMed gnomAD |
|
|
COSM3721255 CA52811773 rs926287034 |
241 | V>M | upper_aerodigestive_tract [Cosmic] | No |
ClinGen cosmic curated TOPMed gnomAD |
|
COSM1004462 rs144032903 CA1802319 |
242 | R>C | Variant assessed as Somatic; 0.0 impact. endometrium [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ESP ExAC NCI-TCGA TOPMed gnomAD |
|
rs760578039 CA1802318 |
242 | R>H | No |
ClinGen ExAC gnomAD |
|
|
rs760578039 CA52811756 |
242 | R>L | No |
ClinGen ExAC gnomAD |
|
|
rs1188147728 CA347896120 |
243 | Y>C | No |
ClinGen TOPMed gnomAD |
|
|
CA1802315 rs748188413 |
245 | G>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA1802313 rs768871548 |
246 | D>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1316111773 CA347896097 |
247 | P>A | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA gnomAD |
|
CA1802312 rs374730803 COSM715001 |
247 | P>L | lung [Cosmic] | No |
ClinGen cosmic curated ESP ExAC TOPMed gnomAD |
|
rs770471547 CA1802310 |
251 | W>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
TCGA novel CA347896069 rs1345121814 |
251 | W>R | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
NCI-TCGA ClinGen TOPMed gnomAD |
|
rs1001050979 CA52811627 |
252 | L>P | No |
ClinGen TOPMed gnomAD |
|
|
CA1802308 rs777492199 |
257 | G>E | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA52811611 rs3748932 VAR_021470 |
258 | D>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
ClinGen UniProt NCI-TCGA TOPMed dbSNP gnomAD |
|
rs3748932 CA52811596 |
258 | D>Y | No |
ClinGen TOPMed gnomAD |
|
|
rs896648232 CA52811591 |
261 | I>V | No |
ClinGen TOPMed |
|
|
CA347895984 rs1438001669 |
263 | W>* | No |
ClinGen Ensembl |
|
|
rs1465186447 CA347895981 |
263 | W>C | No |
ClinGen gnomAD |
|
|
rs752195490 COSM1196203 CA1802306 |
265 | T>M | lung [Cosmic] | No |
ClinGen cosmic curated ExAC TOPMed gnomAD |
|
rs1431310724 CA347895959 |
267 | V>I | No |
ClinGen gnomAD |
|
|
CA1802303 rs753676063 |
270 | C>S | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
rs753676063 CA1802304 |
270 | C>Y | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs937769970 CA52811575 |
273 | C>F | No |
ClinGen TOPMed |
|
|
CA347895913 rs1370946560 |
274 | E>K | No |
ClinGen TOPMed |
|
|
rs200734208 CA1802299 |
276 | M>I | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs750360245 CA1802301 |
276 | M>K | No |
ClinGen ExAC gnomAD |
|
|
CA1802300 rs750360245 |
276 | M>T | No |
ClinGen ExAC gnomAD |
|
|
rs774446300 CA1802297 |
280 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs768798605 CA1802296 |
282 | H>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1038070161 CA52811544 |
282 | H>Q | No |
ClinGen TOPMed |
|
|
CA347895845 COSM1168891 rs570679582 |
284 | E>K | pancreas [Cosmic] | No |
ClinGen cosmic curated 1000Genomes gnomAD |
|
CA52811537 rs570679582 |
284 | E>Q | No |
ClinGen 1000Genomes gnomAD |
|
|
CA1802295 rs763210815 |
285 | T>N | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 286 | L>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA1802293 rs770277532 |
288 | D>Y | No |
ClinGen ExAC gnomAD |
|
|
CA1802291 rs781679368 |
289 | D>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA1802289 rs747722795 |
291 | P>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA347895796 rs1377038268 |
291 | P>L | No |
ClinGen gnomAD |
|
|
CA52811469 rs371045606 |
298 | G>D | No |
ClinGen ESP TOPMed |
|
|
CA52811464 rs371045606 |
298 | G>V | No |
ClinGen ESP TOPMed |
|
|
rs1317940951 CA347895746 |
299 | I>V | No |
ClinGen TOPMed |
|
|
CA347895737 rs1573167546 |
300 | D>A | No |
ClinGen Ensembl |
|
|
CA347895726 rs1303948313 |
301 | H>Q | No |
ClinGen TOPMed |
|
|
CA1802287 rs376357045 |
301 | H>Y | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs753355704 CA1802286 |
302 | L>V | No |
ClinGen ExAC gnomAD |
|
|
CA1802285 rs147076164 |
303 | V>A | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs147076164 CA347895718 |
303 | V>G | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA347895719 rs1346876488 |
303 | V>L | No |
ClinGen TOPMed |
|
|
CA347895706 rs1573167437 |
305 | Y>S | No |
ClinGen Ensembl |
|
|
CA347895698 rs1259033013 |
306 | P>L | No |
ClinGen TOPMed |
|
|
rs988936126 CA52811430 |
306 | P>S | No |
ClinGen TOPMed |
|
|
CA347895694 rs1193873922 |
307 | T>S | No |
ClinGen TOPMed |
|
| TCGA novel | 308 | I>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1254028803 CA347895687 |
308 | I>S | No |
ClinGen TOPMed |
|
|
rs761702531 CA1802281 |
308 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs751685534 CA1802280 |
309 | P>L | No |
ClinGen ExAC TOPMed |
|
|
COSM1564887 CA1802278 rs367887748 |
310 | P>L | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ESP ExAC NCI-TCGA TOPMed gnomAD |
|
rs367887748 CA1802279 |
310 | P>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs770056570 CA1802276 |
311 | G>C | No |
ClinGen ExAC gnomAD |
|
|
rs760096775 CA1802275 |
312 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs140261702 CA1802273 |
314 | V>M | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA347895638 rs1313416579 |
317 | R>G | No |
ClinGen TOPMed gnomAD |
|
|
CA347895634 rs1326750572 |
317 | R>I | No |
ClinGen TOPMed |
|
|
CA347895630 rs1436447963 |
318 | T>A | No |
ClinGen gnomAD |
|
|
CA1802269 rs749002484 |
321 | E>G | No |
ClinGen ExAC gnomAD |
|
|
CA1802270 rs768356262 |
321 | E>K | No |
ClinGen ExAC gnomAD |
|
|
rs1017563783 CA52811350 |
322 | H>P | No |
ClinGen Ensembl |
|
|
CA347895594 rs1306760329 |
323 | Y>C | No |
ClinGen gnomAD |
|
|
CA347895590 rs1445165473 |
324 | F>I | No |
ClinGen gnomAD |
|
|
CA347895580 rs779521249 |
325 | L>P | No |
ClinGen ExAC gnomAD |
|
|
rs779521249 CA1802268 |
325 | L>Q | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 326 | G>C | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
| TCGA novel | 327 | I>M | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1184896374 CA347895565 |
328 | S>G | No |
ClinGen gnomAD |
|
|
CA347895548 rs1257524758 |
330 | R>* | No |
ClinGen TOPMed gnomAD |
|
|
rs139810982 CA1802266 |
330 | R>Q | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs745767409 CA1802265 |
331 | D>N | No |
ClinGen ExAC gnomAD |
|
|
rs370119165 CA1802264 |
333 | R>* | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ESP ExAC NCI-TCGA TOPMed gnomAD |
|
CA1802263 rs756945972 |
333 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
COSM1248306 rs751375820 CA1802262 |
334 | R>C | oesophagus [Cosmic] | No |
ClinGen cosmic curated ExAC TOPMed gnomAD |
|
CA1802261 rs763862335 |
334 | R>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1400954474 CA347895517 |
336 | Y>C | No |
ClinGen gnomAD |
|
|
rs1009779887 CA52811314 |
336 | Y>N | No |
ClinGen TOPMed |
|
|
rs759718164 CA1802258 |
338 | R>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA1802256 rs143836571 |
338 | R>H | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs759718164 CA1802257 |
338 | R>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs147487716 COSM199586 CA1802254 |
340 | E>K | large_intestine [Cosmic] | No |
ClinGen cosmic curated 1000Genomes ESP ExAC TOPMed gnomAD |
|
rs773617693 CA1802253 |
343 | F>L | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 343 | F>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA347895466 rs1347542080 |
344 | K>E | No |
ClinGen TOPMed |
|
|
CA347895457 rs1401096800 |
345 | L>F | No |
ClinGen gnomAD |
|
|
rs1161098717 CA347895453 |
346 | F>L | No |
ClinGen TOPMed gnomAD |
|
|
rs1460540019 CA347895442 |
347 | G>E | No |
ClinGen TOPMed gnomAD |
|
|
CA347895435 rs1299729126 |
348 | Y>C | No |
ClinGen TOPMed |
|
|
rs748912268 CA1802251 |
349 | Q>E | No |
ClinGen ExAC |
|
|
CA1802250 rs561240441 |
349 | Q>R | No |
ClinGen 1000Genomes ExAC TOPMed |
|
|
rs1189522578 CA347895413 |
351 | P>R | No |
ClinGen gnomAD |
|
|
CA347895409 rs1476535617 |
352 | D>H | No |
ClinGen gnomAD |
No associated diseases with O43529
No regional properties for O43529
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| No domain, repeats, and functional sites for O43529 | |||
4 GO annotations of cellular component
| Name | Definition |
|---|---|
| Golgi apparatus | A membrane-bound cytoplasmic organelle of the endomembrane system that further processes the core oligosaccharides (e.g. N-glycans) added to proteins in the endoplasmic reticulum and packages them into membrane-bound vesicles. The Golgi apparatus operates at the intersection of the secretory, lysosomal, and endocytic pathways. |
| Golgi membrane | The lipid bilayer surrounding any of the compartments of the Golgi apparatus. |
| integral component of membrane | The component of a membrane consisting of the gene products and protein complexes having at least some part of their peptide sequence embedded in the hydrophobic region of the membrane. |
| membrane | A lipid bilayer along with all the proteins and protein complexes embedded in it an attached to it. |
2 GO annotations of molecular function
| Name | Definition |
|---|---|
| HNK-1 sulfotransferase activity | Catalysis of the synthesis of the HKK-1 carbohydrate epitope; adds a sulfate group to a precursor, GlcA-beta-(1->3)-Gal-beta-(1->4)-GlcNAc-beta-(1->R), forming sulfo-3GlcA-beta-(1->3)-Gal-beta-(1->4)-GlcNAc-beta-(1->R). |
| sulfotransferase activity | Catalysis of the transfer of a sulfate group from 3'-phosphoadenosine 5'-phosphosulfate to the hydroxyl group of an acceptor, producing the sulfated derivative and 3'-phosphoadenosine 5'-phosphate. |
7 GO annotations of biological process
| Name | Definition |
|---|---|
| androgen metabolic process | The chemical reactions and pathways involving androgens, C19 steroid hormones that can stimulate the development of male sexual characteristics. |
| carbohydrate biosynthetic process | The chemical reactions and pathways resulting in the formation of carbohydrates, any of a group of organic compounds based of the general formula Cx(H2O)y. |
| cell adhesion | The attachment of a cell, either to another cell or to an underlying substrate such as the extracellular matrix, via cell adhesion molecules. |
| estrogen metabolic process | The chemical reactions and pathways involving estrogens, C18 steroid hormones that can stimulate the development of female sexual characteristics. Also found in plants. |
| learning | Any process in an organism in which a relatively long-lasting adaptive behavioral change occurs as the result of experience. |
| long-term memory | The memory process that deals with the storage, retrieval and modification of information a long time (typically weeks, months or years) after receiving that information. This type of memory is typically dependent on gene transcription regulated by second messenger activation. |
| proteoglycan biosynthetic process | The chemical reactions and pathways resulting in the formation of proteoglycans, any glycoprotein in which the carbohydrate units are glycosaminoglycans. |
4 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| Q9NRB3 | CHST12 | Carbohydrate sulfotransferase 12 | Homo sapiens (Human) | PR |
| Q6PGK7 | Chst10 | Carbohydrate sulfotransferase 10 | Mus musculus (Mouse) | PR |
| O54702 | Chst10 | Carbohydrate sulfotransferase 10 | Rattus norvegicus (Rat) | PR |
| Q6AXM1 | chst10 | Carbohydrate sulfotransferase 10 | Danio rerio (Zebrafish) (Brachydanio rerio) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MHHQWLLLAA | CFWVIFMFMV | ASKFITLTFK | DPDVYSAKQE | FLFLTTMPEV | RKLPEEKHIP |
| 70 | 80 | 90 | 100 | 110 | 120 |
| EELKPTGKEL | PDSQLVQPLV | YMERLELIRN | VCRDDALKNL | SHTPVSKFVL | DRIFVCDKHK |
| 130 | 140 | 150 | 160 | 170 | 180 |
| ILFCQTPKVG | NTQWKKVLIV | LNGAFSSIEE | IPENVVHDHE | KNGLPRLSSF | SDAEIQKRLK |
| 190 | 200 | 210 | 220 | 230 | 240 |
| TYFKFFIVRD | PFERLISAFK | DKFVHNPRFE | PWYRHEIAPG | IIRKYRRNRT | ETRGIQFEDF |
| 250 | 260 | 270 | 280 | 290 | 300 |
| VRYLGDPNHR | WLDLQFGDHI | IHWVTYVELC | APCEIMYSVI | GHHETLEDDA | PYILKEAGID |
| 310 | 320 | 330 | 340 | 350 | |
| HLVSYPTIPP | GITVYNRTKV | EHYFLGISKR | DIRRLYARFE | GDFKLFGYQK | PDFLLN |