A8MW95
Gene name |
BECN2 |
Protein name |
Beclin-2 |
Names |
Beclin-1 autophagy-related pseudogene 1, Beclin-1-like protein 1 |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:441925 |
EC number |
|
Protein Class |
|
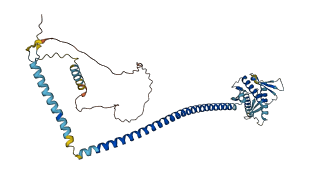
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
5 structures for A8MW95
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| 5K7B | X-ray | 230 A | A/B/C/D | 158-250 | PDB |
| 5K9L | X-ray | 252 A | A/B/C/D | 158-250 | PDB |
| 8GT9 | X-ray | 200 A | A/B/C/D | 157-248 | PDB |
| 8GU7 | X-ray | 260 A | C/D | 157-248 | PDB |
| AF-A8MW95-F1 | Predicted | AlphaFoldDB |
234 variants for A8MW95
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
CA40419282 rs1022965619 |
5 | R>H | No |
ClinGen TOPMed gnomAD |
|
|
rs1409415141 CA424081228 |
8 | C>Y | No |
ClinGen TOPMed |
|
|
rs774258195 CA40419287 |
10 | R>H | No |
ClinGen TOPMed gnomAD |
|
|
CA424081253 rs1574223126 |
11 | C>G | No |
ClinGen Ensembl |
|
|
CA40419291 rs537874120 |
12 | H>Y | No |
ClinGen 1000Genomes |
|
|
rs969447773 CA40419294 |
13 | Q>K | No |
ClinGen TOPMed gnomAD |
|
|
CA40419297 rs981186254 |
16 | K>R | No |
ClinGen TOPMed gnomAD |
|
|
CA424081318 rs927944662 |
18 | S>R | No |
ClinGen TOPMed |
|
|
rs879497481 CA40419306 |
22 | E>* | No |
ClinGen Ensembl |
|
|
rs1180472108 CA424081355 |
23 | S>P | No |
ClinGen TOPMed |
|
|
rs990320598 CA40419319 |
24 | R>G | No |
ClinGen TOPMed |
|
|
CA40419323 rs960794859 |
24 | R>S | No |
ClinGen TOPMed |
|
|
rs914210228 CA40419328 |
26 | L>P | No |
ClinGen TOPMed |
|
|
rs1322601298 CA424081410 |
29 | A>V | No |
ClinGen TOPMed |
|
|
CA40419334 rs554618230 |
32 | P>L | No |
ClinGen 1000Genomes |
|
|
CA424081449 rs1220693675 |
34 | S>T | No |
ClinGen TOPMed |
|
|
CA40419335 rs568331052 |
37 | A>P | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
rs568331052 CA40419336 |
37 | A>S | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
rs568331052 CA424081476 |
37 | A>T | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA424081487 rs1333660347 |
38 | E>K | No |
ClinGen TOPMed |
|
|
rs941196619 CA40419338 |
51 | E>Q | No |
ClinGen TOPMed |
|
|
CA424081626 rs1574223159 |
53 | T>P | No |
ClinGen Ensembl |
|
|
CA40419344 rs1038285969 |
55 | A>T | No |
ClinGen TOPMed |
|
|
rs1416453161 CA424081647 |
55 | A>V | No |
ClinGen TOPMed |
|
|
rs921189105 CA40419346 |
56 | E>D | No |
ClinGen gnomAD |
|
|
CA424081659 rs1406440533 |
57 | E>K | No |
ClinGen TOPMed |
|
|
rs1439845836 CA424081686 |
59 | Q>H | No |
ClinGen TOPMed |
|
|
CA424081694 rs932547309 |
60 | D>E | No |
ClinGen TOPMed |
|
|
CA424081700 rs1181424118 |
61 | G>D | No |
ClinGen TOPMed |
|
|
rs1237624309 CA424081716 |
63 | S>P | No |
ClinGen TOPMed |
|
|
CA424081730 rs1212009890 |
64 | S>R | No |
ClinGen TOPMed |
|
|
CA424081735 rs1348641388 |
65 | R>G | No |
ClinGen gnomAD |
|
|
CA40419362 rs890768184 |
66 | S>Y | No |
ClinGen Ensembl |
|
|
CA40419371 rs527609990 |
71 | G>D | No |
ClinGen TOPMed |
|
|
CA40419374 rs527609990 |
71 | G>V | No |
ClinGen TOPMed |
|
|
CA40419377 rs998633463 |
74 | S>F | No |
ClinGen TOPMed gnomAD |
|
|
rs533846102 CA40419386 |
77 | H>R | No |
ClinGen 1000Genomes |
|
|
CA424081874 rs1243787267 |
78 | A>D | No |
ClinGen TOPMed |
|
|
CA40419390 rs892676956 |
80 | I>F | No |
ClinGen Ensembl |
|
|
rs1574223197 CA424081911 |
82 | T>P | No |
ClinGen Ensembl |
|
|
CA424081938 rs1450694074 |
85 | G>R | No |
ClinGen TOPMed |
|
|
rs1420825125 CA424081954 |
86 | E>G | No |
ClinGen TOPMed |
|
|
rs1318322477 CA424081949 |
86 | E>K | No |
ClinGen TOPMed |
|
|
CA424081972 rs1452086620 |
88 | G>D | No |
ClinGen gnomAD |
|
|
rs553890054 CA40419403 |
89 | A>T | No |
ClinGen 1000Genomes |
|
|
CA424082008 rs1212883935 |
92 | M>V | No |
ClinGen gnomAD |
|
|
CA424082017 rs1161134572 |
93 | L>F | No |
ClinGen TOPMed |
|
|
rs1443434758 CA424082026 |
94 | S>G | No |
ClinGen TOPMed |
|
|
CA424082079 rs1574223214 |
99 | A>E | No |
ClinGen Ensembl |
|
|
CA10862536 RCV000948243 rs61736147 |
103 | I>M | No |
ClinGen ClinVar 1000Genomes TOPMed dbSNP gnomAD |
|
|
CA40419424 rs970044937 |
103 | I>V | No |
ClinGen TOPMed |
|
|
rs762002404 CA40419438 |
106 | I>L | No |
ClinGen TOPMed |
|
|
CA40419439 rs762002404 |
106 | I>V | No |
ClinGen TOPMed |
|
|
rs1220380780 CA424082168 |
108 | S>F | No |
ClinGen TOPMed |
|
|
rs971332450 CA40419441 |
110 | Q>R | No |
ClinGen TOPMed |
|
|
CA40419444 rs960679517 |
113 | V>A | No |
ClinGen TOPMed |
|
|
rs1031478610 CA424082218 |
114 | D>A | No |
ClinGen TOPMed |
|
|
CA40419448 rs1031478610 |
114 | D>G | No |
ClinGen TOPMed |
|
|
rs1269991851 CA424082225 |
115 | H>Y | No |
ClinGen TOPMed |
|
|
CA40419461 rs865802770 |
116 | P>S | No |
ClinGen TOPMed |
|
|
CA40419464 rs956075680 |
118 | C>* | No |
ClinGen TOPMed |
|
|
CA40419472 rs914346484 |
118 | C>G | No |
ClinGen TOPMed |
|
|
CA424082262 rs1423502615 |
119 | E>D | No |
ClinGen TOPMed |
|
|
CA40419474 rs908626800 |
121 | C>* | No |
ClinGen TOPMed gnomAD |
|
|
rs750583860 CA40419473 |
121 | C>R | No |
ClinGen Ensembl |
|
|
CA424082284 rs1166549817 |
122 | T>N | No |
ClinGen TOPMed |
|
|
CA40419475 rs546258943 |
123 | D>N | No |
ClinGen 1000Genomes TOPMed |
|
|
CA424082327 rs1194158069 |
127 | E>A | No |
ClinGen TOPMed |
|
|
rs565246581 CA40419476 |
127 | E>Q | No |
ClinGen TOPMed gnomAD |
|
|
CA40419477 rs556275285 |
130 | D>G | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA424082360 rs1461348356 |
131 | I>V | No |
ClinGen gnomAD |
|
|
CA40419480 rs187014284 |
134 | A>T | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
rs541793731 CA40419485 |
137 | E>D | No |
ClinGen 1000Genomes TOPMed |
|
|
rs974317270 CA40419488 |
139 | D>N | No |
ClinGen TOPMed gnomAD |
|
|
rs1308111029 CA424082440 |
140 | S>N | No |
ClinGen Ensembl |
|
|
rs1305987120 CA424082468 |
143 | Y>C | No |
ClinGen TOPMed |
|
|
rs561751223 CA40419489 |
144 | Q>E | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA424082484 rs1219653554 |
145 | R>H | No |
ClinGen TOPMed |
|
|
rs1219653554 CA424082485 |
145 | R>P | No |
ClinGen TOPMed |
|
|
rs929465977 CA40419493 |
148 | E>Q | No |
ClinGen TOPMed |
|
|
CA40419512 rs527947465 CA40419498 |
150 | G>R | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA424082549 rs1574223272 |
153 | A>T | No |
ClinGen Ensembl |
|
|
rs1051007902 CA40419521 |
155 | S>R | No |
ClinGen TOPMed |
|
|
CA10795172 rs56335758 RCV000946579 |
158 | E>K | No |
ClinGen ClinVar 1000Genomes TOPMed dbSNP gnomAD |
|
|
CA424082636 rs1193021327 |
163 | R>G | No |
ClinGen TOPMed |
|
|
CA40419550 rs564698221 |
166 | L>P | No |
ClinGen 1000Genomes |
|
|
CA40419571 rs755412110 |
167 | R>P | No |
ClinGen TOPMed gnomAD |
|
|
rs755412110 CA424082671 |
167 | R>Q | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA TOPMed gnomAD |
|
rs955896440 CA40419568 |
167 | R>W | No |
ClinGen TOPMed gnomAD |
|
|
CA424082700 rs1261680746 |
170 | E>D | No |
ClinGen TOPMed |
|
|
rs1558168688 CA424082720 |
173 | E>K | No |
ClinGen Ensembl |
|
|
CA424082745 rs1303992291 |
175 | R>S | No |
ClinGen TOPMed |
|
|
rs1313331678 CA424082741 |
175 | R>T | No |
ClinGen TOPMed |
|
|
rs1574223305 CA424082761 |
177 | V>G | No |
ClinGen Ensembl |
|
|
CA40419575 rs953822151 |
184 | D>N | No |
ClinGen TOPMed |
|
|
rs781674335 CA40419579 |
184 | D>V | No |
ClinGen TOPMed |
|
|
rs752155053 CA40419586 |
185 | R>S | No |
ClinGen TOPMed gnomAD |
|
|
CA424082847 rs1466323620 |
187 | N>K | No |
ClinGen TOPMed |
|
|
rs1156808629 CA424082850 |
188 | A>T | No |
ClinGen TOPMed |
|
|
rs755547837 CA40419597 |
191 | A>E | No |
ClinGen TOPMed gnomAD |
|
|
rs755547837 CA424082881 |
191 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
CA424082884 rs1574223317 |
192 | A>T | No |
ClinGen Ensembl |
|
|
rs1002895011 CA40419625 |
193 | D>G | No |
ClinGen TOPMed |
|
|
rs1241489801 CA424082901 |
194 | L>I | No |
ClinGen TOPMed |
|
|
rs929480534 CA40419638 |
194 | L>P | No |
ClinGen TOPMed |
|
|
rs1483771809 CA424082913 |
195 | Q>R | No |
ClinGen TOPMed |
|
|
rs377410460 CA40419645 |
197 | A>S | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA40419641 rs377410460 |
197 | A>T | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA424082974 rs1163412511 |
202 | A>E | No |
ClinGen gnomAD |
|
|
rs1004179305 CA40419662 |
207 | Q>* | No |
ClinGen Ensembl |
|
|
CA40419663 rs568935999 |
209 | R>G | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
rs1466525994 CA424083040 |
210 | Q>K | No |
ClinGen gnomAD |
|
|
rs113658106 CA40419664 |
212 | Y>C | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA424083114 rs1574223335 |
215 | Y>* | No |
ClinGen Ensembl |
|
|
rs907164740 CA40419665 |
216 | S>N | No |
ClinGen TOPMed |
|
|
rs962788051 CA40419669 |
223 | L>R | No |
ClinGen TOPMed |
|
|
CA40419673 rs1053034798 |
228 | Q>H | No |
ClinGen TOPMed gnomAD |
|
|
rs1574223346 CA424083352 |
231 | N>D | No |
ClinGen Ensembl |
|
|
CA424083371 rs1361019965 |
232 | V>A | No |
ClinGen TOPMed |
|
|
CA40419679 rs777391854 |
232 | V>L | No |
ClinGen TOPMed gnomAD |
|
|
rs777391854 CA40419677 |
232 | V>M | No |
ClinGen TOPMed gnomAD |
|
|
rs1574223349 CA424083411 |
235 | Q>K | No |
ClinGen Ensembl |
|
|
CA424083453 rs1159362722 |
238 | Y>H | No |
ClinGen TOPMed |
|
|
CA40419691 rs548160937 |
240 | R>S | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
rs891736875 CA40419704 |
241 | V>G | No |
ClinGen TOPMed gnomAD |
|
|
CA424083517 rs1187070741 |
242 | Q>H | No |
ClinGen TOPMed |
|
|
RCV000946580 rs3851304 CA10795173 |
243 | R>M | No |
ClinGen ClinVar 1000Genomes TOPMed dbSNP gnomAD |
|
|
CA424083541 rs1258688528 |
244 | D>E | No |
ClinGen TOPMed |
|
|
rs1488252820 CA424083592 |
248 | E>G | No |
ClinGen TOPMed |
|
|
rs1574223362 CA424083652 |
253 | T>P | No |
ClinGen Ensembl |
|
|
rs1356611528 CA424083681 |
255 | T>K | No |
ClinGen TOPMed |
|
|
CA40419735 rs934529027 |
259 | W>G | No |
ClinGen Ensembl |
|
|
CA40419739 rs988477241 |
260 | V>A | No |
ClinGen TOPMed gnomAD |
|
|
CA40419737 rs374742846 |
260 | V>M | No |
ClinGen TOPMed gnomAD |
|
|
rs1342098716 CA424083762 |
261 | E>K | No |
ClinGen TOPMed |
|
|
CA424083800 rs1293186067 |
263 | P>H | No |
ClinGen TOPMed |
|
|
rs914214553 CA40419744 |
264 | L>W | No |
ClinGen TOPMed |
|
|
CA40419760 rs947135683 |
265 | G>D | No |
ClinGen Ensembl |
|
|
rs905401257 CA40419766 |
266 | V>A | No |
ClinGen Ensembl |
|
|
rs1421641008 CA424083857 |
267 | I>S | No |
ClinGen TOPMed |
|
|
rs1421641008 CA424083855 |
267 | I>T | No |
ClinGen TOPMed |
|
|
CA40419788 rs938187093 |
268 | N>S | No |
ClinGen TOPMed gnomAD |
|
|
CA40419795 CA40419794 rs896745939 |
272 | L>F | No |
ClinGen TOPMed gnomAD |
|
|
CA424083972 rs1477670855 |
274 | R>H | No |
ClinGen TOPMed |
|
|
CA424083973 rs1477670855 |
274 | R>L | No |
ClinGen TOPMed |
|
|
CA40419796 rs1004398758 |
275 | L>P | No |
ClinGen TOPMed |
|
|
rs1478417702 CA424084002 |
276 | P>A | No |
ClinGen TOPMed gnomAD |
|
|
rs61466879 CA40419797 |
279 | R>H | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
rs61466879 CA40419798 |
279 | R>P | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA424084055 rs1288506299 |
279 | R>S | No |
ClinGen TOPMed |
|
|
rs898489671 CA40419799 |
283 | N>K | No |
ClinGen TOPMed |
|
|
rs1318300260 CA424084190 |
287 | T>S | No |
ClinGen TOPMed |
|
|
CA424084208 rs1467847860 |
288 | A>D | No |
ClinGen TOPMed gnomAD |
|
|
CA424084210 rs1467847860 |
288 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
rs1403013513 CA424084237 |
290 | G>R | No |
ClinGen TOPMed |
|
|
rs1322978892 CA424084282 |
292 | A>E | No |
ClinGen TOPMed |
|
|
CA424084288 rs1387384924 |
293 | A>S | No |
ClinGen TOPMed |
|
|
CA424084338 rs1574223419 |
298 | T>P | No |
ClinGen Ensembl |
|
|
rs202157536 CA40419801 |
303 | I>T | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA424084446 rs1424777933 |
304 | G>E | No |
ClinGen TOPMed |
|
|
CA424084465 rs938683709 |
305 | L>P | No |
ClinGen TOPMed gnomAD |
|
|
rs938683709 CA40419815 |
305 | L>Q | No |
ClinGen TOPMed gnomAD |
|
|
rs1053554354 CA40419819 |
306 | Q>H | No |
ClinGen TOPMed |
|
|
CA40419822 rs891815891 |
308 | Q>* | No |
ClinGen TOPMed |
|
|
rs1011880482 CA40419823 |
308 | Q>R | No |
ClinGen TOPMed gnomAD |
|
|
rs986659220 CA40419825 |
311 | R>G | No |
ClinGen TOPMed gnomAD |
|
|
CA424084561 rs1019417395 |
311 | R>L | No |
ClinGen TOPMed |
|
|
CA40419826 rs1019417395 |
311 | R>P | No |
ClinGen TOPMed |
|
|
rs1324475508 CA424084608 |
314 | P>L | No |
ClinGen gnomAD |
|
|
CA424084631 rs1235139504 |
316 | G>R | No |
ClinGen gnomAD |
|
| TCGA novel | 319 | S>L | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs955956500 CA40419827 |
319 | S>W | No |
ClinGen TOPMed gnomAD |
|
|
rs1287582168 CA424084766 |
325 | T>A | No |
ClinGen gnomAD |
|
|
CA424084788 rs1221391563 |
326 | D>G | No |
ClinGen TOPMed |
|
|
CA40419834 rs914268240 |
327 | D>E | No |
ClinGen gnomAD |
|
|
rs1205076848 CA424084812 |
328 | R>C | No |
ClinGen gnomAD |
|
|
CA40419837 rs947072880 |
328 | R>H | No |
ClinGen Ensembl |
|
|
CA40419841 rs980294827 |
329 | T>A | No |
ClinGen TOPMed gnomAD |
|
|
CA40419845 rs768827827 |
329 | T>N | No |
ClinGen Ensembl |
|
|
CA424084822 rs980294827 |
329 | T>P | No |
ClinGen TOPMed gnomAD |
|
|
CA40419855 rs149609148 |
332 | P>L | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA40419868 rs530221257 |
335 | C>F | No |
ClinGen Ensembl |
|
|
CA424084939 rs572397311 |
337 | G>R | No |
ClinGen 1000Genomes TOPMed |
|
|
rs572397311 CA40419873 |
337 | G>W | No |
ClinGen 1000Genomes TOPMed |
|
|
rs775595863 CA40419874 |
338 | G>R | No |
ClinGen TOPMed |
|
|
CA424085031 rs1160636987 |
343 | L>I | No |
ClinGen gnomAD |
|
|
CA40419876 rs1056577028 |
344 | N>S | No |
ClinGen TOPMed gnomAD |
|
|
CA40419879 rs1056577028 |
344 | N>T | No |
ClinGen TOPMed gnomAD |
|
|
rs746987951 CA40419881 |
345 | N>S | No |
ClinGen TOPMed |
|
|
CA40419899 rs541687956 |
350 | A>G | No |
ClinGen 1000Genomes |
|
|
rs1453066810 CA424085137 |
350 | A>P | No |
ClinGen TOPMed gnomAD |
|
|
rs1558168817 CA424085170 |
352 | V>A | No |
ClinGen Ensembl |
|
|
CA424085184 rs1574223486 |
353 | A>G | No |
ClinGen Ensembl |
|
|
CA424085213 rs1288288876 |
355 | L>P | No |
ClinGen gnomAD |
|
|
rs1382682141 CA424085227 |
356 | D>G | No |
ClinGen TOPMed gnomAD |
|
|
CA424085263 rs1441607013 |
358 | M>I | No |
ClinGen TOPMed |
|
|
rs940307724 CA40419907 |
368 | G>A | No |
ClinGen TOPMed |
|
|
rs1388354696 CA424085485 |
371 | G>A | No |
ClinGen gnomAD |
|
|
CA40419910 rs970207686 |
373 | S>C | No |
ClinGen TOPMed |
|
|
rs1574223505 CA424085535 |
374 | L>Q | No |
ClinGen Ensembl |
|
|
CA424085532 rs1574223502 |
374 | L>V | No |
ClinGen Ensembl |
|
|
rs1307190381 CA424085554 |
375 | P>R | No |
ClinGen TOPMed |
|
|
rs1574223509 CA424085552 |
375 | P>S | No |
ClinGen Ensembl |
|
|
CA40419920 rs769743968 |
376 | Y>C | No |
ClinGen TOPMed gnomAD |
|
|
CA40419915 rs564659386 |
376 | Y>N | No |
ClinGen 1000Genomes TOPMed |
|
|
rs1231654376 CA424085585 |
377 | G>R | No |
ClinGen gnomAD |
|
|
CA40419926 rs938744096 |
381 | E>V | No |
ClinGen TOPMed |
|
|
CA424312752 rs1416669684 |
383 | G>C | No |
ClinGen TOPMed |
|
|
rs1237694153 CA424312781 |
386 | E>G | No |
ClinGen gnomAD |
|
|
CA40896347 rs995512157 |
388 | V>A | No |
ClinGen Ensembl |
|
|
CA424312813 rs1259542436 |
390 | G>C | No |
ClinGen TOPMed gnomAD |
|
|
CA424312812 rs1259542436 |
390 | G>S | No |
ClinGen TOPMed gnomAD |
|
|
rs988926924 CA40896348 |
391 | R>* | No |
ClinGen TOPMed |
|
|
rs913191826 CA40896349 |
394 | C>R | No |
ClinGen TOPMed |
|
|
CA424312856 rs1472382034 |
395 | Y>H | No |
ClinGen TOPMed |
|
|
rs1050156390 CA40896350 |
399 | T>I | No |
ClinGen TOPMed |
|
|
CA424312899 rs1489741077 |
400 | H>D | No |
ClinGen TOPMed gnomAD |
|
|
CA424312931 rs1285167488 |
403 | T>M | No |
ClinGen TOPMed |
|
|
rs1286697739 CA424312937 |
404 | Q>* | No |
ClinGen TOPMed |
|
|
CA40896352 rs889878148 |
407 | W>* | No |
ClinGen TOPMed |
|
|
CA40896351 rs889878148 |
407 | W>C | No |
ClinGen TOPMed |
|
|
CA424312972 rs1378643680 |
408 | T>K | No |
ClinGen TOPMed |
|
|
CA424312983 rs1558168855 |
409 | K>R | No |
ClinGen Ensembl |
|
|
CA424312993 rs1214746889 |
410 | A>V | No |
ClinGen gnomAD |
|
|
CA424313025 rs1206051703 |
414 | M>V | No |
ClinGen Ensembl |
|
|
CA424313044 rs1285164000 |
416 | I>V | No |
ClinGen TOPMed |
|
|
rs1450587327 CA424313070 |
419 | K>Q | No |
ClinGen TOPMed |
|
|
rs184515322 CA40896353 |
420 | W>* | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA424313086 rs184515322 |
420 | W>C | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
rs1019469915 CA40896354 |
421 | S>N | No |
ClinGen TOPMed gnomAD |
|
|
rs563874391 CA40896356 |
423 | I>M | No |
ClinGen 1000Genomes TOPMed |
|
|
CA424313148 rs1381150442 |
428 | R>G | No |
ClinGen gnomAD |
|
|
rs1418641796 CA424313153 |
428 | R>S | No |
ClinGen gnomAD |
|
|
rs1010198913 CA40896357 |
429 | Y>H | No |
ClinGen TOPMed gnomAD |
No associated diseases with A8MW95
3 GO annotations of cellular component
| Name | Definition |
|---|---|
| phagophore assembly site | Punctate structures proximal to the endoplasmic reticulum which are the sites where the Atg machinery assembles upon autophagy induction. |
| phosphatidylinositol 3-kinase complex, class III, type I | A class III phosphatidylinositol 3-kinase complex that is involved in autophagy. In budding yeast, this complex consists of Vps30p, Vps34p, Apg14p and Vps15p. |
| phosphatidylinositol 3-kinase complex, class III, type II | A class III phosphatidylinositol 3-kinase complex that is involved in vacuolar protein sorting (VPS) via endosomes. In budding yeast, this complex consists of Vps30p, Vps34p, Vps38 and Vps15p. |
1 GO annotations of molecular function
| Name | Definition |
|---|---|
| protein-containing complex binding | Binding to a macromolecular complex. |
7 GO annotations of biological process
| Name | Definition |
|---|---|
| autophagosome assembly | The formation of a double membrane-bounded structure, the autophagosome, that occurs when a specialized membrane sac, called the isolation membrane, starts to enclose a portion of the cytoplasm. |
| autophagy | The cellular catabolic process in which cells digest parts of their own cytoplasm; allows for both recycling of macromolecular constituents under conditions of cellular stress and remodeling the intracellular structure for cell differentiation. |
| cellular response to nitrogen starvation | Any process that results in a change in state or activity of a cell (in terms of movement, secretion, enzyme production, gene expression, etc.) as a result of deprivation of nitrogen. |
| endosome to lysosome transport | The directed movement of substances from endosomes to lysosomes. |
| G protein-coupled receptor catabolic process | The chemical reactions and pathways resulting in the breakdown of a G protein-coupled receptor. |
| glucose homeostasis | Any process involved in the maintenance of an internal steady state of glucose within an organism or cell. |
| late endosome to vacuole transport | The directed movement of substances from late endosomes to the vacuole. In yeast, after transport to the prevacuolar compartment, endocytic content is delivered to the late endosome and on to the vacuole. This pathway is analogous to endosome to lysosome transport. |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MSSIRFLCQR | CHQALKLSGS | SESRSLPAAP | APTSGQAEPG | DTREPGVTTR | EVTDAEEQQD |
| 70 | 80 | 90 | 100 | 110 | 120 |
| GASSRSPPGD | GSVSKGHANI | FTLLGELGAM | HMLSSIQKAA | GDIFDIVSGQ | AVVDHPLCEE |
| 130 | 140 | 150 | 160 | 170 | 180 |
| CTDSLLEQLD | IQLALTEADS | QNYQRCLETG | ELATSEDEAA | ALRAELRDLE | LEEARLVQEL |
| 190 | 200 | 210 | 220 | 230 | 240 |
| EDVDRNNARA | AADLQAAQAE | AAELDQQERQ | HYRDYSALKR | QQLELLDQLG | NVENQLQYAR |
| 250 | 260 | 270 | 280 | 290 | 300 |
| VQRDRLKEIN | CFTATFEIWV | EGPLGVINNF | RLGRLPTVRV | GWNEINTAWG | QAALLLLTLA |
| 310 | 320 | 330 | 340 | 350 | 360 |
| NTIGLQFQRY | RLIPCGNHSY | LKSLTDDRTE | LPLFCYGGQD | VFLNNKYDRA | MVAFLDCMQQ |
| 370 | 380 | 390 | 400 | 410 | 420 |
| FKEEAEKGEL | GLSLPYGIQV | ETGLMEDVGG | RGECYSIRTH | LNTQELWTKA | LKFMLINFKW |
| 430 | |||||
| SLIWVASRYQ | K |