Q9FMN2
Gene name |
PAH2 (At5g42870, MBD2.6) |
Protein name |
Phosphatidate phosphatase PAH2 |
Names |
Phosphatidic acid phosphohydrolase 2, AtPAH2 |
Species |
Arabidopsis thaliana (Mouse-ear cress) |
KEGG Pathway |
ath:AT5G42870 |
EC number |
3.1.3.4: Phosphoric monoester hydrolases |
Protein Class |
|
Descriptions
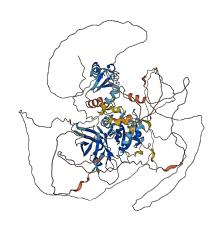
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for Q9FMN2
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-Q9FMN2-F1 | Predicted | AlphaFoldDB |
95 variants for Q9FMN2
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
| tmp_5_17189558_T_G | 42 | K>Q | No | 1000Genomes | |
| ENSVATH14572172 | 73 | S>Y | No | 1000Genomes | |
| ENSVATH07308815 | 95 | V>G | No | 1000Genomes | |
| ENSVATH07308814 | 96 | G>C | No | 1000Genomes | |
| ENSVATH14572171 | 100 | S>C | No | 1000Genomes | |
| tmp_5_17189343_C_A | 113 | E>D | No | 1000Genomes | |
| tmp_5_17189332_C_T | 117 | R>K | No | 1000Genomes | |
| tmp_5_17189287_C_T | 132 | S>N | No | 1000Genomes | |
| tmp_5_17189275_T_A | 136 | D>V | No | 1000Genomes | |
| ENSVATH12403645 | 138 | P>H | No | 1000Genomes | |
| ENSVATH12403604 | 167 | Q>R | No | 1000Genomes | |
| ENSVATH07308809 | 200 | S>A | No | 1000Genomes | |
| tmp_5_17189077_G_C | 202 | S>C | No | 1000Genomes | |
| tmp_5_17189042_T_A | 214 | T>S | No | 1000Genomes | |
| tmp_5_17189038_C_G | 215 | S>T | No | 1000Genomes | |
| ENSVATH07308808 | 216 | G>R | No | 1000Genomes | |
| ENSVATH14572169 | 223 | S>N | No | 1000Genomes | |
| ENSVATH07308807 | 223 | S>R | No | 1000Genomes | |
| ENSVATH00698212 | 227 | L>I | No | 1000Genomes | |
| ENSVATH14572168 | 229 | D>Y | No | 1000Genomes | |
| tmp_5_17188928_G_C | 252 | Q>E | No | 1000Genomes | |
| ENSVATH07308806 | 265 | E>D | No | 1000Genomes | |
| ENSVATH03327392 | 272 | V>I | No | 1000Genomes | |
| tmp_5_17188862_C_T | 274 | V>I | No | 1000Genomes | |
| ENSVATH07308805 | 281 | A>P | No | 1000Genomes | |
| ENSVATH00698211 | 283 | S>N | No | 1000Genomes | |
| tmp_5_17188829_C_T | 285 | V>M | No | 1000Genomes | |
| tmp_5_17188811_C_T | 291 | E>K | No | 1000Genomes | |
| tmp_5_17188796_C_T | 296 | V>I | No | 1000Genomes | |
| tmp_5_17188771_G_A | 304 | T>I | No | 1000Genomes | |
| ENSVATH00698210 | 306 | A>T | No | 1000Genomes | |
| tmp_5_17188762_A_C | 307 | L>R | No | 1000Genomes | |
| ENSVATH00698209 | 308 | A>T | No | 1000Genomes | |
| ENSVATH00698207 | 312 | V>I | No | 1000Genomes | |
| ENSVATH07308802 | 313 | S>R | No | 1000Genomes | |
| tmp_5_17188615_C_T | 315 | S>N | No | 1000Genomes | |
| ENSVATH07308801 | 316 | D>N | No | 1000Genomes | |
| ENSVATH07308799 | 318 | D>Y | No | 1000Genomes | |
| ENSVATH03327388 | 322 | E>G | No | 1000Genomes | |
| ENSVATH14572165 | 324 | L>F | No | 1000Genomes | |
| tmp_5_17188585_C_T | 325 | R>K | No | 1000Genomes | |
| ENSVATH07308798 | 325 | R>S | No | 1000Genomes | |
| ENSVATH12403599 | 333 | A>T | No | 1000Genomes | |
| tmp_5_17188555_A_G | 335 | L>S | No | 1000Genomes | |
| ENSVATH12403598 | 340 | Q>P | No | 1000Genomes | |
| ENSVATH00698205 | 347 | G>D | No | 1000Genomes | |
| ENSVATH12403597 | 348 | T>A | No | 1000Genomes | |
| ENSVATH00698204 | 358 | P>L | No | 1000Genomes | |
| tmp_5_17188484_C_T | 359 | V>I | No | 1000Genomes | |
| tmp_5_17188467_T_G | 364 | K>N | No | 1000Genomes | |
| tmp_5_17188463_T_A | 366 | T>S | No | 1000Genomes | |
| ENSVATH07308797 | 373 | S>A | No | 1000Genomes | |
| tmp_5_17188436_C_T | 375 | G>R | No | 1000Genomes | |
| ENSVATH12403596 | 388 | I>V | No | 1000Genomes | |
| tmp_5_17188389_T_G | 390 | Q>H | No | 1000Genomes | |
| tmp_5_17188383_C_G | 392 | E>D | No | 1000Genomes | |
| tmp_5_17188348_T_C | 404 | D>G | No | 1000Genomes | |
| tmp_5_17188336_G_C | 408 | P>R | No | 1000Genomes | |
| ENSVATH12403595 | 410 | G>S | No | 1000Genomes | |
| tmp_5_17188288_A_G | 424 | V>A | No | 1000Genomes | |
| ENSVATH12403562 | 434 | K>R | No | 1000Genomes | |
| ENSVATH00698202 | 439 | K>N | No | 1000Genomes | |
| ENSVATH07308796 | 440 | G>C | No | 1000Genomes | |
| tmp_5_17188237_A_C | 441 | V>G | No | 1000Genomes | |
| ENSVATH00698201 | 442 | E>D | No | 1000Genomes | |
| tmp_5_17188204_T_C | 452 | N>S | No | 1000Genomes | |
| tmp_5_17188177_G_A | 461 | T>I | No | 1000Genomes | |
| tmp_5_17188174_T_C | 462 | D>G | No | 1000Genomes | |
| tmp_5_17188175_C_T | 462 | D>N | No | 1000Genomes | |
| ENSVATH14572144 | 466 | R>L | No | 1000Genomes | |
| ENSVATH07308795 | 476 | L>I | No | 1000Genomes | |
| ENSVATH00698200 | 479 | N>I | No | 1000Genomes | |
| ENSVATH12403561 | 508 | D>N | No | 1000Genomes | |
| ENSVATH12403560 | 509 | E>G | No | 1000Genomes | |
| tmp_5_17188024_G_A | 512 | S>L | No | 1000Genomes | |
| tmp_5_17188022_C_G | 513 | G>R | No | 1000Genomes | |
| tmp_5_17188012_T_C | 516 | D>G | No | 1000Genomes | |
| tmp_5_17187779_C_G | 551 | E>Q | No | 1000Genomes | |
| tmp_5_17187775_C_T | 552 | G>E | No | 1000Genomes | |
| tmp_5_17187742_T_A | 563 | N>I | No | 1000Genomes | |
| ENSVATH12403558 | 564 | S>Y | No | 1000Genomes | |
| ENSVATH07308787 | 565 | E>D | No | 1000Genomes | |
| tmp_5_17187705_C_A | 575 | L>F | No | 1000Genomes | |
| ENSVATH14572142 | 590 | G>D | No | 1000Genomes | |
| ENSVATH12403555 | 625 | R>W | No | 1000Genomes | |
| ENSVATH07308786 | 633 | L>S | No | 1000Genomes | |
| tmp_5_17187530_C_T | 634 | A>T | No | 1000Genomes | |
| tmp_5_17187455_A_C | 659 | S>A | No | 1000Genomes | |
| tmp_5_17187451_C_T | 660 | G>E | No | 1000Genomes | |
| ENSVATH12403484 | 669 | Q>K | No | 1000Genomes | |
| tmp_5_17187352_G_A | 693 | S>L | No | 1000Genomes | |
| tmp_5_17187347_C_T | 695 | D>N | No | 1000Genomes | |
| tmp_5_17187319_G_A | 704 | T>I | No | 1000Genomes | |
| ENSVATH03327368 | 858 | D>N | No | 1000Genomes | |
| tmp_5_17185892_T_A | 899 | T>S | No | 1000Genomes |
No associated diseases with Q9FMN2
Functions
| Description | ||
|---|---|---|
| EC Number | 3.1.3.4 | Phosphoric monoester hydrolases |
| Subcellular Localization |
|
|
| PANTHER Family | ||
| PANTHER Subfamily | ||
| PANTHER Protein Class | ||
| PANTHER Pathway Category | No pathway information available | |
2 GO annotations of cellular component
| Name | Definition |
|---|---|
| apoplast | The cell membranes and intracellular regions in a plant are connected through plasmodesmata, and plants may be described as having two major compartments: the living symplast and the non-living apoplast. The apoplast is external to the plasma membrane and includes cell walls, intercellular spaces and the lumen of dead structures such as xylem vessels. Water and solutes pass freely through it. |
| cytosol | The part of the cytoplasm that does not contain organelles but which does contain other particulate matter, such as protein complexes. |
1 GO annotations of molecular function
| Name | Definition |
|---|---|
| phosphatidate phosphatase activity | Catalysis of the reaction: a 1,2-diacylglycerol 3-phosphate + H2O = a 1,2-diacyl-sn-glycerol + phosphate. |
5 GO annotations of biological process
| Name | Definition |
|---|---|
| cellular lipid metabolic process | The chemical reactions and pathways involving lipids, as carried out by individual cells. |
| cellular response to phosphate starvation | Any process that results in a change in state or activity of a cell (in terms of movement, secretion, enzyme production, gene expression, etc.) as a result of deprivation of phosphate. |
| galactolipid biosynthetic process | The chemical reactions and pathways resulting in the formation of galactolipids, any glycolipid containing one of more residues of galactose and/or N-acetylgalactosamine. |
| lipid metabolic process | The chemical reactions and pathways involving lipids, compounds soluble in an organic solvent but not, or sparingly, in an aqueous solvent. Includes fatty acids; neutral fats, other fatty-acid esters, and soaps; long-chain (fatty) alcohols and waxes; sphingoids and other long-chain bases; glycolipids, phospholipids and sphingolipids; and carotenes, polyprenols, sterols, terpenes and other isoprenoids. |
| phospholipid biosynthetic process | The chemical reactions and pathways resulting in the formation of a phospholipid, a lipid containing phosphoric acid as a mono- or diester. |
5 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| Q92539 | LPIN2 | Phosphatidate phosphatase LPIN2 | Homo sapiens (Human) | PR |
| Q9BQK8 | LPIN3 | Phosphatidate phosphatase LPIN3 | Homo sapiens (Human) | PR |
| Q14693 | LPIN1 | Phosphatidate phosphatase LPIN1 | Homo sapiens (Human) | PR |
| Q99PI5 | Lpin2 | Phosphatidate phosphatase LPIN2 | Mus musculus (Mouse) | PR |
| Q91ZP3 | Lpin1 | Phosphatidate phosphatase LPIN1 | Mus musculus (Mouse) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MNAVGRIGSY | IYRGVGTVSG | PFHPFGGAID | IIVVEQPDGT | FKSSPWYVRF | GKFQGVLKNG |
| 70 | 80 | 90 | 100 | 110 | 120 |
| RNLIRIDVNG | VDSGFNMYLA | HTGQAYFLRE | VEDVVGESES | GEVYTLSSGD | EAETTSRDDV |
| 130 | 140 | 150 | 160 | 170 | 180 |
| VDKVKIPLKS | RSCNYDSPSP | RTGNGKIVGK | PGILGYVFGG | RSVRESQDCG | VERAEIAADL |
| 190 | 200 | 210 | 220 | 230 | 240 |
| LEVKWSTNID | TRKRGKGMSS | ESLDGKDYGE | STSTSGKSCV | EGSSEMLVDS | DSILETPLVA |
| 250 | 260 | 270 | 280 | 290 | 300 |
| SPTLRFLDEK | EQDFRESTNV | EDYCEEDGSS | GVVVENGLCE | ASSMVFSVTS | EGSGNVEIFV |
| 310 | 320 | 330 | 340 | 350 | 360 |
| EPRTEALAED | AVSGSDLDSK | QELLRAPESV | EIATLGSADQ | ADMGSIGTSQ | EGSSTGSPVQ |
| 370 | 380 | 390 | 400 | 410 | 420 |
| DENKITIKDM | HISAGDFEKS | QSASGESILQ | PEIEEEQFSF | SDLDECKPGG | NSSVGSSSSD |
| 430 | 440 | 450 | 460 | 470 | 480 |
| TVKVDGKESY | DETKTSPEKG | VENTMALSEP | INIERKKDIF | TDEMERLVGS | LPIMRLQNND |
| 490 | 500 | 510 | 520 | 530 | 540 |
| DMDASPSQPL | SQSFDPCFNT | SKLDLREDES | SSGGLDAESV | AESSPKLKAF | KHVIANPEVV |
| 550 | 560 | 570 | 580 | 590 | 600 |
| ELSLCKHLLS | EGMGAEAASQ | AFNSEKLDME | KFASLGPSIL | ENDKLVVKIG | GCYFPWDAAA |
| 610 | 620 | 630 | 640 | 650 | 660 |
| PIILGVVSFG | TAQVFEPKGM | IAVDRNEKPG | DVLAQGSGSW | KLWPFSLRRS | TKEAEASPSG |
| 670 | 680 | 690 | 700 | 710 | 720 |
| DTAEPEEKQE | KSSPRPMKKT | VRALTPTSEQ | LASLDLKDGM | NSVTFTFSTN | IVGTQQVDAR |
| 730 | 740 | 750 | 760 | 770 | 780 |
| IYLWKWNSRI | VVSDVDGTIT | RSDVLGQFMP | LVGIDWSQTG | VTHLFSAVKE | NGYQLIFLSA |
| 790 | 800 | 810 | 820 | 830 | 840 |
| RAISQASVTR | QFLVNLKQDG | KALPDGPVVI | SPDGLFPSLF | REVIRRAPHE | FKIACLEEIR |
| 850 | 860 | 870 | 880 | 890 | 900 |
| GLFPPEHNPF | YAGFGNRDTD | EISYLKVGIP | RGKIFIINPK | GEVAVNRRID | TRSYTNLHTL |
| 910 | 920 | ||||
| VNRMFPATSS | SEPEDFNTWN | FWKLPPPSLM |