Q8N4P3
Gene name |
HDDC3 (MESH1) |
Protein name |
Guanosine-3',5'-bis(diphosphate) 3'-pyrophosphohydrolase MESH1 |
Names |
HD domain-containing protein 3, Metazoan SpoT homolog 1, MESH1, Penta-phosphate guanosine-3'-pyrophosphohydrolase, (ppGpp)ase |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:374659 |
EC number |
3.1.7.2: Diphosphoric monoester hydrolases |
Protein Class |
|
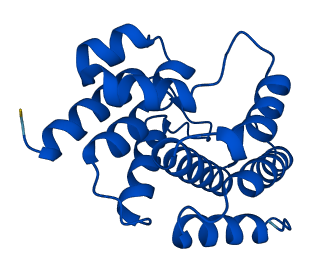
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
3 structures for Q8N4P3
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| 3NR1 | X-ray | 190 A | A/B | 2-179 | PDB |
| 5VXA | X-ray | 210 A | A/B | 1-179 | PDB |
| AF-Q8N4P3-F1 | Predicted | AlphaFoldDB |
144 variants for Q8N4P3
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
CA393889607 rs1041004690 |
4 | E>K | No |
ClinGen TOPMed |
|
|
CA274799284 rs1041004690 |
4 | E>Q | No |
ClinGen TOPMed |
|
|
rs781086745 CA393889597 |
5 | A>E | No |
ClinGen ExAC gnomAD |
|
|
CA7742347 rs781086745 |
5 | A>V | No |
ClinGen ExAC gnomAD |
|
|
CA393889590 rs1175532140 |
6 | A>V | No |
ClinGen TOPMed |
|
|
CA7742344 rs777219665 |
10 | E>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs777219665 CA7742345 |
10 | E>K | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA393889571 rs777219665 |
10 | E>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs752086762 CA7742342 |
11 | A>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs199831268 CA7742341 |
12 | A>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA393889555 rs1349453468 |
13 | D>N | No |
ClinGen TOPMed |
|
|
rs1202338302 CA393889540 |
14 | F>L | No |
ClinGen gnomAD |
|
|
rs1567144437 CA393889534 |
15 | A>V | No |
ClinGen Ensembl |
|
|
CA274799223 rs958761340 |
16 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
rs766705648 CA7742338 |
17 | R>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs760925729 CA7742337 |
18 | K>R | No |
ClinGen ExAC gnomAD |
|
|
CA7742335 rs544321005 |
20 | R>P | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA7742336 rs544321005 |
20 | R>Q | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA7742333 rs1358878150 |
21 | Q>P | No |
ClinGen gnomAD |
|
|
rs1470658011 CA393889493 |
22 | Q>H | No |
ClinGen TOPMed |
|
|
rs868041767 CA274799207 |
22 | Q>K | No |
ClinGen Ensembl |
|
|
rs1233238066 CA393889496 |
22 | Q>P | No |
ClinGen TOPMed |
|
|
CA274799200 rs868073323 |
23 | R>L | No |
ClinGen TOPMed gnomAD |
|
|
CA393889487 rs868073323 |
23 | R>P | No |
ClinGen TOPMed gnomAD |
|
|
rs868073323 CA274799205 |
23 | R>Q | No |
ClinGen TOPMed gnomAD |
|
|
CA393889488 rs1282981463 |
23 | R>W | No |
ClinGen gnomAD |
|
|
CA7742331 rs774256897 |
25 | K>R | No |
ClinGen ExAC gnomAD |
|
|
CA393889466 rs1309944702 |
26 | D>Y | No |
ClinGen gnomAD |
|
|
CA7742330 rs143797628 |
27 | P>L | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs971343113 CA274799160 |
28 | E>Q | No |
ClinGen TOPMed |
|
|
CA7742329 rs759526012 |
29 | G>E | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1331344826 CA393889431 |
30 | T>I | No |
ClinGen TOPMed |
|
|
rs907311994 CA274799146 |
31 | P>A | No |
ClinGen TOPMed |
|
|
CA393889426 rs1388305826 |
31 | P>L | No |
ClinGen gnomAD |
|
|
CA393889416 rs1372631798 |
32 | Y>C | No |
ClinGen TOPMed |
|
|
CA393889390 rs1596201835 |
35 | H>P | No |
ClinGen Ensembl |
|
|
CA7742306 rs772838683 |
38 | G>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1359770881 CA393889264 |
39 | V>G | No |
ClinGen TOPMed gnomAD |
|
|
rs771775211 CA393889267 |
39 | V>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7742305 rs771775211 |
39 | V>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1596201103 CA393889261 |
40 | A>S | No |
ClinGen Ensembl |
|
|
CA7742304 rs747731076 |
41 | R>W | No |
ClinGen ExAC gnomAD |
|
|
CA7742302 rs149008342 |
45 | H>Q | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs780552478 CA7742300 |
47 | A>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA393889215 rs1314691628 |
48 | G>R | No |
ClinGen TOPMed |
|
|
CA393889201 rs1355938447 |
50 | T>A | No |
ClinGen TOPMed |
|
|
CA393889197 rs1168108568 |
50 | T>I | No |
ClinGen gnomAD |
|
|
CA393889185 rs1250275273 |
52 | I>T | No |
ClinGen TOPMed gnomAD |
|
|
rs756539452 CA7742299 |
52 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs1334268355 CA393889178 |
53 | V>A | No |
ClinGen TOPMed |
|
|
rs1187006186 CA393889174 |
54 | V>M | No |
ClinGen gnomAD |
|
|
CA393889160 rs1212362100 |
56 | Q>R | No |
ClinGen gnomAD |
|
|
CA274798569 rs912023235 |
57 | A>E | No |
ClinGen Ensembl |
|
|
rs747316900 CA7742277 |
60 | L>P | No |
ClinGen ExAC gnomAD |
|
|
CA274798540 rs932374912 |
61 | H>R | No |
ClinGen Ensembl |
|
|
CA7742275 rs758657403 |
62 | D>E | No |
ClinGen ExAC gnomAD |
|
|
rs150464100 CA7742276 |
62 | D>G | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA393889106 rs1196682827 |
63 | T>M | No |
ClinGen TOPMed |
|
|
CA393889099 rs1183023614 |
64 | V>G | No |
ClinGen gnomAD |
|
|
rs752850621 CA7742274 |
64 | V>L | No |
ClinGen ExAC TOPMed |
|
|
rs752850621 CA393889103 |
64 | V>M | No |
ClinGen ExAC TOPMed |
|
|
CA393889093 rs1466851985 |
65 | E>V | No |
ClinGen TOPMed |
|
|
rs778839266 CA7742273 |
66 | D>N | No |
ClinGen ExAC gnomAD |
|
|
CA393889067 rs1249943822 |
69 | T>S | No |
ClinGen gnomAD |
|
|
rs921011364 CA274798520 |
70 | T>I | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA gnomAD |
|
CA7742272 rs572934314 |
71 | L>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA7742271 rs554875348 |
72 | D>H | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA393889016 rs1248220164 |
77 | H>R | No |
ClinGen gnomAD |
|
|
rs1596200482 CA393888983 |
82 | V>L | No |
ClinGen Ensembl |
|
|
CA393888968 rs1219033640 |
84 | R>L | No |
ClinGen gnomAD |
|
|
CA393888962 rs1294968728 |
86 | V>M | No |
ClinGen TOPMed gnomAD |
|
|
CA7742270 rs767405507 |
89 | V>A | No |
ClinGen ExAC gnomAD |
|
|
CA393888937 rs767405507 |
89 | V>E | No |
ClinGen ExAC gnomAD |
|
|
CA393888916 rs1229747659 |
92 | D>V | No |
ClinGen gnomAD |
|
|
rs1374683597 CA393888911 |
93 | K>Q | No |
ClinGen TOPMed |
|
|
rs377242953 CA7742268 |
94 | T>I | No |
ClinGen ESP ExAC |
|
|
CA7742267 rs575157554 |
95 | L>P | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs762569636 CA7742265 |
97 | K>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1596200391 CA393888880 |
98 | L>P | No |
ClinGen Ensembl |
|
|
CA393888878 rs1405160301 |
99 | E>K | No |
ClinGen TOPMed gnomAD |
|
| TCGA novel | 101 | K>G | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs375962566 CA274798454 |
102 | R>S | No |
ClinGen Ensembl |
|
|
rs769180797 CA7742261 |
104 | Q>P | No |
ClinGen ExAC gnomAD |
|
|
CA393888832 rs1596200342 |
105 | V>G | No |
ClinGen Ensembl |
|
|
rs141515875 CA7742260 |
107 | Q>E | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs981666865 CA274798441 |
107 | Q>P | No |
ClinGen TOPMed |
|
|
CA274798429 rs538623921 |
108 | A>E | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs538623921 CA7742259 |
108 | A>G | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA393888815 rs1160516034 |
108 | A>S | No |
ClinGen gnomAD |
|
|
rs138596450 CA7742258 |
109 | P>S | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs144631975 CA7742257 COSM374202 |
110 | H>D | lung [Cosmic] | No |
ClinGen cosmic curated ESP ExAC TOPMed gnomAD |
|
rs778239014 CA7742256 |
110 | H>P | No |
ClinGen ExAC |
|
|
rs140820485 CA274798422 |
111 | S>N | No |
ClinGen ESP |
|
|
rs772475217 CA7742255 |
111 | S>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1269694384 CA393888793 |
112 | S>N | No |
ClinGen gnomAD |
|
|
CA7742254 rs779117867 |
112 | S>R | No |
ClinGen ExAC gnomAD |
|
|
rs1488024232 CA393888786 |
113 | P>L | No |
ClinGen gnomAD |
|
|
CA7742252 rs137864548 |
114 | G>R | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
| TCGA novel | 115 | A>T | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs753899170 CA7742250 |
117 | L>R | No |
ClinGen ExAC gnomAD |
|
|
rs1326529539 CA393888763 |
117 | L>V | No |
ClinGen gnomAD |
|
|
rs757146652 CA7742248 |
121 | A>G | No |
ClinGen ExAC gnomAD |
|
|
rs1215151015 CA393888741 |
121 | A>T | No |
ClinGen TOPMed |
|
|
CA7742245 rs763844356 |
123 | K>R | No |
ClinGen ExAC gnomAD |
|
|
CA393888720 rs1437921030 |
124 | L>V | No |
ClinGen gnomAD |
|
|
rs1024119139 CA274798353 |
127 | L>V | No |
ClinGen Ensembl |
|
|
CA393888683 rs752276722 |
129 | D>E | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs764882893 CA7742242 |
130 | L>V | No |
ClinGen ExAC gnomAD |
|
|
rs372856910 CA7742241 |
131 | N>S | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA393888666 rs1170542224 |
132 | R>P | No |
ClinGen gnomAD |
|
|
CA7742240 rs776163027 |
134 | T>A | No |
ClinGen ExAC gnomAD |
|
|
rs771591823 CA7742239 |
134 | T>I | No |
ClinGen ExAC gnomAD |
|
|
rs761245831 CA7742238 |
135 | P>A | No |
ClinGen ExAC gnomAD |
|
|
CA7742237 rs773755660 |
135 | P>R | No |
ClinGen ExAC gnomAD |
|
|
rs1429036009 CA393888645 |
136 | E>A | No |
ClinGen TOPMed |
|
|
CA393888648 rs1190199489 |
136 | E>Q | No |
ClinGen gnomAD |
|
|
rs117318472 CA7742193 |
138 | W>* | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1351146262 CA393888543 |
138 | W>S | No |
ClinGen gnomAD |
|
|
CA393888535 rs1408249744 |
139 | S>* | No |
ClinGen TOPMed gnomAD |
|
|
CA393888534 rs1408249744 |
139 | S>L | No |
ClinGen TOPMed gnomAD |
|
| TCGA novel | 141 | H>R | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA393888476 rs1406832767 |
147 | F>L | No |
ClinGen gnomAD |
|
|
rs1324002141 CA393888479 |
147 | F>S | No |
ClinGen gnomAD |
|
|
rs1164093409 CA393888468 |
148 | E>D | No |
ClinGen gnomAD |
|
|
rs771948355 CA7742192 |
148 | E>Q | No |
ClinGen ExAC gnomAD |
|
|
CA7742191 rs748092184 |
149 | W>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs949916887 CA274797958 |
152 | Q>K | No |
ClinGen TOPMed gnomAD |
|
|
rs778643169 CA7742190 |
153 | V>M | No |
ClinGen ExAC gnomAD |
|
|
CA393888426 rs1354340201 |
155 | K>T | No |
ClinGen TOPMed |
|
|
CA7742189 rs768487452 CA393888383 |
161 | N>K | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs748980570 CA7742188 |
162 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1480411283 CA393888381 |
162 | R>W | No |
ClinGen gnomAD |
|
|
CA393888376 rs1213609264 |
163 | Q>* | No |
ClinGen TOPMed gnomAD |
|
|
rs1213609264 CA393888378 |
163 | Q>K | No |
ClinGen TOPMed gnomAD |
|
|
rs1219721328 CA393888335 |
169 | K>R | No |
ClinGen TOPMed |
|
|
CA393888310 rs1226608064 |
172 | F>L | No |
ClinGen gnomAD |
|
|
rs1596199319 CA393888315 |
172 | F>V | No |
ClinGen Ensembl |
|
|
rs1350259627 CA393888293 |
175 | R>G | No |
ClinGen gnomAD |
|
|
CA274797940 rs757243903 |
175 | R>P | No |
ClinGen Ensembl |
|
|
CA393888292 rs1350259627 |
175 | R>W | No |
ClinGen gnomAD |
|
|
CA393888280 rs1206269893 |
177 | L>P | No |
ClinGen TOPMed |
|
|
rs1438400408 CA393888278 |
178 | T>P | No |
ClinGen gnomAD |
|
|
CA393888270 rs1250151572 |
179 | I>F | No |
ClinGen gnomAD |
|
|
rs1196451828 CA393888266 |
179 | I>M | No |
ClinGen gnomAD |
No associated diseases with Q8N4P3
Functions
| Description | ||
|---|---|---|
| EC Number | 3.1.7.2 | Diphosphoric monoester hydrolases |
| Subcellular Localization |
|
|
| PANTHER Family | ||
| PANTHER Subfamily | ||
| PANTHER Protein Class | ||
| PANTHER Pathway Category | No pathway information available | |
No GO annotations of cellular component
| Name | Definition |
|---|---|
| No GO annotations for cellular component |
2 GO annotations of molecular function
| Name | Definition |
|---|---|
| guanosine-3',5'-bis(diphosphate) 3'-diphosphatase activity | Catalysis of the reaction: guanosine 3',5'-bis(diphosphate) + H2O = guanosine 5'-diphosphate + diphosphate. |
| metal ion binding | Binding to a metal ion. |
No GO annotations of biological process
| Name | Definition |
|---|---|
| No GO annotations for biological process |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MGSEAAQLLE | AADFAARKHR | QQRRKDPEGT | PYINHPIGVA | RILTHEAGIT | DIVVLQAALL |
| 70 | 80 | 90 | 100 | 110 | 120 |
| HDTVEDTDTT | LDEVELHFGA | QVRRLVEEVT | DDKTLPKLER | KRLQVEQAPH | SSPGAKLVKL |
| 130 | 140 | 150 | 160 | 170 | |
| ADKLYNLRDL | NRCTPEGWSE | HRVQEYFEWA | AQVVKGLQGT | NRQLEEALKH | LFKQRGLTI |