Q15561
Gene name |
TEAD4 (RTEF1, TCF13L1, TEF3) |
Protein name |
Transcriptional enhancer factor TEF-3 |
Names |
TEA domain family member 4, TEAD-4, Transcription factor 13-like 1, Transcription factor RTEF-1 |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:7004 |
EC number |
|
Protein Class |
|
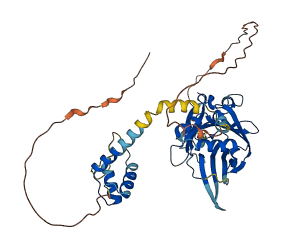
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
21 structures for Q15561
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| 5GZB | X-ray | 270 A | A | 36-139 | PDB |
| 5NO6 | X-ray | 288 A | I/N | 40-112 | PDB |
| 5OAQ | X-ray | 195 A | A | 217-434 | PDB |
| 6GE3 | X-ray | 185 A | A | 216-434 | PDB |
| 6GE4 | X-ray | 197 A | A | 216-434 | PDB |
| 6GE5 | X-ray | 205 A | A | 216-434 | PDB |
| 6GE6 | X-ray | 180 A | A | 216-434 | PDB |
| 6GEC | X-ray | 170 A | A | 216-434 | PDB |
| 6GEE | X-ray | 196 A | A | 216-434 | PDB |
| 6GEG | X-ray | 223 A | A | 216-434 | PDB |
| 6GEI | X-ray | 165 A | A | 216-434 | PDB |
| 6GEK | X-ray | 228 A | A/B | 216-434 | PDB |
| 6HIK | X-ray | 165 A | A | 216-434 | PDB |
| 6Q2X | X-ray | 210 A | A | 217-434 | PDB |
| 6Q36 | X-ray | 201 A | A/B | 217-434 | PDB |
| 6SEN | X-ray | 165 A | A/B | 217-434 | PDB |
| 6SEO | X-ray | 255 A | A | 217-434 | PDB |
| 8A8R | X-ray | 170 A | A/B | 216-434 | PDB |
| 8C17 | X-ray | 225 A | A | 217-434 | PDB |
| 8CAA | X-ray | 200 A | A/B | 217-434 | PDB |
| AF-Q15561-F1 | Predicted | AlphaFoldDB |
346 variants for Q15561
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
rs1354224261 CA383387054 |
3 | G>A | No |
ClinGen gnomAD |
|
|
CA383387035 rs1382596093 |
3 | G>S | No |
ClinGen TOPMed |
|
|
CA6392975 rs774772555 |
4 | T>M | No |
ClinGen ExAC gnomAD |
|
|
rs764221350 CA6392980 |
6 | G>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs138303433 CA6392982 |
7 | T>I | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA383387272 rs1591572456 |
9 | T>I | No |
ClinGen Ensembl |
|
|
rs1370141276 CA383387407 |
14 | S>N | No |
ClinGen gnomAD |
|
|
CA6392984 rs765447889 |
16 | P>S | No |
ClinGen ExAC gnomAD |
|
|
CA383387453 rs1591572462 |
17 | T>P | No |
ClinGen Ensembl |
|
|
CA6392985 rs201308829 |
18 | S>F | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1239272473 CA383387492 |
19 | P>S | No |
ClinGen TOPMed |
|
|
rs1591572470 CA383387576 |
22 | S>T | No |
ClinGen Ensembl |
|
|
CA6392987 rs780013542 |
23 | T>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA6392986 rs758180158 |
23 | T>P | No |
ClinGen ExAC gnomAD |
|
|
rs527238579 COSM938668 CA6392989 |
24 | A>T | large_intestine endometrium [Cosmic] | No |
ClinGen cosmic curated 1000Genomes ExAC gnomAD |
|
rs966389315 CA231651418 |
26 | G>R | No |
ClinGen Ensembl |
|
|
CA383387718 rs1591572496 |
27 | G>V | No |
ClinGen Ensembl |
|
|
CA6392992 rs747720325 |
28 | S>T | No |
ClinGen ExAC gnomAD |
|
|
rs200185504 CA6392993 |
30 | A>S | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA383387799 rs200185504 |
30 | A>T | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA383387810 rs1185657389 |
30 | A>V | No |
ClinGen gnomAD |
|
|
rs777338239 CA383387822 |
31 | L>P | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs777338239 COSM431012 CA6392994 |
31 | L>R | breast [Cosmic] | No |
ClinGen cosmic curated ExAC TOPMed gnomAD |
|
CA6392995 rs201697096 |
32 | D>E | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs772283648 CA6392996 |
33 | K>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs776020891 CA6392997 |
35 | I>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs376160263 CA6392999 |
36 | D>N | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA6393000 rs776850143 |
37 | N>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs776850143 CA383387989 |
37 | N>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA383388018 rs1429257676 |
38 | D>G | No |
ClinGen gnomAD |
|
|
rs1052141 CA6393002 |
39 | A>E | No |
ClinGen ExAC gnomAD |
|
|
CA231651448 rs1052141 |
39 | A>G | No |
ClinGen ExAC gnomAD |
|
|
rs1366402152 CA383388038 |
39 | A>T | No |
ClinGen TOPMed gnomAD |
|
|
CA383388092 rs1219806086 |
41 | G>S | No |
ClinGen TOPMed gnomAD |
|
|
rs763254392 CA6393004 |
42 | V>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs751357181 CA6393006 |
44 | S>R | No |
ClinGen ExAC gnomAD |
|
|
CA6393007 rs143364899 |
45 | P>L | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA6393009 rs752179602 |
47 | I>T | No |
ClinGen ExAC gnomAD |
|
|
rs755618933 CA6393010 |
52 | Q>* | No |
ClinGen ExAC |
|
|
CA231651462 rs769070539 |
52 | Q>R | No |
ClinGen Ensembl |
|
|
rs113303358 CA231651464 |
53 | E>G | No |
ClinGen Ensembl |
|
|
CA383388412 rs1383690211 |
56 | A>D | No |
ClinGen gnomAD |
|
|
COSM1228853 rs148347828 CA6393012 |
56 | A>T | large_intestine [Cosmic] | No |
ClinGen cosmic curated 1000Genomes ESP ExAC TOPMed gnomAD |
|
rs756948709 CA6393013 |
57 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs780501836 CA6393014 |
59 | P>L | No |
ClinGen ExAC gnomAD |
|
|
CA6393017 rs777328851 |
61 | C>W | No |
ClinGen ExAC gnomAD |
|
|
rs200040147 CA6393018 |
62 | G>D | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA6393019 rs769725571 |
64 | R>C | No |
ClinGen ExAC gnomAD |
|
|
CA383388576 rs769725571 |
64 | R>G | No |
ClinGen ExAC gnomAD |
|
|
COSM938669 CA6393020 rs375587017 |
64 | R>H | endometrium [Cosmic] | No |
ClinGen cosmic curated ESP ExAC gnomAD |
|
rs769725571 CA383388574 |
64 | R>S | No |
ClinGen ExAC gnomAD |
|
|
CA6393021 rs763014154 |
68 | L>P | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs377141915 CA6393022 |
69 | S>L | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA6393024 rs148965461 |
70 | D>E | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA383388736 rs1295766311 |
71 | E>K | No |
ClinGen TOPMed |
|
|
rs752536361 CA6393026 |
72 | G>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA231651495 rs939971926 |
73 | K>R | No |
ClinGen TOPMed |
|
|
CA6393028 rs763455765 |
74 | M>I | No |
ClinGen ExAC gnomAD |
|
|
COSM938679 rs1291664123 CA383393063 |
77 | R>Q | endometrium [Cosmic] | No |
ClinGen cosmic curated TOPMed |
|
CA6393046 rs202176942 |
77 | R>W | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA383393069 rs1591583945 |
78 | N>D | No |
ClinGen Ensembl |
|
|
rs1173967174 CA383393136 |
83 | R>C | No |
ClinGen gnomAD |
|
|
rs764955264 CA6393050 |
83 | R>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA383393147 rs1214087190 |
84 | Y>H | No |
ClinGen gnomAD |
|
|
rs1291388277 CA383393166 |
85 | I>T | No |
ClinGen gnomAD |
|
|
CA383393183 rs1351833187 |
86 | K>N | No |
ClinGen gnomAD |
|
|
rs750064191 CA6393051 |
88 | R>Q | No |
ClinGen ExAC gnomAD |
|
|
CA231655652 rs1020125646 |
88 | R>W | No |
ClinGen TOPMed gnomAD |
|
|
rs758150762 CA6393052 |
92 | T>A | No |
ClinGen ExAC gnomAD |
|
|
rs1222867658 CA383393252 |
92 | T>I | No |
ClinGen TOPMed gnomAD |
|
|
rs1003099496 CA231655656 |
93 | R>C | No |
ClinGen Ensembl |
|
|
CA383393275 rs756562199 |
94 | T>I | No |
ClinGen ExAC gnomAD |
|
|
CA6393055 rs756562199 |
94 | T>S | No |
ClinGen ExAC gnomAD |
|
|
rs1484104558 CA383393311 |
97 | Q>* | No |
ClinGen gnomAD |
|
|
rs1464770915 CA383393333 |
98 | V>F | No |
ClinGen gnomAD |
|
|
CA6393074 rs764396295 |
99 | S>P | No |
ClinGen ExAC gnomAD |
|
|
rs1480246582 CA383393375 |
104 | V>L | No |
ClinGen Ensembl |
|
|
rs1163379333 CA383393383 |
105 | L>R | No |
ClinGen gnomAD |
|
|
rs1368570211 CA383393389 |
106 | A>V | No |
ClinGen gnomAD |
|
|
rs1459333292 CA383393392 |
107 | R>C | No |
ClinGen gnomAD |
|
|
CA383393394 rs1591584846 |
107 | R>P | No |
ClinGen Ensembl |
|
|
rs1287094137 CA383393398 |
108 | R>C | No |
ClinGen gnomAD |
|
|
rs754294061 CA6393075 |
108 | R>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA383393401 rs1591584865 |
109 | K>Q | No |
ClinGen Ensembl |
|
|
rs1321453733 CA383393414 |
110 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
CA6393076 rs757774295 |
111 | R>C | No |
ClinGen ExAC gnomAD |
|
|
CA383393418 rs1394515961 |
111 | R>H | No |
ClinGen TOPMed gnomAD |
|
|
CA383393419 rs1394515961 |
111 | R>L | No |
ClinGen TOPMed gnomAD |
|
|
CA6393078 rs746015510 |
112 | E>K | No |
ClinGen ExAC gnomAD |
|
|
rs1334085813 CA383393429 |
113 | I>F | No |
ClinGen TOPMed |
|
|
rs1565542235 CA383393432 |
113 | I>M | No |
ClinGen Ensembl |
|
|
CA6393079 rs758536351 |
113 | I>T | No |
ClinGen ExAC gnomAD |
|
|
CA383393434 rs780374211 |
114 | Q>* | No |
ClinGen ExAC gnomAD |
|
|
CA6393080 rs780374211 |
114 | Q>E | No |
ClinGen ExAC gnomAD |
|
|
rs941912696 CA231656054 |
115 | A>G | No |
ClinGen TOPMed gnomAD |
|
|
rs941912696 CA383393444 |
115 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
rs1236362065 CA383393451 |
116 | K>E | No |
ClinGen TOPMed gnomAD |
|
|
CA383393469 rs1378779269 |
117 | L>Q | No |
ClinGen TOPMed |
|
|
CA383393482 rs1459214277 |
118 | K>T | No |
ClinGen TOPMed |
|
|
CA6393103 rs769828815 |
119 | D>H | No |
ClinGen ExAC gnomAD |
|
|
CA6393104 rs773320291 |
120 | Q>E | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs749267494 CA6393105 |
121 | A>E | No |
ClinGen ExAC gnomAD |
|
|
CA383395103 rs1230053937 |
123 | K>E | No |
ClinGen gnomAD |
|
|
rs1193727796 CA383395109 |
123 | K>R | No |
ClinGen TOPMed |
|
|
CA6393106 rs770424147 |
124 | D>N | No |
ClinGen ExAC gnomAD |
|
|
rs1591589393 CA383395150 |
125 | K>R | No |
ClinGen Ensembl |
|
|
rs1337181746 CA383395241 |
129 | S>N | No |
ClinGen TOPMed |
|
|
rs1337181746 CA383395244 |
129 | S>T | No |
ClinGen TOPMed |
|
|
CA383395274 rs1273998522 |
130 | M>R | No |
ClinGen TOPMed |
|
|
CA383395271 rs1273998522 |
130 | M>T | No |
ClinGen TOPMed |
|
|
rs767142386 CA383395294 |
131 | A>P | No |
ClinGen ExAC gnomAD |
|
|
rs767142386 CA6393109 |
131 | A>T | No |
ClinGen ExAC gnomAD |
|
|
CA383395326 rs1186903984 |
133 | M>L | No |
ClinGen gnomAD |
|
|
rs762215851 COSM1228852 CA6393111 |
134 | S>L | large_intestine [Cosmic] | No |
ClinGen cosmic curated ExAC gnomAD |
|
rs375377144 CA6393113 |
136 | A>V | No |
ClinGen ESP ExAC gnomAD |
|
|
rs763394861 CA6393114 |
137 | Q>R | No |
ClinGen ExAC gnomAD |
|
|
COSM1492893 rs117484952 CA6393117 |
141 | A>T | kidney [Cosmic] | No |
ClinGen cosmic curated 1000Genomes ESP ExAC TOPMed gnomAD |
|
CA383395453 rs1326407755 |
142 | T>M | No |
ClinGen TOPMed |
|
|
CA383395484 rs1436866573 |
145 | H>N | No |
ClinGen gnomAD |
|
|
CA383395492 rs1281870739 |
145 | H>R | No |
ClinGen gnomAD |
|
|
rs752507117 CA6393119 |
146 | S>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA383395528 CA383395527 rs1292023322 |
147 | S>R | No |
ClinGen TOPMed gnomAD |
|
|
CA383395540 rs1459552661 |
148 | M>T | No |
ClinGen TOPMed |
|
|
rs576443873 CA231658863 |
149 | A>V | No |
ClinGen gnomAD |
|
|
rs1290903018 CA383395573 COSM1512031 |
151 | A>S | lung [Cosmic] | No |
ClinGen cosmic curated TOPMed gnomAD |
|
CA383395575 rs1290903018 |
151 | A>T | No |
ClinGen TOPMed gnomAD |
|
|
CA6393122 rs535488654 |
151 | A>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA231658870 rs929337081 |
152 | R>Q | No |
ClinGen TOPMed gnomAD |
|
|
CA6393123 rs369932433 |
152 | R>W | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA6393124 rs770787414 |
153 | G>V | No |
ClinGen ExAC gnomAD |
|
|
CA383395616 rs150590022 |
155 | G>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA6393126 rs150590022 |
155 | G>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs373626483 CA6393127 |
156 | R>C | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA6393128 rs139665156 |
156 | R>H | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1331834037 CA383395651 |
158 | A>S | No |
ClinGen TOPMed gnomAD |
|
|
rs1331834037 CA383395649 |
158 | A>T | No |
ClinGen TOPMed gnomAD |
|
|
CA383395657 rs1339358801 |
158 | A>V | No |
ClinGen gnomAD |
|
|
rs367751748 CA6393130 |
159 | V>D | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1285461716 CA383395676 |
160 | S>* | No |
ClinGen gnomAD |
|
|
CA6393131 rs149743004 |
161 | G>E | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA6393146 rs779568456 |
163 | W>R | No |
ClinGen ExAC gnomAD |
|
|
rs1565545430 CA383395730 |
164 | Q>E | No |
ClinGen Ensembl |
|
|
CA231659732 rs987214567 |
164 | Q>L | No |
ClinGen Ensembl |
|
|
CA231659745 rs746594673 |
166 | A>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA6393147 rs746594673 |
166 | A>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1448859001 CA383395748 |
167 | L>S | No |
ClinGen TOPMed |
|
|
rs866378032 CA231659767 |
169 | G>D | No |
ClinGen Ensembl |
|
|
rs200746125 CA6393149 |
172 | G>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA6393150 rs144567026 |
173 | T>M | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1440072332 CA383395852 |
174 | S>F | No |
ClinGen gnomAD |
|
|
CA6393152 rs774674986 |
175 | H>L | No |
ClinGen ExAC gnomAD |
|
|
rs766365802 CA6393183 |
179 | P>R | No |
ClinGen ExAC gnomAD |
|
|
rs1555127560 CA383396402 |
179 | P>S | No |
ClinGen Ensembl |
|
|
CA6393184 rs556052032 |
181 | S>F | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs935421118 CA231660254 |
183 | Q>E | No |
ClinGen Ensembl |
|
|
CA383396467 rs1309375945 |
184 | T>A | No |
ClinGen gnomAD |
|
|
CA231660256 rs989537357 |
184 | T>I | No |
ClinGen TOPMed gnomAD |
|
|
rs754439456 CA6393185 |
185 | Y>D | No |
ClinGen ExAC gnomAD |
|
|
rs755806437 CA6393188 |
187 | V>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA6393187 rs747692032 |
187 | V>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA231660280 rs896397769 |
189 | P>T | No |
ClinGen TOPMed |
|
|
CA6393189 rs779133956 |
190 | P>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA6393190 rs370063341 |
192 | P>S | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1186747513 CA383396587 |
195 | G>R | No |
ClinGen gnomAD |
|
|
CA383396744 rs1185664866 |
197 | E>G | No |
ClinGen TOPMed |
|
|
CA383396738 rs1350253314 |
197 | E>Q | No |
ClinGen TOPMed gnomAD |
|
|
rs1224622323 CA383396761 |
198 | S>F | No |
ClinGen gnomAD |
|
|
rs1484777838 CA383396771 |
199 | P>L | No |
ClinGen TOPMed |
|
|
rs1309624293 CA383396766 |
199 | P>S | No |
ClinGen gnomAD |
|
|
CA6393218 rs763197038 |
200 | A>S | No |
ClinGen ExAC gnomAD |
|
|
CA6393219 rs763197038 |
200 | A>T | No |
ClinGen ExAC gnomAD |
|
|
CA231661595 rs146443432 |
200 | A>V | No |
ClinGen ESP gnomAD |
|
|
rs545767625 CA6393220 |
201 | G>E | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1565546622 CA383396797 |
202 | P>S | No |
ClinGen Ensembl |
|
|
rs371373848 CA6393224 |
203 | A>S | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs371373848 CA6393223 COSM178540 |
203 | A>T | large_intestine [Cosmic] | No |
ClinGen cosmic curated ESP ExAC TOPMed gnomAD |
|
rs753500375 CA6393226 |
205 | S>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs140809000 CA6393225 |
205 | S>T | No |
ClinGen ESP ExAC gnomAD |
|
|
CA6393227 rs756972096 |
207 | S>F | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA6393228 rs374365771 |
208 | A>V | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA6393230 rs755432905 |
209 | P>L | No |
ClinGen ExAC gnomAD |
|
|
rs1591592014 CA383396873 |
209 | P>S | No |
ClinGen Ensembl |
|
|
CA6393231 rs199662990 |
210 | P>L | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs756183214 CA6393233 |
211 | A>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs143114313 CA6393234 |
211 | A>V | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1021485033 CA231661727 |
215 | Q>E | No |
ClinGen TOPMed gnomAD |
|
|
rs1440879034 CA383396992 |
217 | R>C | No |
ClinGen TOPMed gnomAD |
|
|
CA6393235 rs151141907 |
217 | R>H | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs367723028 CA6393237 |
219 | V>M | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1480094508 CA383397105 |
222 | S>P | No |
ClinGen TOPMed |
|
|
CA231661752 rs957492113 |
223 | K>R | No |
ClinGen TOPMed |
|
|
rs1206572490 CA383397207 CA383397205 |
225 | W>C | No |
ClinGen gnomAD |
|
|
CA6393239 rs375896668 |
226 | M>T | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1488061158 CA383397264 |
228 | E>K | No |
ClinGen gnomAD |
|
|
CA383397284 rs1252042208 |
229 | F>L | No |
ClinGen TOPMed |
|
|
CA6393240 rs775449465 |
230 | S>C | No |
ClinGen ExAC gnomAD |
|
|
rs1253793632 CA383397329 |
232 | F>S | No |
ClinGen gnomAD |
|
|
rs141118300 CA6393241 |
236 | Q>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs763628398 CA6393242 |
237 | Q>K | No |
ClinGen ExAC gnomAD |
|
|
rs1410988798 CA383397459 |
239 | P>A | No |
ClinGen TOPMed gnomAD |
|
|
CA6393243 rs71583736 |
239 | P>L | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA383397462 rs1410988798 |
239 | P>S | No |
ClinGen TOPMed gnomAD |
|
|
CA383397488 rs1436293237 |
240 | D>G | No |
ClinGen gnomAD |
|
|
CA383397513 rs765047253 |
241 | T>K | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA6393245 rs765047253 |
241 | T>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA6393276 rs779884533 |
242 | Y>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1591592919 CA383398109 |
245 | H>P | No |
ClinGen Ensembl |
|
|
rs1007919145 CA231662944 |
246 | L>P | No |
ClinGen TOPMed |
|
|
CA6393278 rs768680578 |
247 | F>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1402110482 CA383398140 |
247 | F>Y | No |
ClinGen gnomAD |
|
|
rs1415302307 CA383398158 |
248 | V>E | No |
ClinGen gnomAD |
|
|
CA231662964 rs1017929050 |
248 | V>L | No |
ClinGen TOPMed gnomAD |
|
|
CA383398152 rs1017929050 |
248 | V>M | No |
ClinGen TOPMed gnomAD |
|
|
rs1490699816 CA383398192 |
250 | I>T | No |
ClinGen TOPMed |
|
|
CA383398199 rs1348391906 |
251 | G>S | No |
ClinGen gnomAD |
|
|
rs781323637 CA6393279 |
252 | Q>* | No |
ClinGen ExAC gnomAD |
|
|
CA383398227 rs748114401 |
252 | Q>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1208933668 CA383398320 |
258 | S>G | No |
ClinGen TOPMed |
|
|
CA383398342 rs1591592964 |
259 | D>A | No |
ClinGen Ensembl |
|
|
CA231663005 rs903431864 |
259 | D>E | No |
ClinGen TOPMed gnomAD |
|
|
rs1225713927 CA383398340 |
259 | D>N | No |
ClinGen gnomAD |
|
|
rs1485412434 CA383398352 |
260 | P>S | No |
ClinGen gnomAD |
|
|
CA231663014 rs202053088 |
261 | Y>C | No |
ClinGen 1000Genomes |
|
|
CA383398371 rs202053088 |
261 | Y>S | No |
ClinGen 1000Genomes |
|
|
CA6393283 COSM938723 rs762656664 |
263 | E>K | endometrium [Cosmic] | No |
ClinGen cosmic curated ExAC TOPMed gnomAD |
|
rs201149385 CA6393285 |
265 | V>M | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA383398443 rs761078905 |
267 | I>F | No |
ClinGen ExAC TOPMed |
|
|
rs761078905 CA6393286 |
267 | I>V | No |
ClinGen ExAC TOPMed |
|
|
COSM1267595 rs141718322 CA6393287 |
268 | R>C | oesophagus [Cosmic] | No |
ClinGen cosmic curated 1000Genomes ESP ExAC TOPMed gnomAD |
|
CA6393288 rs754304508 |
268 | R>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs754304508 CA6393289 |
268 | R>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs765302453 CA6393290 |
271 | Y>C | No |
ClinGen ExAC gnomAD |
|
|
CA383398501 rs765302453 |
271 | Y>F | No |
ClinGen ExAC gnomAD |
|
|
rs373793296 CA6393292 |
275 | P>L | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1409156460 CA383398581 |
277 | K>E | No |
ClinGen gnomAD |
|
|
CA383398605 rs1337348966 |
278 | K>T | No |
ClinGen gnomAD |
|
|
rs138509952 CA6393295 |
284 | L>F | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs138509952 CA6393296 |
284 | L>V | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs147065257 CA383398729 |
287 | R>P | No |
ClinGen ESP TOPMed gnomAD |
|
|
rs147065257 CA231663147 |
287 | R>Q | No |
ClinGen ESP TOPMed gnomAD |
|
|
CA231663136 rs555272304 |
287 | R>W | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
rs769682182 CA6393298 |
288 | G>R | No |
ClinGen ExAC gnomAD |
|
|
CA383398746 rs1340612123 |
289 | P>H | No |
ClinGen gnomAD |
|
|
rs867226875 CA231663155 |
289 | P>S | No |
ClinGen Ensembl |
|
|
rs777335307 CA383398762 |
290 | S>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA6393299 rs777335307 |
290 | S>F | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA6393300 rs571778933 |
291 | N>S | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs534152841 CA6393301 |
292 | A>T | No |
ClinGen 1000Genomes ExAC |
|
|
CA383398790 rs1252243357 |
293 | F>I | No |
ClinGen TOPMed |
|
|
rs759218732 CA6393303 |
295 | L>V | No |
ClinGen ExAC gnomAD |
|
|
rs776992627 CA6393305 |
298 | F>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1313720511 CA383381703 |
301 | D>N | No |
ClinGen gnomAD |
|
|
rs763983673 CA6393333 |
304 | T>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs753653815 CA6393334 |
305 | N>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA383381739 COSM3704066 rs1265923337 |
306 | I>F | liver [Cosmic] | No |
ClinGen cosmic curated gnomAD |
|
rs529565656 CA6393336 |
306 | I>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA383381749 rs758015153 |
307 | E>D | No |
ClinGen ExAC gnomAD |
|
|
rs745449009 CA6393337 |
307 | E>K | No |
ClinGen ExAC gnomAD |
|
|
rs779726504 CA6393339 |
308 | D>V | No |
ClinGen ExAC gnomAD |
|
|
CA231658255 rs1028228180 |
310 | G>D | No |
ClinGen TOPMed gnomAD |
|
|
rs867635120 CA231658277 |
312 | S>F | No |
ClinGen Ensembl |
|
|
CA383381828 rs1591603359 |
314 | Y>* | No |
ClinGen Ensembl |
|
|
rs536669411 CA6393345 |
314 | Y>C | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs536669411 CA6393344 |
314 | Y>S | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA6393346 rs774546561 |
316 | V>A | No |
ClinGen ExAC gnomAD |
|
|
rs759741797 CA6393347 |
317 | S>P | No |
ClinGen ExAC gnomAD |
|
|
rs1441684016 CA383381935 |
322 | S>I | No |
ClinGen TOPMed |
|
|
CA383381933 rs1441684016 |
322 | S>T | No |
ClinGen TOPMed |
|
|
rs11550887 CA6393350 VAR_052279 |
323 | P>S | No |
ClinGen UniProt 1000Genomes ESP ExAC TOPMed dbSNP gnomAD |
|
|
rs1172254434 CA383381980 |
324 | E>D | No |
ClinGen TOPMed |
|
|
CA231658333 rs987014448 |
324 | E>K | No |
ClinGen TOPMed gnomAD |
|
|
rs753722673 CA6393352 |
325 | N>K | No |
ClinGen ExAC gnomAD |
|
|
CA383382080 rs1482024630 |
328 | I>S | No |
ClinGen gnomAD |
|
|
rs200483208 CA6393353 |
329 | T>I | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA6393354 rs371946304 |
330 | C>S | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA6393355 rs749911955 |
331 | S>F | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA6393357 rs779566440 |
332 | T>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs912429601 CA231658353 |
333 | K>T | No |
ClinGen TOPMed |
|
|
CA231658377 rs76933440 |
338 | G>D | No |
ClinGen Ensembl |
|
|
rs1263352356 CA383382254 |
338 | G>S | No |
ClinGen gnomAD |
|
|
CA6393359 rs767356667 |
339 | K>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1307767017 CA383382295 |
340 | Q>* | No |
ClinGen TOPMed |
|
|
rs1223331098 CA383382305 |
340 | Q>H | No |
ClinGen TOPMed |
|
|
rs1417731247 CA383382328 |
342 | V>L | No |
ClinGen gnomAD |
|
|
rs757656318 CA6393380 |
348 | E>K | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA383383162 rs1412328792 |
350 | A>V | No |
ClinGen TOPMed |
|
|
CA6393381 rs143259791 |
351 | R>C | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs746321600 CA6393382 |
351 | R>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1182324160 CA383383185 |
352 | Y>* | No |
ClinGen TOPMed |
|
|
CA231659888 rs369711969 |
352 | Y>F | No |
ClinGen ESP TOPMed gnomAD |
|
|
CA383383216 rs1253693371 |
355 | G>R | No |
ClinGen gnomAD |
|
|
CA383383230 rs1591605094 |
356 | H>R | No |
ClinGen Ensembl |
|
|
CA383383225 rs1482910821 |
356 | H>Y | No |
ClinGen TOPMed |
|
|
rs772765432 CA6393384 |
357 | Y>* | No |
ClinGen ExAC gnomAD |
|
|
rs1419356207 CA383383272 |
359 | Y>* | No |
ClinGen TOPMed gnomAD |
|
|
CA383383263 rs1184865351 |
359 | Y>D | No |
ClinGen gnomAD |
|
|
rs148295237 CA6393385 |
360 | R>C | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA383383281 rs1172939530 |
360 | R>H | No |
ClinGen TOPMed gnomAD |
|
|
CA6393386 rs148295237 |
360 | R>S | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs776863179 CA6393387 |
361 | I>F | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1326238086 CA383383313 |
363 | R>Q | No |
ClinGen gnomAD |
|
|
rs887754938 COSM938733 CA231659908 |
363 | R>W | endometrium [Cosmic] | No |
ClinGen cosmic curated TOPMed gnomAD |
|
CA383383337 rs1396026469 |
365 | P>L | No |
ClinGen TOPMed gnomAD |
|
|
CA383383335 rs1396026469 |
365 | P>Q | No |
ClinGen TOPMed gnomAD |
|
|
rs1379140974 CA687174376 |
367 | C>* | No |
ClinGen TOPMed |
|
|
rs1436724825 CA383383408 |
370 | M>I | No |
ClinGen TOPMed |
|
|
rs1388733012 CA383383423 |
372 | N>D | No |
ClinGen TOPMed |
|
|
rs1362508195 CA383383426 |
372 | N>S | No |
ClinGen gnomAD |
|
|
rs1388733012 CA383383424 |
372 | N>Y | No |
ClinGen TOPMed |
|
|
CA6393389 rs769507018 |
375 | H>L | No |
ClinGen ExAC gnomAD |
|
|
rs773002468 CA6393390 |
375 | H>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs141376355 CA6393391 |
376 | K>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA6393392 rs766383485 |
378 | K>Q | No |
ClinGen ExAC gnomAD |
|
|
rs373443172 CA6393393 |
378 | K>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA6393395 rs766970807 |
383 | K>E | No |
ClinGen ExAC gnomAD |
|
|
rs1486462821 CA383383590 |
383 | K>T | No |
ClinGen gnomAD |
|
|
rs568432444 CA6393396 |
384 | Y>H | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs910307904 CA383383614 |
385 | M>L | No |
ClinGen TOPMed |
|
|
rs910307904 CA231660015 |
385 | M>V | No |
ClinGen TOPMed |
|
|
CA383383631 rs1475123488 |
386 | M>L | No |
ClinGen gnomAD |
|
|
CA6393398 rs755845240 |
386 | M>T | No |
ClinGen ExAC gnomAD |
|
|
CA383383684 rs1316966542 |
389 | V>M | No |
ClinGen TOPMed gnomAD |
|
|
CA231660039 rs902014352 |
391 | E>D | No |
ClinGen TOPMed |
|
|
CA383383785 rs1591605200 |
394 | T>P | No |
ClinGen Ensembl |
|
|
CA231660213 rs1035099586 |
403 | D>N | No |
ClinGen Ensembl |
|
|
CA231660220 rs896503133 |
405 | Q>* | No |
ClinGen Ensembl |
|
|
CA383384118 rs1279803067 |
405 | Q>R | No |
ClinGen gnomAD |
|
|
CA383384150 rs912933244 COSM1288412 |
406 | E>D | autonomic_ganglia [Cosmic] | No |
ClinGen cosmic curated TOPMed gnomAD |
|
CA383384130 rs1393998467 |
406 | E>Q | No |
ClinGen gnomAD |
|
|
CA383384166 rs1174306516 |
407 | T>N | No |
ClinGen gnomAD |
|
|
CA231660243 rs1020888840 |
410 | C>F | No |
ClinGen TOPMed gnomAD |
|
|
CA383384209 rs1336523863 |
410 | C>R | No |
ClinGen gnomAD |
|
|
CA383384240 rs1301295641 |
411 | I>N | No |
ClinGen TOPMed gnomAD |
|
|
CA6393433 rs768302943 |
413 | Y>C | No |
ClinGen ExAC gnomAD |
|
|
CA383384279 rs1277055105 |
414 | V>I | No |
ClinGen gnomAD |
|
|
rs1195546851 CA383384305 |
416 | E>V | No |
ClinGen gnomAD |
|
|
rs1301466750 CA383384311 |
417 | V>M | No |
ClinGen TOPMed |
|
|
rs1365177021 CA383384334 |
419 | A>T | No |
ClinGen TOPMed |
|
|
rs779330383 CA231660279 |
423 | G>R | No |
ClinGen gnomAD |
|
|
CA6393437 rs751923397 |
426 | H>Y | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA231660318 rs368628079 |
427 | H>Y | No |
ClinGen ESP TOPMed gnomAD |
|
|
rs1168238612 CA383384539 |
430 | R>K | No |
ClinGen gnomAD |
|
|
rs756149930 CA6393441 |
432 | V>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs753228454 CA6393440 |
432 | V>L | No |
ClinGen ExAC gnomAD |
|
|
CA6393442 rs777839953 |
433 | K>E | No |
ClinGen ExAC gnomAD |
|
|
rs754035071 CA231660342 CA6393443 |
435 | E>R | No |
ClinGen ExAC gnomAD |
No associated diseases with Q15561
6 GO annotations of cellular component
| Name | Definition |
|---|---|
| chromatin | The ordered and organized complex of DNA, protein, and sometimes RNA, that forms the chromosome. |
| cytoplasm | The contents of a cell excluding the plasma membrane and nucleus, but including other subcellular structures. |
| nucleoplasm | That part of the nuclear content other than the chromosomes or the nucleolus. |
| nucleus | A membrane-bounded organelle of eukaryotic cells in which chromosomes are housed and replicated. In most cells, the nucleus contains all of the cell's chromosomes except the organellar chromosomes, and is the site of RNA synthesis and processing. In some species, or in specialized cell types, RNA metabolism or DNA replication may be absent. |
| protein-DNA complex | A macromolecular complex containing both protein and DNA molecules. |
| transcription regulator complex | A protein complex that is capable of associating with DNA by direct binding, or via other DNA-binding proteins or complexes, and regulating transcription. |
4 GO annotations of molecular function
| Name | Definition |
|---|---|
| DNA-binding transcription activator activity, RNA polymerase II-specific | A DNA-binding transcription factor activity that activates or increases transcription of specific gene sets transcribed by RNA polymerase II. |
| DNA-binding transcription factor activity | A transcription regulator activity that modulates transcription of gene sets via selective and non-covalent binding to a specific double-stranded genomic DNA sequence (sometimes referred to as a motif) within a cis-regulatory region. Regulatory regions include promoters (proximal and distal) and enhancers. Genes are transcriptional units, and include bacterial operons. |
| DNA-binding transcription factor activity, RNA polymerase II-specific | A DNA-binding transcription factor activity that modulates the transcription of specific gene sets transcribed by RNA polymerase II. |
| RNA polymerase II cis-regulatory region sequence-specific DNA binding | Binding to a specific upstream regulatory DNA sequence (transcription factor recognition sequence or binding site) located in cis relative to the transcription start site (i.e., on the same strand of DNA) of a gene transcribed by RNA polymerase II. |
9 GO annotations of biological process
| Name | Definition |
|---|---|
| cell fate specification | The process involved in the specification of cell identity. Once specification has taken place, a cell will be committed to differentiate down a specific pathway if left in its normal environment. |
| embryo implantation | Attachment of the blastocyst to the uterine lining. |
| embryonic organ development | Development, taking place during the embryonic phase, of a tissue or tissues that work together to perform a specific function or functions. Development pertains to the process whose specific outcome is the progression of a structure over time, from its formation to the mature structure. Organs are commonly observed as visibly distinct structures, but may also exist as loosely associated clusters of cells that work together to perform a specific function or functions. |
| hippo signaling | The series of molecular signals mediated by the serine/threonine kinase Hippo or one of its orthologs. In Drosophila, Hippo in complex with the scaffold protein Salvador (Sav), phosphorylates and activates Warts (Wts), which in turn phosphorylates and inactivates the Yorkie (Yki) transcriptional activator. The core fly components hippo, sav, wts and mats are conserved in mammals as STK4/3 (MST1/2), SAV1/WW45, LATS1/2 and MOB1. |
| muscle organ development | The process whose specific outcome is the progression of the muscle over time, from its formation to the mature structure. The muscle is an organ consisting of a tissue made up of various elongated cells that are specialized to contract and thus to produce movement and mechanical work. |
| positive regulation of stem cell population maintenance | Any process that activates or increases the frequency, rate or extent of stem cell population maintenance. |
| regulation of transcription by RNA polymerase II | Any process that modulates the frequency, rate or extent of transcription mediated by RNA polymerase II. |
| skeletal system development | The process whose specific outcome is the progression of the skeleton over time, from its formation to the mature structure. The skeleton is the bony framework of the body in vertebrates (endoskeleton) or the hard outer envelope of insects (exoskeleton or dermoskeleton). |
| trophectodermal cell fate commitment | The cell fate commitment of precursor cells that will become trophectoderm cells. |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MEGTAGTITS | NEWSSPTSPE | GSTASGGSQA | LDKPIDNDAE | GVWSPDIEQS | FQEALAIYPP |
| 70 | 80 | 90 | 100 | 110 | 120 |
| CGRRKIILSD | EGKMYGRNEL | IARYIKLRTG | KTRTRKQVSS | HIQVLARRKA | REIQAKLKDQ |
| 130 | 140 | 150 | 160 | 170 | 180 |
| AAKDKALQSM | AAMSSAQIIS | ATAFHSSMAL | ARGPGRPAVS | GFWQGALPGQ | AGTSHDVKPF |
| 190 | 200 | 210 | 220 | 230 | 240 |
| SQQTYAVQPP | LPLPGFESPA | GPAPSPSAPP | APPWQGRSVA | SSKLWMLEFS | AFLEQQQDPD |
| 250 | 260 | 270 | 280 | 290 | 300 |
| TYNKHLFVHI | GQSSPSYSDP | YLEAVDIRQI | YDKFPEKKGG | LKDLFERGPS | NAFFLVKFWA |
| 310 | 320 | 330 | 340 | 350 | 360 |
| DLNTNIEDEG | SSFYGVSSQY | ESPENMIITC | STKVCSFGKQ | VVEKVETEYA | RYENGHYSYR |
| 370 | 380 | 390 | 400 | 410 | 420 |
| IHRSPLCEYM | INFIHKLKHL | PEKYMMNSVL | ENFTILQVVT | NRDTQETLLC | IAYVFEVSAS |
| 430 | |||||
| EHGAQHHIYR | LVKE |