Q9S9T0
Gene name |
At4g05080 (T32N4.2) |
Protein name |
F-box/kelch-repeat protein At4g05080 |
Names |
|
Species |
Arabidopsis thaliana (Mouse-ear cress) |
KEGG Pathway |
ath:AT4G05080 |
EC number |
|
Protein Class |
|
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
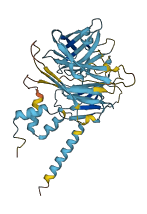
1 structures for Q9S9T0
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-Q9S9T0-F1 | Predicted | AlphaFoldDB |
194 variants for Q9S9T0
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
| ENSVATH06480261 | 2 | T>M | No | 1000Genomes | |
| ENSVATH06480262 | 4 | M>L | No | 1000Genomes | |
| ENSVATH06480263 | 5 | F>I | No | 1000Genomes | |
| ENSVATH06480265 | 7 | L>F | No | 1000Genomes | |
| ENSVATH02666154 | 8 | T>K | No | 1000Genomes | |
| ENSVATH02666154 | 8 | T>M | No | 1000Genomes | |
| ENSVATH02666154 | 8 | T>R | No | 1000Genomes | |
| ENSVATH10766194 | 9 | Q>* | No | 1000Genomes | |
| ENSVATH06480266 | 9 | Q>H | No | 1000Genomes | |
| ENSVATH10766235 | 10 | D>G | No | 1000Genomes | |
| ENSVATH10766236 | 11 | L>S | No | 1000Genomes | |
| ENSVATH00465925 | 13 | K>E | No | 1000Genomes | |
| ENSVATH02666155 | 16 | L>W | No | 1000Genomes | |
| ENSVATH02666156 | 17 | S>F | No | 1000Genomes | |
| tmp_4_2603053_G_A | 18 | R>K | No | 1000Genomes | |
| tmp_4_2603059_C_T | 20 | P>L | No | 1000Genomes | |
| tmp_4_2603068_C_T | 23 | S>F | No | 1000Genomes | |
| ENSVATH08232085 | 25 | G>E | No | 1000Genomes | |
| tmp_4_2603073_G_C | 25 | G>R | No | 1000Genomes | |
| ENSVATH02666157 | 26 | A>T | No | 1000Genomes | |
| tmp_4_2603086_C_T | 29 | S>F | No | 1000Genomes | |
| ENSVATH06480268 | 33 | G>* | No | 1000Genomes | |
| ENSVATH06480269 | 33 | G>E | No | 1000Genomes | |
| ENSVATH06480268 | 33 | G>R | No | 1000Genomes | |
| ENSVATH10766239 | 34 | W>* | No | 1000Genomes | |
| ENSVATH02666159 | 36 | A>T | No | 1000Genomes | |
| tmp_4_2603113_C_T | 38 | S>F | No | 1000Genomes | |
| ENSVATH13946650 | 40 | D>E | No | 1000Genomes | |
| ENSVATH02666160 | 40 | D>N | No | 1000Genomes | |
| ENSVATH02666160 | 40 | D>Y | No | 1000Genomes | |
| tmp_4_2603121_C_T | 41 | R>W | No | 1000Genomes | |
| ENSVATH06480271 | 46 | A>G | No | 1000Genomes | |
| ENSVATH02666161 | 46 | A>S | No | 1000Genomes | |
| ENSVATH02666161 | 46 | A>T | No | 1000Genomes | |
| ENSVATH06480271 | 46 | A>V | No | 1000Genomes | |
| tmp_4_2603143_C_T | 48 | P>L | No | 1000Genomes | |
| tmp_4_2603142_C_T | 48 | P>S | No | 1000Genomes | |
| tmp_4_2603148_C_T | 50 | Q>* | No | 1000Genomes | |
| ENSVATH13946651 | 53 | H>R | No | 1000Genomes | |
| ENSVATH10766265 | 53 | H>Y | No | 1000Genomes | |
| tmp_4_2603163_G_A | 55 | G>R | No | 1000Genomes | |
| ENSVATH02666162 | 57 | M>K | No | 1000Genomes | |
| ENSVATH02666163 | 58 | L>P | No | 1000Genomes | |
| tmp_4_2603176_C_T | 59 | S>F | No | 1000Genomes | |
| ENSVATH02666165 | 63 | L>F | No | 1000Genomes | |
| tmp_4_2603212_C_G | 71 | S>C | No | 1000Genomes | |
| tmp_4_2603215_G_T | 72 | G>V | No | 1000Genomes | |
| tmp_4_2603223_A_T | 75 | K>* | No | 1000Genomes | |
| ENSVATH13946652 | 77 | N>T | No | 1000Genomes | |
| tmp_4_2603254_C_A,T | 85 | S>* | No | 1000Genomes | |
| tmp_4_2603254_C_A,T | 85 | S>L | No | 1000Genomes | |
| ENSVATH02666168 | 86 | V>I | No | 1000Genomes | |
| ENSVATH06480275 | 88 | E>K | No | 1000Genomes | |
| ENSVATH02666170 | 90 | G>C | No | 1000Genomes | |
| ENSVATH02666171 | 91 | N>K | No | 1000Genomes | |
| ENSVATH06480276 | 92 | F>L | No | 1000Genomes | |
| tmp_4_2603277_CT_TT,C | 93 | L>F | No | 1000Genomes | |
| tmp_4_2603286_G_A | 96 | V>I | No | 1000Genomes | |
| tmp_4_2603289_G_A | 97 | E>K | No | 1000Genomes | |
| ENSVATH02666172 | 101 | M>I | No | 1000Genomes | |
| ENSVATH06480277 | 102 | Y>* | No | 1000Genomes | |
| tmp_4_2603312_C_A | 104 | C>* | No | 1000Genomes | |
| ENSVATH00465927 | 105 | G>D | No | 1000Genomes | |
| ENSVATH02666174 | 105 | G>S | No | 1000Genomes | |
| ENSVATH02666175 | 106 | G>D | No | 1000Genomes | |
| ENSVATH06480278 | 109 | L>* | No | 1000Genomes | |
| ENSVATH02666176 | 110 | C>* | No | 1000Genomes | |
| ENSVATH02666177 | 113 | T>K | No | 1000Genomes | |
| ENSVATH02666177 | 113 | T>M | No | 1000Genomes | |
| ENSVATH02666177 | 113 | T>R | No | 1000Genomes | |
| tmp_4_2603340_G_A | 114 | D>N | No | 1000Genomes | |
| tmp_4_2603344_C_A | 115 | T>N | No | 1000Genomes | |
| ENSVATH06480281 | 116 | R>T | No | 1000Genomes | |
| tmp_4_2603352_G_A | 118 | V>M | No | 1000Genomes | |
|
tmp_4_2603360_G_A ENSVATH02666178 |
120 | W>* | No | 1000Genomes | |
| ENSVATH02666179 | 122 | P>L | No | 1000Genomes | |
| tmp_4_2603364_C_T | 122 | P>S | No | 1000Genomes | |
| tmp_4_2603370_T_A,C | 124 | L>M | No | 1000Genomes | |
| tmp_4_2603374_G_A | 125 | G>E | No | 1000Genomes | |
| tmp_4_2603376_C_T | 126 | Q>* | No | 1000Genomes | |
| tmp_4_2603378_A_T | 126 | Q>H | No | 1000Genomes | |
| ENSVATH02666180 | 127 | I>F | No | 1000Genomes | |
| ENSVATH02666182 | 135 | E>D | No | 1000Genomes | |
| ENSVATH06480282 | 136 | T>A | No | 1000Genomes | |
| ENSVATH02666183 | 137 | M>I | No | 1000Genomes | |
| tmp_4_2603410_T_C | 137 | M>T | No | 1000Genomes | |
| tmp_4_2603413_A_T | 138 | Y>F | No | 1000Genomes | |
| tmp_4_2603416_C_T | 139 | S>F | No | 1000Genomes | |
| tmp_4_2603425_G_A | 142 | C>Y | No | 1000Genomes | |
| tmp_4_2603427_C_T | 143 | L>F | No | 1000Genomes | |
| ENSVATH00465928 | 144 | R>G | No | 1000Genomes | |
| tmp_4_2603438_C_G | 146 | D>E | No | 1000Genomes | |
| ENSVATH02666185 | 146 | D>H | No | 1000Genomes | |
| ENSVATH02666185 | 146 | D>N | No | 1000Genomes | |
| ENSVATH02666186 | 149 | K>N | No | 1000Genomes | |
| ENSVATH02666187 | 158 | D>H | No | 1000Genomes | |
| ENSVATH06480283 | 161 | Q>H | No | 1000Genomes | |
| ENSVATH10766270 | 161 | Q>K | No | 1000Genomes | |
| tmp_4_2603485_G_A | 162 | G>D | No | 1000Genomes | |
| tmp_4_2603487_T_C | 163 | S>P | No | 1000Genomes | |
| ENSVATH02666188 | 165 | E>K | No | 1000Genomes | |
| ENSVATH06480285 | 169 | L>F | No | 1000Genomes | |
| tmp_4_2603508_A_G | 170 | K>E | No | 1000Genomes | |
| ENSVATH13946675 | 170 | K>N | No | 1000Genomes | |
| ENSVATH02666189 | 174 | W>* | No | 1000Genomes | |
| tmp_4_2603526_G_A | 176 | A>T | No | 1000Genomes | |
| ENSVATH10766273 | 189 | G>W | No | 1000Genomes | |
| tmp_4_2603568_C_T | 190 | Q>* | No | 1000Genomes | |
| ENSVATH10766274 | 194 | V>I | No | 1000Genomes | |
| ENSVATH08232086 | 197 | N>Y | No | 1000Genomes | |
| tmp_4_2603617_C_T | 206 | T>I | No | 1000Genomes | |
| tmp_4_2603626_T_G | 209 | L>* | No | 1000Genomes | |
| ENSVATH02666191 | 210 | L>Q | No | 1000Genomes | |
| ENSVATH06480287 | 214 | D>N | No | 1000Genomes | |
| ENSVATH06480288 | 218 | E>K | No | 1000Genomes | |
| ENSVATH08232087 | 219 | R>S | No | 1000Genomes | |
| ENSVATH02666194 | 221 | G>E | No | 1000Genomes | |
| tmp_4_2603667_C_A | 223 | L>I | No | 1000Genomes | |
| tmp_4_2603670_C_T | 224 | L>F | No | 1000Genomes | |
| tmp_4_2603676_C_A | 226 | P>T | No | 1000Genomes | |
| ENSVATH02666196 | 227 | P>H | No | 1000Genomes | |
| ENSVATH02666196 | 227 | P>L | No | 1000Genomes | |
| tmp_4_2603685_C_G | 229 | Q>E | No | 1000Genomes | |
| ENSVATH06480289 | 230 | H>Y | No | 1000Genomes | |
| ENSVATH13946676 | 231 | G>S | No | 1000Genomes | |
| ENSVATH00465932 | 231 | G>V | No | 1000Genomes | |
| ENSVATH06480290 | 235 | L>I | No | 1000Genomes | |
| ENSVATH10766336 | 236 | S>Y | No | 1000Genomes | |
| ENSVATH02666197 | 237 | W>C | No | 1000Genomes | |
| ENSVATH06480291 | 237 | W>S | No | 1000Genomes | |
| tmp_4_2603712_G_C | 238 | V>L | No | 1000Genomes | |
| tmp_4_2603733_G_A | 245 | A>T | No | 1000Genomes | |
| tmp_4_2603742_C_A | 248 | Q>K | No | 1000Genomes | |
| tmp_4_2603746_A_C | 249 | H>P | No | 1000Genomes | |
| ENSVATH02666198 | 250 | L>F | No | 1000Genomes | |
| tmp_4_2603762_G_A | 254 | M>I | No | 1000Genomes | |
| ENSVATH10766337 | 258 | W>* | No | 1000Genomes | |
| ENSVATH06480293 | 259 | I>V | No | 1000Genomes | |
| ENSVATH02666199 | 261 | T>A | No | 1000Genomes | |
| tmp_4_2603792_G_T | 264 | E>D | No | 1000Genomes | |
| tmp_4_2603803_T_A | 268 | L>Q | No | 1000Genomes | |
| ENSVATH06480294 | 268 | L>V | No | 1000Genomes | |
| tmp_4_2603805_T_C | 269 | S>P | No | 1000Genomes | |
| ENSVATH06480296 | 272 | S>P | No | 1000Genomes | |
| tmp_4_2603838_C_T | 280 | Q>* | No | 1000Genomes | |
| ENSVATH02666201 | 282 | I>V | No | 1000Genomes | |
| ENSVATH06480298 | 283 | A>S | No | 1000Genomes | |
| tmp_4_2603880_A_C | 294 | N>H | No | 1000Genomes | |
| ENSVATH10766342 | 297 | I>V | No | 1000Genomes | |
| tmp_4_2603894_C_A | 298 | D>E | No | 1000Genomes | |
| ENSVATH06480300 | 300 | E>K | No | 1000Genomes | |
| ENSVATH06480301 | 303 | L>H | No | 1000Genomes | |
| ENSVATH13946677 | 303 | L>V | No | 1000Genomes | |
| tmp_4_2603911_C_T | 304 | A>V | No | 1000Genomes | |
| tmp_4_2603913_G_A | 305 | V>M | No | 1000Genomes | |
| tmp_4_2603916_G_A | 306 | V>I | No | 1000Genomes | |
| ENSVATH06480304 | 310 | V>L | No | 1000Genomes | |
| ENSVATH06480305 | 312 | S>F | No | 1000Genomes | |
| ENSVATH00465936 | 314 | D>G | No | 1000Genomes | |
| ENSVATH10766375 | 315 | C>Y | No | 1000Genomes | |
| ENSVATH06480306 | 317 | R>I | No | 1000Genomes | |
| ENSVATH06480307 | 318 | S>Y | No | 1000Genomes | |
| ENSVATH02666203 | 319 | N>K | No | 1000Genomes | |
| ENSVATH02666204 | 328 | G>R | No | 1000Genomes | |
| ENSVATH06480308 | 329 | D>H | No | 1000Genomes | |
| ENSVATH02666205 | 330 | D>N | No | 1000Genomes | |
| tmp_4_2603992_G_A | 331 | G>D | No | 1000Genomes | |
| tmp_4_2603994_T_A | 332 | Y>N | No | 1000Genomes | |
| ENSVATH02666206 | 338 | S>I | No | 1000Genomes | |
| ENSVATH10766378 | 339 | L>F | No | 1000Genomes | |
| ENSVATH13946678 | 343 | A>V | No | 1000Genomes | |
| ENSVATH00465938 | 347 | T>S | No | 1000Genomes | |
| ENSVATH02666207 | 348 | A>P | No | 1000Genomes | |
| ENSVATH02666207 | 348 | A>T | No | 1000Genomes | |
| ENSVATH00465939 | 349 | I>F | No | 1000Genomes | |
| ENSVATH00465939 | 349 | I>V | No | 1000Genomes | |
| ENSVATH10766380 | 350 | M>I | No | 1000Genomes | |
| ENSVATH02666208 | 350 | M>V | No | 1000Genomes | |
| ENSVATH02666209 | 353 | S>R | No | 1000Genomes | |
| ENSVATH10766381 | 355 | Y>H | No | 1000Genomes | |
| tmp_4_2604066_G_A | 356 | V>I | No | 1000Genomes | |
| ENSVATH02666210 | 357 | S>P | No | 1000Genomes | |
| tmp_4_2604085_T_A | 362 | I>N | No | 1000Genomes | |
| tmp_4_2604088_A_T | 363 | D>V | No | 1000Genomes | |
| ENSVATH02666211 | 369 | R>C | No | 1000Genomes | |
| ENSVATH02666212 | 370 | R>G | No | 1000Genomes | |
| ENSVATH06480311 | 370 | R>K | No | 1000Genomes | |
| ENSVATH10766382 | 372 | R>K | No | 1000Genomes | |
| ENSVATH02666213 | 373 | E>A | No | 1000Genomes | |
| ENSVATH06480313 | 376 | S>I | No | 1000Genomes | |
| ENSVATH06480313 | 376 | S>N | No | 1000Genomes | |
| ENSVATH06480314 | 380 | E>K | No | 1000Genomes | |
| ENSVATH13946679 | 388 | N>T | No | 1000Genomes | |
| tmp_4_2604166_A_G | 389 | N>S | No | 1000Genomes |
No associated diseases with Q9S9T0
4 regional properties for Q9S9T0
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| repeat | Pentatricopeptide repeat | 142 - 173 | IPR002885-1 |
| repeat | Pentatricopeptide repeat | 173 - 208 | IPR002885-2 |
| repeat | Pentatricopeptide repeat | 248 - 272 | IPR002885-3 |
| domain | DYW domain | 377 - 469 | IPR032867 |
No GO annotations of cellular component
| Name | Definition |
|---|---|
| No GO annotations for cellular component |
No GO annotations of molecular function
| Name | Definition |
|---|---|
| No GO annotations for molecular function |
No GO annotations of biological process
| Name | Definition |
|---|---|
| No GO annotations for biological process |
11 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| Q9LUI8 | At3g22730 | Putative F-box/kelch-repeat protein At3g22730 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9SCK7 | At3g49520 | Putative F-box protein At3g49520 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9LRW6 | At3g13820 | F-box protein At3g13820 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9FVQ9 | At1g32140 | Putative F-box protein At1g32140 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9LRZ2 | At3g16820 | Putative F-box protein At3g16820 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q8LCE9 | At3g19470 | F-box protein At3g19470 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9LIL1 | At3g22870 | Putative F-box/kelch-repeat protein At3g22870 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9SZA6 | At4g33290 | F-box/kelch-repeat protein At4g33290 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9FFS9 | At5g41510 | Putative F-box protein At5g41510 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9CAP3 | At1g77650 | Putative F-box protein At1g77650 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| Q9ZV78 | At2g07140 | F-box protein At2g07140 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MTMMFDLTQD | LVKEILSRVP | ITSLGAVRST | CKGWNALSKD | RILCKAKPKQ | QFHQGFMLSD |
| 70 | 80 | 90 | 100 | 110 | 120 |
| YRLRSMRFNI | SGTFKENGEE | FVNLSVKEIG | NFLNKVEISH | MYYCGGILLC | VTTDTRLVIW |
| 130 | 140 | 150 | 160 | 170 | 180 |
| NPYLGQIRWI | QLKTETMYST | FCLRYDNNKN | HKILRFLDNK | QGSYEIYDLK | SYSWRAFDVI |
| 190 | 200 | 210 | 220 | 230 | 240 |
| PKWDIDDDGQ | SASVKGNTYF | RTIDETPNLL | ICFDFTAERF | GKLLDPPFQH | GWMSLSWVRE |
| 250 | 260 | 270 | 280 | 290 | 300 |
| EKLVALYQHL | DTSMIEIWIT | TKIEPNALSW | TSFLKCYIEQ | LIALDFWFDI | DYNNFFIDEE |
| 310 | 320 | 330 | 340 | 350 | 360 |
| KKLAVVIDKV | ESEDCKRSNS | HINSYIIGDD | GYLKKMNSLG | NTARSYTAIM | LSSCYVSSLV |
| 370 | 380 | 390 | |||
| QIDDPIARRR | RRERNSKRKE | KKRKGTTNNK | V |