Q9P035
Gene name |
HACD3 |
Protein name |
Very-long-chain (3R)-3-hydroxyacyl-CoA dehydratase 3 |
Names |
3-hydroxyacyl-CoA dehydratase 3, HACD3, Butyrate-induced protein 1, B-ind1, hB-ind1, Protein-tyrosine phosphatase-like A domain-containing protein 1 |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:51495 |
EC number |
4.2.1.134: Hydro-lyases |
Protein Class |
|
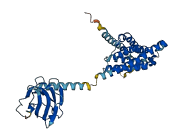
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for Q9P035
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-Q9P035-F1 | Predicted | AlphaFoldDB |
278 variants for Q9P035
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
CA392900485 rs1238067394 |
8 | P>S | No |
ClinGen gnomAD |
|
|
CA392900493 rs1358808567 |
9 | H>Y | No |
ClinGen gnomAD |
|
|
rs1244300782 CA392900526 |
11 | Y>C | No |
ClinGen TOPMed |
|
|
rs1226655029 CA392900533 |
12 | W>R | No |
ClinGen gnomAD |
|
|
CA392900555 rs1272667293 |
13 | A>G | No |
ClinGen gnomAD |
|
|
rs1458292614 CA392900561 |
14 | Q>* | No |
ClinGen gnomAD |
|
|
CA392900574 rs1479877122 |
15 | R>Q | No |
ClinGen TOPMed |
|
|
CA271572814 rs1053345731 |
17 | R>C | No |
ClinGen TOPMed gnomAD |
|
|
rs1236903901 CA392900617 |
18 | E>D | No |
ClinGen TOPMed gnomAD |
|
|
rs1205569395 CA392900606 |
18 | E>K | No |
ClinGen TOPMed |
|
|
rs1014170975 CA271572828 |
22 | R>L | No |
ClinGen TOPMed |
|
|
rs372174820 CA271572856 |
26 | S>N | No |
ClinGen Ensembl |
|
|
CA392900677 rs1465701202 |
27 | D>G | No |
ClinGen gnomAD |
|
|
rs1054853487 CA392900687 |
29 | Q>* | No |
ClinGen gnomAD |
|
|
CA271572866 rs1054853487 |
29 | Q>K | No |
ClinGen gnomAD |
|
|
CA7618926 rs780903175 |
31 | P>A | No |
ClinGen ExAC gnomAD |
|
|
CA392904330 rs1424654772 |
33 | I>V | No |
ClinGen gnomAD |
|
|
rs752335758 CA7618927 |
34 | S>G | No |
ClinGen ExAC gnomAD |
|
|
CA7618928 rs755831959 |
35 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs1596210351 CA392904365 |
36 | T>A | No |
ClinGen Ensembl |
|
|
rs1315605723 CA392904373 |
36 | T>I | No |
ClinGen TOPMed |
|
|
rs770395083 CA7618931 |
39 | V>G | No |
ClinGen ExAC gnomAD |
|
|
rs748827681 CA392904412 |
39 | V>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7618930 rs748827681 |
39 | V>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs753801389 CA7618932 |
41 | H>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7618933 rs747529368 |
43 | K>N | No |
ClinGen ExAC gnomAD |
|
|
rs771321368 CA7618944 |
45 | Q>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA392904792 rs1467914132 |
47 | H>Q | No |
ClinGen gnomAD |
|
|
CA392904796 rs1314259528 |
48 | G>S | No |
ClinGen gnomAD |
|
|
rs755778804 CA7618947 |
55 | Y>C | No |
ClinGen ExAC gnomAD |
|
|
rs755778804 CA7618948 |
55 | Y>F | No |
ClinGen ExAC gnomAD |
|
|
CA7618949 VAR_037712 rs11632737 |
56 | E>K | No |
ClinGen UniProt ESP ExAC TOPMed dbSNP gnomAD |
|
|
rs747483242 CA7618953 |
62 | L>F | No |
ClinGen ExAC |
|
|
rs186662742 CA7618952 |
62 | L>V | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1278437007 CA392905024 |
67 | P>L | No |
ClinGen gnomAD |
|
|
rs1191574324 CA392905023 |
67 | P>S | No |
ClinGen TOPMed |
|
|
CA392905021 rs1191574324 |
67 | P>T | No |
ClinGen TOPMed |
|
|
CA392905556 rs1317079502 |
69 | P>A | No |
ClinGen TOPMed gnomAD |
|
|
CA392905562 rs1350369914 |
69 | P>L | No |
ClinGen gnomAD |
|
|
CA392905561 rs1350369914 |
69 | P>R | No |
ClinGen gnomAD |
|
|
CA392905557 rs1317079502 |
69 | P>S | No |
ClinGen TOPMed gnomAD |
|
|
CA7618982 rs201830295 |
72 | K>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1323837715 CA392905599 |
73 | L>M | No |
ClinGen gnomAD |
|
|
rs1424277347 CA392905610 |
74 | T>S | No |
ClinGen TOPMed |
|
|
CA392905616 rs1281486021 |
75 | Q>E | No |
ClinGen gnomAD |
|
|
rs1348884613 CA392905628 |
76 | R>G | No |
ClinGen gnomAD |
|
|
rs775563054 CA392905650 |
78 | V>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7618983 rs775563054 |
78 | V>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA392905657 rs1337067116 |
79 | N>K | No |
ClinGen gnomAD |
|
|
rs1212300528 CA392905660 |
80 | I>V | No |
ClinGen gnomAD |
|
|
rs1252922283 CA392905669 |
81 | T>I | No |
ClinGen gnomAD |
|
|
rs760704126 CA7618984 |
82 | V>A | No |
ClinGen ExAC gnomAD |
|
|
rs1458488379 CA392905672 |
82 | V>I | No |
ClinGen gnomAD |
|
| TCGA novel | 84 | K>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1157669469 CA392905807 |
90 | W>* | No |
ClinGen gnomAD |
|
|
rs1596212788 CA392905800 |
90 | W>G | No |
ClinGen Ensembl |
|
|
CA271593092 rs999441146 |
91 | E>G | No |
ClinGen Ensembl |
|
|
CA392905824 rs1287570436 |
91 | E>K | No |
ClinGen gnomAD |
|
|
rs1596212798 CA392905848 |
92 | R>G | No |
ClinGen Ensembl |
|
|
CA392905862 rs1200811386 |
92 | R>S | No |
ClinGen TOPMed |
|
|
rs1484039359 CA392905876 |
93 | L>P | No |
ClinGen TOPMed |
|
|
CA392905894 rs1413828170 |
94 | T>I | No |
ClinGen TOPMed gnomAD |
|
|
CA392905901 rs1596212805 |
95 | K>E | No |
ClinGen Ensembl |
|
|
CA392905936 rs1197495599 |
96 | Q>H | No |
ClinGen TOPMed |
|
|
CA392905931 rs1462576509 |
96 | Q>R | No |
ClinGen gnomAD |
|
|
CA7618986 rs776321683 |
98 | K>Q | No |
ClinGen ExAC |
|
|
CA392905973 rs1393730789 |
99 | R>* | No |
ClinGen TOPMed gnomAD |
|
|
rs1030863935 CA271593100 |
99 | R>Q | No |
ClinGen gnomAD |
|
|
CA271593107 rs747784503 |
100 | P>Q | No |
ClinGen Ensembl |
|
|
rs764778176 CA7618988 |
104 | A>P | No |
ClinGen ExAC gnomAD |
|
|
CA392906062 rs1441683788 |
105 | P>S | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA gnomAD |
|
rs372672939 CA7618989 |
106 | D>N | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1357373984 CA392906134 |
109 | R>C | No |
ClinGen TOPMed gnomAD |
|
|
CA7618990 rs757902811 |
109 | R>H | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA gnomAD |
|
rs1357373984 CA392906130 |
109 | R>S | No |
ClinGen TOPMed gnomAD |
|
|
CA392906174 rs1312532443 |
111 | L>P | No |
ClinGen TOPMed |
|
|
CA271593131 rs868044151 |
112 | D>N | No |
ClinGen Ensembl |
|
|
rs1396916094 CA392906212 |
113 | E>V | No |
ClinGen TOPMed |
|
|
CA392906265 rs755867233 |
116 | A>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs755867233 CA7618992 |
116 | A>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA392906280 rs1271276251 |
117 | E>A | No |
ClinGen gnomAD |
|
|
rs769701408 CA7619005 |
124 | E>K | No |
ClinGen ExAC gnomAD |
|
|
CA392906519 rs1596213695 |
125 | E>* | No |
ClinGen Ensembl |
|
|
rs1315954062 CA392906543 |
126 | E>G | No |
ClinGen TOPMed |
|
|
CA7619006 rs772730169 |
127 | R>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7619007 rs200531541 |
127 | R>H | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1486477698 CA392906569 |
128 | L>I | No |
ClinGen TOPMed gnomAD |
|
|
rs765804659 CA7619008 |
128 | L>P | No |
ClinGen ExAC gnomAD |
|
|
rs1256134436 CA392906588 |
129 | N>D | No |
ClinGen gnomAD |
|
|
CA7619009 rs751097633 |
129 | N>S | No |
ClinGen ExAC gnomAD |
|
|
CA7619010 rs761119479 |
131 | L>F | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7619011 rs563313406 |
131 | L>H | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs754407217 CA7619012 |
132 | R>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs757558394 CA7619013 |
132 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7619014 rs779390764 |
133 | L>M | No |
ClinGen ExAC gnomAD |
|
|
rs750607822 CA7619015 |
133 | L>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA271594630 rs914995414 |
135 | S>C | No |
ClinGen TOPMed gnomAD |
|
|
CA392906685 rs372958001 |
135 | S>R | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1384004000 CA392906692 |
136 | E>K | No |
ClinGen TOPMed gnomAD |
|
|
CA7619017 rs78181111 |
137 | G>A | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs78181111 CA392906730 |
137 | G>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA7619018 rs747065485 |
138 | S>F | No |
ClinGen ExAC gnomAD |
|
|
CA392906737 rs1234395883 |
138 | S>P | No |
ClinGen gnomAD |
|
|
rs768900983 CA7619019 |
141 | T>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1349356506 CA392907468 |
141 | T>I | No |
ClinGen TOPMed gnomAD |
|
|
rs1349356506 CA392907466 |
141 | T>S | No |
ClinGen TOPMed gnomAD |
|
|
rs1176638861 CA392907474 |
142 | L>F | No |
ClinGen TOPMed gnomAD |
|
|
rs370826631 CA392907487 |
143 | T>K | No |
ClinGen ESP TOPMed |
|
|
CA271597951 rs370826631 |
143 | T>R | No |
ClinGen ESP TOPMed |
|
|
CA271597958 rs866466508 |
145 | L>F | No |
ClinGen Ensembl |
|
|
rs373386103 CA7619036 |
145 | L>S | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1254821062 CA392907525 |
146 | R>T | No |
ClinGen gnomAD |
|
|
rs755003649 CA7619038 |
147 | K>E | No |
ClinGen ExAC gnomAD |
|
|
rs1251487911 CA392907540 |
147 | K>R | No |
ClinGen TOPMed gnomAD |
|
|
CA392907557 rs1421150870 |
148 | G>V | No |
ClinGen gnomAD |
|
|
CA7619039 rs781348893 |
151 | F>L | No |
ClinGen ExAC gnomAD |
|
|
CA392907595 rs1003443238 |
151 | F>L | No |
ClinGen TOPMed |
|
|
rs1363253210 CA392907605 |
152 | M>T | No |
ClinGen gnomAD |
|
|
CA392907649 rs1212365740 |
155 | L>P | No |
ClinGen TOPMed |
|
|
rs747966375 CA7619040 |
155 | L>V | No |
ClinGen ExAC gnomAD |
|
|
CA392907663 rs1461230709 |
156 | V>G | No |
ClinGen gnomAD |
|
|
rs1392989511 CA392907654 |
156 | V>M | No |
ClinGen gnomAD |
|
|
rs1299134569 CA392907667 |
157 | Q>* | No |
ClinGen gnomAD |
|
|
rs777492694 CA7619042 |
158 | F>L | No |
ClinGen ExAC |
|
|
CA392907701 rs1416450686 |
159 | L>S | No |
ClinGen TOPMed gnomAD |
|
|
CA7619043 rs749057596 |
160 | G>* | No |
ClinGen ExAC gnomAD |
|
|
rs770752075 CA7619044 |
161 | F>Y | No |
ClinGen ExAC gnomAD |
|
|
CA7619047 rs771425058 |
163 | W>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA392907753 rs1348759557 |
165 | F>L | No |
ClinGen TOPMed |
|
|
rs539637230 CA7619048 |
165 | F>V | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA392907773 rs1567338408 |
167 | N>Y | No |
ClinGen Ensembl |
|
|
rs762177740 CA7619049 |
171 | R>* | No |
ClinGen ExAC gnomAD |
|
|
rs762177740 CA392907816 |
171 | R>G | No |
ClinGen ExAC gnomAD |
|
|
rs765754510 CA7619050 |
173 | C>S | No |
ClinGen ExAC gnomAD |
|
|
CA7619051 rs192713664 |
174 | I>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
| TCGA novel | 175 | L>F | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1596215622 CA392907872 |
175 | L>S | No |
ClinGen Ensembl |
|
|
CA392907905 rs1250156955 |
178 | E>K | No |
ClinGen gnomAD |
|
| TCGA novel | 178 | E>R | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA392908401 rs1172332395 |
179 | S>C | No |
ClinGen TOPMed |
|
|
rs746498079 CA7619067 |
181 | Y>H | No |
ClinGen ExAC gnomAD |
|
|
CA392908443 rs773845502 |
185 | H>P | No |
ClinGen ExAC gnomAD |
|
|
rs773845502 CA7619069 |
185 | H>R | No |
ClinGen ExAC gnomAD |
|
|
CA7619071 rs533257022 |
190 | M>R | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA7619070 rs533257022 |
190 | M>T | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs1414354631 CA392908484 |
190 | M>V | No |
ClinGen TOPMed |
|
|
rs1255428555 CA392908507 |
191 | M>I | No |
ClinGen gnomAD |
|
|
CA392908515 rs1404427048 |
192 | Y>H | No |
ClinGen gnomAD |
|
|
CA392908533 rs1485392707 |
193 | F>V | No |
ClinGen gnomAD |
|
|
rs374106421 CA271599238 |
195 | Q>H | No |
ClinGen ESP TOPMed |
|
|
rs201414320 CA7619073 |
196 | M>T | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA392908614 rs1427096845 |
199 | V>A | No |
ClinGen TOPMed gnomAD |
|
|
rs1194648291 CA392908626 |
200 | V>A | No |
ClinGen TOPMed |
|
|
rs375424240 CA7619074 |
201 | E>D | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA7619075 rs752900123 |
202 | T>A | No |
ClinGen ExAC gnomAD |
|
|
rs756213896 CA7619076 |
202 | T>I | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 204 | N>I | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA7619077 rs201998821 |
204 | N>S | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs923167467 CA271599284 |
207 | I>F | No |
ClinGen TOPMed |
|
|
rs967233467 CA271599294 |
207 | I>T | No |
ClinGen TOPMed gnomAD |
|
|
rs923167467 CA392908707 |
207 | I>V | No |
ClinGen TOPMed |
|
|
CA271599301 rs933155816 |
210 | T>A | No |
ClinGen Ensembl |
|
|
rs757189861 CA7619079 |
210 | T>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1596216242 CA392908750 |
211 | T>A | No |
ClinGen Ensembl |
|
|
rs778632006 CA7619080 |
211 | T>M | No |
ClinGen ExAC gnomAD |
|
|
rs570046325 CA7619082 |
213 | P>L | Variant assessed as Somatic; 9.283e-05 impact. [NCI-TCGA] | No |
ClinGen 1000Genomes ExAC NCI-TCGA TOPMed gnomAD |
|
rs1448086198 CA392908783 |
214 | V>L | No |
ClinGen TOPMed |
|
|
rs1278459977 CA392908823 |
217 | S>F | No |
ClinGen gnomAD |
|
|
rs1360298607 CA392908847 |
219 | I>M | No |
ClinGen TOPMed |
|
|
CA392908850 rs1289531532 |
220 | Q>E | No |
ClinGen gnomAD |
|
|
CA7619100 rs761931146 |
224 | R>I | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
CA271603575 rs993630790 |
224 | R>S | No |
ClinGen Ensembl |
|
|
CA392909486 rs1596219116 |
229 | F>S | No |
ClinGen Ensembl |
|
|
CA392909498 rs1175820817 |
231 | I>V | No |
ClinGen gnomAD |
|
|
rs758202721 CA7619103 |
233 | G>S | No |
ClinGen ExAC gnomAD |
|
|
CA392909531 rs1477465992 |
234 | T>A | No |
ClinGen gnomAD |
|
|
rs1322554485 CA392909534 |
234 | T>N | No |
ClinGen Ensembl |
|
|
CA7619105 rs372332781 |
235 | M>V | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1158327844 CA392909574 |
237 | E>D | No |
ClinGen gnomAD |
|
|
CA7619106 rs754712949 |
237 | E>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA271603665 rs780796243 |
239 | Q>* | No |
ClinGen ExAC gnomAD |
|
|
rs1336762574 CA392909610 |
239 | Q>H | No |
ClinGen TOPMed |
|
|
CA7619107 rs780796243 |
239 | Q>K | No |
ClinGen ExAC gnomAD |
|
|
rs916718280 CA271603677 |
239 | Q>R | No |
ClinGen TOPMed |
|
|
CA7619108 rs199819573 |
243 | V>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA392909649 rs199819573 |
243 | V>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7619111 rs375827057 |
244 | V>A | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs769465556 CA7619109 |
244 | V>F | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs769465556 CA7619110 |
244 | V>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA392909727 rs150458022 |
250 | L>F | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA7619114 rs576191673 |
251 | W>R | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA392909747 rs1337632900 |
252 | S>N | No |
ClinGen TOPMed gnomAD |
|
|
rs768844460 CA7619116 |
253 | A>V | No |
ClinGen ExAC gnomAD |
|
|
rs1289546951 CA392909801 |
257 | F>I | No |
ClinGen gnomAD |
|
|
rs1281276695 CA392909894 |
259 | Y>C | No |
ClinGen TOPMed |
|
|
CA392909903 rs780660331 |
260 | S>C | No |
ClinGen ExAC gnomAD |
|
|
CA7619134 rs780660331 |
260 | S>F | No |
ClinGen ExAC gnomAD |
|
|
rs747344244 CA7619135 |
262 | Y>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1216748268 CA392909920 |
262 | Y>H | No |
ClinGen gnomAD |
|
|
rs769077507 CA7619136 |
263 | M>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7619138 rs748385222 |
265 | T>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA392909971 rs1486376489 |
266 | C>F | No |
ClinGen gnomAD |
|
|
CA392909988 rs1185247607 |
268 | D>N | No |
ClinGen gnomAD |
|
|
CA7619141 rs762902857 |
269 | M>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
VAR_037713 CA7619140 rs2279854 |
269 | M>L | No |
ClinGen UniProt 1000Genomes ESP ExAC TOPMed dbSNP gnomAD |
|
|
rs766200645 CA7619143 |
270 | D>E | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs759397239 CA7619144 |
271 | W>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs373527522 CA7619145 |
273 | V>M | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1209895492 CA392910587 |
274 | L>F | No |
ClinGen TOPMed gnomAD |
|
|
CA392910591 rs1395162262 |
274 | L>P | No |
ClinGen TOPMed |
|
|
CA7619146 rs752337662 |
276 | W>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7619147 rs143107393 |
278 | R>C | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen 1000Genomes ExAC NCI-TCGA gnomAD |
|
rs763619140 CA7619148 |
278 | R>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs763619140 CA7619149 |
278 | R>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7619150 rs756832499 |
280 | T>I | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA gnomAD |
|
rs1596219932 CA392910705 |
281 | L>P | No |
ClinGen Ensembl |
|
|
CA392910719 rs1433288947 |
282 | W>* | No |
ClinGen gnomAD |
|
|
CA7619151 rs780422519 |
282 | W>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA392910736 rs1268748226 |
284 | P>T | No |
ClinGen TOPMed gnomAD |
|
|
rs747573828 CA7619152 |
285 | L>I | No |
ClinGen ExAC gnomAD |
|
|
CA392910796 rs1475066302 |
290 | C>R | No |
ClinGen TOPMed |
|
|
CA392910794 rs1475066302 |
290 | C>S | No |
ClinGen TOPMed |
|
|
rs755279233 CA7619153 |
292 | A>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7619155 rs748332173 |
294 | A>T | No |
ClinGen ExAC gnomAD |
|
|
rs1255087009 CA392910888 |
294 | A>V | No |
ClinGen gnomAD |
|
|
CA392910930 rs1431616682 |
298 | I>M | No |
ClinGen gnomAD |
|
|
rs1483992034 CA392910927 |
298 | I>T | No |
ClinGen TOPMed |
|
| TCGA novel | 300 | S>C | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA7619178 rs777850690 |
302 | P>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7619177 rs777850690 |
302 | P>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7619180 rs375035246 |
303 | I>T | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA7619181 rs372783305 |
305 | N>S | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1401304147 CA392911018 |
306 | E>D | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA gnomAD |
|
rs151201949 CA7619182 |
308 | G>R | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs760383344 CA7619184 |
309 | R>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs768554778 CA7619185 |
309 | R>Q | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
CA392911097 rs1396829567 |
314 | L>W | No |
ClinGen TOPMed |
|
|
CA392911109 rs367653111 |
315 | P>L | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA7619187 rs367653111 |
315 | P>Q | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
COSM329576 CA392911125 rs1274765274 |
317 | P>S | haematopoietic_and_lymphoid_tissue [Cosmic] | No |
ClinGen cosmic curated gnomAD |
|
rs1245380515 CA392911156 |
320 | I>V | No |
ClinGen TOPMed gnomAD |
|
|
CA7619189 rs749961093 |
322 | V>F | No |
ClinGen ExAC gnomAD |
|
|
CA7619190 rs749961093 |
322 | V>I | No |
ClinGen ExAC gnomAD |
|
|
rs1172761352 CA392911204 |
324 | F>C | No |
ClinGen TOPMed |
|
|
CA7619192 rs186765496 |
327 | F>L | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs750462682 CA271605122 |
329 | Q>H | No |
ClinGen Ensembl |
|
| TCGA novel | 332 | L>P | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA271605131 rs900253172 |
333 | I>M | No |
ClinGen TOPMed |
|
|
CA271605127 rs1046241933 |
333 | I>T | No |
ClinGen Ensembl |
|
|
CA7619194 rs756425080 |
334 | M>I | No |
ClinGen ExAC gnomAD |
|
|
rs1475791000 CA392911312 |
334 | M>K | No |
ClinGen gnomAD |
|
|
CA7619193 rs753317826 |
334 | M>V | No |
ClinGen ExAC gnomAD |
|
|
rs1567341336 CA392911330 |
336 | F>I | No |
ClinGen Ensembl |
|
|
rs1190686714 CA392895791 |
338 | G>D | No |
ClinGen gnomAD |
|
|
rs746978806 CA7619204 |
339 | L>V | No |
ClinGen ExAC gnomAD |
|
|
CA7619205 rs768267146 |
341 | I>L | No |
ClinGen ExAC gnomAD |
|
|
rs776518643 CA7619206 |
341 | I>M | No |
ClinGen ExAC gnomAD |
|
|
CA392895814 rs1375172539 |
342 | N>D | No |
ClinGen TOPMed gnomAD |
|
|
CA392895813 COSM193958 rs1375172539 |
342 | N>H | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated NCI-TCGA TOPMed gnomAD |
|
rs969154887 CA271556007 |
342 | N>S | No |
ClinGen TOPMed gnomAD |
|
|
rs769410818 CA7619208 |
344 | R>C | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
rs772887184 CA7619209 |
344 | R>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7619210 rs533555434 |
347 | Y>C | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA271556062 rs1032832846 |
348 | K>E | No |
ClinGen gnomAD |
|
|
CA392895867 rs1395210871 |
349 | Q>H | No |
ClinGen TOPMed gnomAD |
|
|
CA392895860 rs1225963088 |
349 | Q>K | No |
ClinGen Ensembl |
|
|
CA7619211 rs765935739 |
350 | R>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs200829921 CA7619212 |
350 | R>H | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA271556070 rs924133165 |
351 | R>K | No |
ClinGen TOPMed |
|
|
CA7619214 rs764328609 |
352 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs570358225 CA7619213 |
352 | R>W | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA7619215 rs192711057 |
353 | R>C | No |
ClinGen 1000Genomes ESP ExAC gnomAD |
|
|
rs199662967 CA7619216 COSM964078 |
353 | R>H | Variant assessed as Somatic; 0.0 impact. endometrium [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated 1000Genomes ESP ExAC NCI-TCGA TOPMed gnomAD |
|
CA392895883 rs199662967 |
353 | R>L | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs770473810 CA271556105 |
354 | Y>* | No |
ClinGen gnomAD |
|
|
rs762220982 CA271556089 |
354 | Y>F | No |
ClinGen Ensembl |
|
| TCGA novel | 358 | K>R | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA392895922 rs1264231950 |
359 | K>E | No |
ClinGen TOPMed gnomAD |
No associated diseases with Q9P035
1 regional properties for Q9P035
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| domain | CS domain | 5 - 94 | IPR007052 |
Functions
| Description | ||
|---|---|---|
| EC Number | 4.2.1.134 | Hydro-lyases |
| Subcellular Localization |
|
|
| PANTHER Family | ||
| PANTHER Subfamily | ||
| PANTHER Protein Class | ||
| PANTHER Pathway Category | No pathway information available | |
4 GO annotations of cellular component
| Name | Definition |
|---|---|
| endoplasmic reticulum | The irregular network of unit membranes, visible only by electron microscopy, that occurs in the cytoplasm of many eukaryotic cells. The membranes form a complex meshwork of tubular channels, which are often expanded into slitlike cavities called cisternae. The ER takes two forms, rough (or granular), with ribosomes adhering to the outer surface, and smooth (with no ribosomes attached). |
| focal adhesion | A cell-substrate junction that anchors the cell to the extracellular matrix and that forms a point of termination of actin filaments. In insects focal adhesion has also been referred to as hemi-adherens junction (HAJ). |
| integral component of endoplasmic reticulum membrane | The component of the endoplasmic reticulum membrane consisting of the gene products and protein complexes having at least some part of their peptide sequence embedded in the hydrophobic region of the membrane. |
| nuclear membrane | Either of the lipid bilayers that surround the nucleus and form the nuclear envelope; excludes the intermembrane space. |
7 GO annotations of molecular function
| Name | Definition |
|---|---|
| 3-hydroxy-arachidoyl-CoA dehydratase activity | Catalysis of the reaction: (R)-3-hydroxyicosanoyl-CoA <=> trans-2-icosenoyl-CoA + H2O. |
| 3-hydroxy-behenoyl-CoA dehydratase activity | Catalysis of the reaction: (R)-3-hydroxybehenoyl-CoA <=> trans-2-docosenoyl-CoA + H2O. |
| 3-hydroxy-lignoceroyl-CoA dehydratase activity | Catalysis of the reaction: (R)-3-hydroxylignoceroyl-CoA(4-) <=> trans-2-tetracosenoyl-CoA + H2O. |
| 3-hydroxyacyl-CoA dehydratase activity | Catalysis of the reaction: alkene-CoA + H2O = alcohol-CoA. Substrates are crotonoyl-CoA (producing 3-hydroxyacyl-CoA) and 2,3-didehydro-pimeloyl-CoA (producing 3-hydroxypimeloyl-CoA). |
| enzyme binding | Binding to an enzyme, a protein with catalytic activity. |
| GTPase activator activity | Binds to and increases the activity of a GTPase, an enzyme that catalyzes the hydrolysis of GTP. |
| very-long-chain 3-hydroxyacyl-CoA dehydratase activity | Catalysis of the reaction: a very-long-chain (3R)-3-hydroxyacyl-CoA = H2O + a very-long-chain trans-2,3-dehydroacyl-CoA. |
10 GO annotations of biological process
| Name | Definition |
|---|---|
| fatty acid elongation | The elongation of a fatty acid chain by the sequential addition of two-carbon units. |
| I-kappaB kinase/NF-kappaB signaling | The process in which a signal is passed on to downstream components within the cell through the I-kappaB-kinase (IKK)-dependent activation of NF-kappaB. The cascade begins with activation of a trimeric IKK complex (consisting of catalytic kinase subunits IKKalpha and/or IKKbeta, and the regulatory scaffold protein NEMO) and ends with the regulation of transcription of target genes by NF-kappaB. In a resting state, NF-kappaB dimers are bound to I-kappaB proteins, sequestering NF-kappaB in the cytoplasm. Phosphorylation of I-kappaB targets I-kappaB for ubiquitination and proteasomal degradation, thus releasing the NF-kappaB dimers, which can translocate to the nucleus to bind DNA and regulate transcription. |
| JNK cascade | An intracellular protein kinase cascade containing at least a JNK (a MAPK), a JNKK (a MAPKK) and a JUN3K (a MAP3K). The cascade can also contain an additional tier: the upstream MAP4K. The kinases in each tier phosphorylate and activate the kinases in the downstream tier to transmit a signal within a cell. |
| positive regulation by virus of viral protein levels in host cell | Any process where the infecting virus increases the levels of viral proteins in a cell. |
| positive regulation of viral genome replication | Any process that activates or increases the frequency, rate or extent of viral genome replication. |
| Rac protein signal transduction | The series of molecular signals within the cell that are mediated by a member of the Rac family of proteins switching to a GTP-bound active state. |
| Rho protein signal transduction | The series of molecular signals within the cell that are mediated by a member of the Rho family of proteins switching to a GTP-bound active state. |
| small GTPase mediated signal transduction | The series of molecular signals in which a small monomeric GTPase relays a signal. |
| sphingolipid biosynthetic process | The chemical reactions and pathways resulting in the formation of sphingolipids, any of a class of lipids containing the long-chain amine diol sphingosine or a closely related base (a sphingoid). |
| very long-chain fatty acid biosynthetic process | The chemical reactions and pathways resulting in the formation of a fatty acid which has a chain length greater than C22. |
4 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| Q2KIP8 | HACD2 | Very-long-chain (3R)-3-hydroxyacyl-CoA dehydratase 2 | Bos taurus (Bovine) | PR |
| Q6Y1H2 | HACD2 | Very-long-chain (3R)-3-hydroxyacyl-CoA dehydratase 2 | Homo sapiens (Human) | PR |
| Q9D3B1 | Hacd2 | Very-long-chain (3R)-3-hydroxyacyl-CoA dehydratase 2 | Mus musculus (Mouse) | PR |
| Q7SY06 | hacd3 | Very-long-chain (3R)-3-hydroxyacyl-CoA dehydratase | Danio rerio (Zebrafish) (Brachydanio rerio) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MENQVLTPHV | YWAQRHRELY | LRVELSDVQN | PAISITENVL | HFKAQGHGAK | GDNVYEFHLE |
| 70 | 80 | 90 | 100 | 110 | 120 |
| FLDLVKPEPV | YKLTQRQVNI | TVQKKVSQWW | ERLTKQEKRP | LFLAPDFDRW | LDESDAEMEL |
| 130 | 140 | 150 | 160 | 170 | 180 |
| RAKEEERLNK | LRLESEGSPE | TLTNLRKGYL | FMYNLVQFLG | FSWIFVNLTV | RFCILGKESF |
| 190 | 200 | 210 | 220 | 230 | 240 |
| YDTFHTVADM | MYFCQMLAVV | ETINAAIGVT | TSPVLPSLIQ | LLGRNFILFI | IFGTMEEMQN |
| 250 | 260 | 270 | 280 | 290 | 300 |
| KAVVFFVFYL | WSAIEIFRYS | FYMLTCIDMD | WKVLTWLRYT | LWIPLYPLGC | LAEAVSVIQS |
| 310 | 320 | 330 | 340 | 350 | 360 |
| IPIFNETGRF | SFTLPYPVKI | KVRFSFFLQI | YLIMIFLGLY | INFRHLYKQR | RRRYGQKKKK |
| IH |