Q6Y1H2
Gene name |
HACD2 |
Protein name |
Very-long-chain (3R)-3-hydroxyacyl-CoA dehydratase 2 |
Names |
3-hydroxyacyl-CoA dehydratase 2, HACD2, Protein-tyrosine phosphatase-like member B |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:201562 |
EC number |
4.2.1.134: Hydro-lyases |
Protein Class |
|
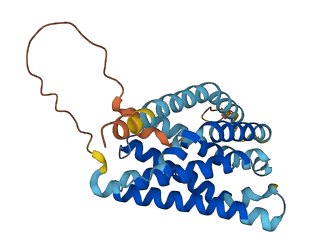
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for Q6Y1H2
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-Q6Y1H2-F1 | Predicted | AlphaFoldDB |
157 variants for Q6Y1H2
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
rs1354534107 CA354226917 |
2 | A>E | No |
ClinGen TOPMed gnomAD |
|
|
rs1354534107 CA354226915 |
2 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
rs958343304 CA82920167 |
3 | A>S | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA gnomAD |
|
rs1034065745 CA82920159 |
3 | A>V | No |
ClinGen gnomAD |
|
|
rs1185487869 CA354226909 |
4 | V>L | No |
ClinGen TOPMed gnomAD |
|
|
rs1441850939 CA354226900 |
5 | A>G | No |
ClinGen TOPMed gnomAD |
|
|
CA354226899 rs1441850939 |
5 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
rs756207969 CA2577927 |
6 | A>T | No |
ClinGen ExAC gnomAD |
|
|
CA2577926 rs563998127 |
6 | A>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA354226893 rs76323937 |
7 | T>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA2577925 rs76323937 |
7 | T>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA82920137 rs1010471748 |
8 | A>E | No |
ClinGen Ensembl |
|
|
rs1257166996 CA354226889 |
8 | A>T | No |
ClinGen gnomAD |
|
|
rs762215697 CA2577924 |
9 | A>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs975738295 CA82920136 |
10 | A>T | No |
ClinGen TOPMed |
|
|
CA82920130 rs966188875 |
10 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
CA2577923 rs751944112 |
11 | K>E | No |
ClinGen ExAC gnomAD |
|
|
CA354226872 rs1405418647 |
11 | K>R | No |
ClinGen TOPMed |
|
|
rs1389276454 CA354226866 |
12 | G>E | No |
ClinGen gnomAD |
|
|
rs1041333420 CA82920125 |
12 | G>R | No |
ClinGen Ensembl |
|
|
CA354226862 rs1398626340 |
13 | N>D | No |
ClinGen gnomAD |
|
|
rs940386499 CA82920123 |
13 | N>K | No |
ClinGen Ensembl |
|
|
rs1006897158 CA82920120 |
14 | G>A | No |
ClinGen gnomAD |
|
|
CA82920121 rs1017328901 CA354226856 |
14 | G>R | No |
ClinGen TOPMed |
|
|
rs764400986 CA2577922 |
15 | G>D | No |
ClinGen ExAC gnomAD |
|
|
CA354226851 rs1420667322 |
15 | G>R | No |
ClinGen gnomAD |
|
|
CA354226852 rs1420667322 |
15 | G>S | No |
ClinGen gnomAD |
|
|
rs764400986 CA354226848 |
15 | G>V | No |
ClinGen ExAC gnomAD |
|
|
rs1237413068 CA354226832 |
18 | G>D | No |
ClinGen gnomAD |
|
|
CA354226833 rs1438030333 |
18 | G>S | No |
ClinGen gnomAD |
|
|
rs1469603646 CA354226825 |
19 | R>M | No |
ClinGen gnomAD |
|
|
CA354226822 rs770404869 |
20 | A>P | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA2577917 rs770404869 |
20 | A>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA354226818 rs1209127115 |
20 | A>V | No |
ClinGen gnomAD |
|
|
rs1280768729 CA354226817 |
21 | G>R | No |
ClinGen gnomAD |
|
|
rs1375673462 CA354226811 |
22 | A>T | No |
ClinGen gnomAD |
|
|
rs1397088165 CA354226805 |
23 | G>R | No |
ClinGen gnomAD |
|
|
CA354226800 rs1322170823 |
23 | G>V | No |
ClinGen gnomAD |
|
|
rs903219191 CA82919994 |
25 | A>D | No |
ClinGen TOPMed |
|
|
CA82919989 rs1046155906 |
26 | S>R | No |
ClinGen TOPMed gnomAD |
|
|
rs1405267630 CA354226782 |
26 | S>T | No |
ClinGen gnomAD |
|
|
rs1364766166 CA354226779 |
27 | G>S | No |
ClinGen TOPMed |
|
|
CA354226768 rs1160367797 |
28 | T>M | No |
ClinGen TOPMed gnomAD |
|
|
rs751244609 CA82919964 |
29 | R>G | No |
ClinGen TOPMed gnomAD |
|
|
rs1194432814 CA354226766 |
29 | R>Q | No |
ClinGen gnomAD |
|
|
CA354226767 rs751244609 |
29 | R>W | No |
ClinGen TOPMed gnomAD |
|
|
CA82919957 rs1037232646 |
31 | K>N | No |
ClinGen Ensembl |
|
|
rs748046625 CA354226731 |
34 | P>L | No |
ClinGen ExAC gnomAD |
|
|
rs748046625 CA2577913 |
34 | P>Q | No |
ClinGen ExAC gnomAD |
|
|
CA354226730 rs748046625 |
34 | P>R | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 35 | G>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs950041598 CA82919944 |
36 | P>L | No |
ClinGen TOPMed |
|
|
CA354226721 rs1424710460 |
36 | P>S | No |
ClinGen TOPMed |
|
|
rs1285809148 CA354226713 |
38 | A>T | No |
ClinGen gnomAD |
|
|
CA354226708 rs1213837466 |
38 | A>V | No |
ClinGen gnomAD |
|
|
CA354226678 rs1235977278 |
43 | V>A | No |
ClinGen gnomAD |
|
|
CA2577909 rs780321212 |
44 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs1370179713 CA354226658 |
46 | N>S | No |
ClinGen gnomAD |
|
|
CA354226652 rs1436481950 |
47 | V>M | No |
ClinGen gnomAD |
|
|
CA354226636 rs1327518419 |
49 | M>I | No |
ClinGen gnomAD |
|
|
rs1320787929 CA354226628 |
50 | T>I | No |
ClinGen gnomAD |
|
|
CA82919912 rs918193664 |
52 | G>R | No |
ClinGen TOPMed |
|
|
CA354226601 rs1421323359 |
53 | W>* | No |
ClinGen gnomAD |
|
|
rs1418033354 CA354226572 |
57 | A>V | No |
ClinGen gnomAD |
|
|
CA354226571 rs1481956035 |
58 | V>I | No |
ClinGen gnomAD |
|
|
rs1236540945 CA354226558 |
60 | L>V | No |
ClinGen gnomAD |
|
|
rs1204730931 CA354226548 |
62 | R>* | No |
ClinGen gnomAD |
|
|
CA2577899 COSM1222513 rs753498940 |
62 | R>Q | large_intestine [Cosmic] | No |
ClinGen cosmic curated ExAC gnomAD |
|
rs1260373468 CA354226531 |
64 | Y>* | No |
ClinGen gnomAD |
|
|
rs1576251106 CA354226534 |
64 | Y>S | No |
ClinGen Ensembl |
|
|
rs1217383596 CA354226511 |
68 | G>S | No |
ClinGen gnomAD |
|
|
rs1044868434 CA82918175 |
69 | S>G | No |
ClinGen Ensembl |
|
|
CA354226488 rs1230101731 |
71 | H>Y | No |
ClinGen gnomAD |
|
|
CA2577897 rs760148302 |
72 | S>G | No |
ClinGen ExAC gnomAD |
|
|
rs1315084541 CA354226475 |
73 | L>I | No |
ClinGen TOPMed |
|
|
CA2577896 rs760203086 |
77 | I>F | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA2577895 rs760203086 |
77 | I>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA354226429 rs1222198218 |
79 | K>N | No |
ClinGen gnomAD |
|
|
CA2577894 rs761859365 |
79 | K>R | No |
ClinGen ExAC gnomAD |
|
|
CA2577893 rs774420049 |
83 | F>L | No |
ClinGen ExAC gnomAD |
|
|
CA354226401 rs1559939528 |
83 | F>L | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen Ensembl NCI-TCGA |
|
rs768641838 CA2577892 |
85 | Q>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA354226380 rs1166927971 |
86 | T>S | No |
ClinGen gnomAD |
|
| TCGA novel | 87 | G>R | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs201451076 CA354226360 |
89 | L>F | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA354360165 rs1487788652 |
92 | I>F | No |
ClinGen gnomAD |
|
|
rs1333206814 CA354360150 |
94 | H>P | No |
ClinGen TOPMed |
|
|
rs769409686 CA2577870 |
96 | A>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1323335165 CA354360128 |
97 | I>M | No |
ClinGen TOPMed |
|
|
rs776818290 CA2577868 |
97 | I>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA2577869 rs746115507 |
97 | I>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1576752803 CA354357427 |
104 | V>L | No |
ClinGen Ensembl |
|
|
rs771975073 CA2577843 |
107 | T>N | No |
ClinGen ExAC gnomAD |
|
|
rs779287470 CA2577841 |
109 | F>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1332456218 CA354357321 |
112 | M>L | No |
ClinGen gnomAD |
|
|
CA354357309 rs1467698772 |
113 | S>P | No |
ClinGen gnomAD |
|
|
rs755413416 CA2577840 |
115 | V>I | No |
ClinGen ExAC gnomAD |
|
|
CA354357214 rs1370241649 |
120 | A>P | No |
ClinGen gnomAD |
|
|
rs749651424 CA354357156 |
124 | S>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs202187144 CA2577838 COSM1222514 |
125 | V>I | large_intestine [Cosmic] | No |
ClinGen cosmic curated ESP ExAC TOPMed gnomAD |
|
rs969715983 CA82674349 |
128 | V>I | No |
ClinGen TOPMed gnomAD |
|
|
rs969715983 CA354361898 |
128 | V>L | No |
ClinGen TOPMed gnomAD |
|
|
rs1488737312 CA354361891 |
129 | Q>R | No |
ClinGen TOPMed |
|
|
CA354361882 rs1308974718 |
130 | S>N | No |
ClinGen gnomAD |
|
|
rs757965940 CA2577814 |
132 | D>G | No |
ClinGen ExAC gnomAD |
|
|
rs772337479 CA2577815 |
132 | D>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1322085755 CA354361863 |
133 | S>G | No |
ClinGen gnomAD |
|
|
rs376091382 CA2577813 |
134 | V>I | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs187536577 CA2577811 |
139 | I>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1172940372 CA354361819 |
140 | A>P | No |
ClinGen gnomAD |
|
|
CA82674305 rs759685166 |
142 | T>M | No |
ClinGen TOPMed gnomAD |
|
|
CA2577808 rs760461596 |
144 | T>M | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
CA354361780 rs1369315313 |
146 | I>V | No |
ClinGen TOPMed |
|
|
CA82674292 rs998954069 |
148 | R>H | No |
ClinGen gnomAD |
|
|
CA354361737 rs1198174555 |
152 | Y>D | No |
ClinGen gnomAD |
|
| TCGA novel | 157 | L>F | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA82674281 rs998759673 |
158 | N>S | No |
ClinGen Ensembl |
|
|
CA354361638 rs1273614263 |
166 | W>S | No |
ClinGen gnomAD |
|
|
rs767616459 CA2577806 |
167 | A>G | No |
ClinGen ExAC gnomAD |
|
|
rs1266151659 CA354361509 |
169 | Y>H | No |
ClinGen TOPMed |
|
|
rs551524227 CA2577790 |
173 | I>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA2577789 rs370361667 |
175 | L>P | No |
ClinGen ESP ExAC gnomAD |
|
| TCGA novel | 176 | Y>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1471598392 CA354361388 |
179 | G>R | No |
ClinGen gnomAD |
|
|
rs767305204 CA2577787 |
180 | V>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs750212186 CA2577788 |
180 | V>L | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 181 | S>L | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
| TCGA novel | 182 | G>missing | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1576726526 CA354361335 |
184 | L>M | No |
ClinGen Ensembl |
|
|
CA354361117 rs1314564712 |
203 | S>N | No |
ClinGen gnomAD |
|
| TCGA novel | 207 | K>T | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA2577783 rs377706797 |
209 | N>S | No |
ClinGen ESP ExAC TOPMed |
|
| TCGA novel | 212 | F>I | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA2577782 rs776178578 |
215 | Y>C | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 220 | L>I | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA2577781 rs765817322 |
220 | L>V | No |
ClinGen ExAC gnomAD |
|
|
rs1392068761 CA354360956 |
221 | I>T | No |
ClinGen TOPMed |
|
|
rs1353736951 CA354360914 |
227 | P>T | No |
ClinGen TOPMed gnomAD |
|
|
rs1428766752 CA354360892 |
228 | I>S | No |
ClinGen gnomAD |
|
|
CA354360879 rs1194482771 |
230 | P>H | No |
ClinGen gnomAD |
|
| rs34131865 | 231 | Q>P | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA354360814 rs1261328475 |
238 | H>Q | No |
ClinGen gnomAD |
|
|
rs1204732954 CA354360811 |
239 | Q>* | No |
ClinGen gnomAD |
|
|
rs867150647 CA82671226 |
239 | Q>H | No |
ClinGen Ensembl |
|
|
CA354360786 rs768324602 |
242 | K>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1007756980 CA82671225 |
245 | S>F | No |
ClinGen TOPMed gnomAD |
|
|
rs1322721310 CA354360761 |
246 | H>P | No |
ClinGen gnomAD |
|
|
rs1278703757 CA354360757 |
247 | T>A | No |
ClinGen gnomAD |
|
|
rs748902443 CA2577755 |
247 | T>N | No |
ClinGen ExAC gnomAD |
|
|
rs1342702893 CA354360749 |
248 | E>A | No |
ClinGen TOPMed |
|
|
rs868234354 CA82671221 |
249 | E>* | No |
ClinGen gnomAD |
|
|
rs868234354 CA354360745 |
249 | E>K | No |
ClinGen gnomAD |
|
|
CA82671220 rs867980709 |
250 | H>Q | No |
ClinGen Ensembl |
|
|
rs377404803 CA2577754 |
250 | H>Y | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1277134034 CA354360728 |
251 | K>R | No |
ClinGen TOPMed |
|
|
rs1403426310 CA354360707 |
254 | E>Q | No |
ClinGen gnomAD |
|
| TCGA novel | 255 | E>W | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
No associated diseases with Q6Y1H2
No regional properties for Q6Y1H2
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| No domain, repeats, and functional sites for Q6Y1H2 | |||
Functions
| Description | ||
|---|---|---|
| EC Number | 4.2.1.134 | Hydro-lyases |
| Subcellular Localization |
|
|
| PANTHER Family | ||
| PANTHER Subfamily | ||
| PANTHER Protein Class | ||
| PANTHER Pathway Category | No pathway information available | |
3 GO annotations of cellular component
| Name | Definition |
|---|---|
| endoplasmic reticulum | The irregular network of unit membranes, visible only by electron microscopy, that occurs in the cytoplasm of many eukaryotic cells. The membranes form a complex meshwork of tubular channels, which are often expanded into slitlike cavities called cisternae. The ER takes two forms, rough (or granular), with ribosomes adhering to the outer surface, and smooth (with no ribosomes attached). |
| endoplasmic reticulum membrane | The lipid bilayer surrounding the endoplasmic reticulum. |
| integral component of endoplasmic reticulum membrane | The component of the endoplasmic reticulum membrane consisting of the gene products and protein complexes having at least some part of their peptide sequence embedded in the hydrophobic region of the membrane. |
7 GO annotations of molecular function
| Name | Definition |
|---|---|
| 3-hydroxy-arachidoyl-CoA dehydratase activity | Catalysis of the reaction: (R)-3-hydroxyicosanoyl-CoA <=> trans-2-icosenoyl-CoA + H2O. |
| 3-hydroxy-behenoyl-CoA dehydratase activity | Catalysis of the reaction: (R)-3-hydroxybehenoyl-CoA <=> trans-2-docosenoyl-CoA + H2O. |
| 3-hydroxy-lignoceroyl-CoA dehydratase activity | Catalysis of the reaction: (R)-3-hydroxylignoceroyl-CoA(4-) <=> trans-2-tetracosenoyl-CoA + H2O. |
| 3-hydroxyacyl-CoA dehydratase activity | Catalysis of the reaction: alkene-CoA + H2O = alcohol-CoA. Substrates are crotonoyl-CoA (producing 3-hydroxyacyl-CoA) and 2,3-didehydro-pimeloyl-CoA (producing 3-hydroxypimeloyl-CoA). |
| 3R-hydroxyacyl-CoA dehydratase activity | Catalysis of the reaction: 3R-hydroxyacyl-CoA = 2E-enoyl-CoA + H2O. |
| enzyme binding | Binding to an enzyme, a protein with catalytic activity. |
| very-long-chain 3-hydroxyacyl-CoA dehydratase activity | Catalysis of the reaction: a very-long-chain (3R)-3-hydroxyacyl-CoA = H2O + a very-long-chain trans-2,3-dehydroacyl-CoA. |
4 GO annotations of biological process
| Name | Definition |
|---|---|
| fatty acid elongation | The elongation of a fatty acid chain by the sequential addition of two-carbon units. |
| long-chain fatty-acyl-CoA biosynthetic process | The chemical reactions and pathways resulting in the formation of a long-chain fatty-acyl-CoA any derivative of coenzyme A in which the sulfhydryl group is in a thioester linkage with a long-chain fatty-acyl group. Long-chain fatty-acyl-CoAs have chain lengths of C13 or more. |
| sphingolipid biosynthetic process | The chemical reactions and pathways resulting in the formation of sphingolipids, any of a class of lipids containing the long-chain amine diol sphingosine or a closely related base (a sphingoid). |
| very long-chain fatty acid biosynthetic process | The chemical reactions and pathways resulting in the formation of a fatty acid which has a chain length greater than C22. |
4 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| Q2KIP8 | HACD2 | Very-long-chain (3R)-3-hydroxyacyl-CoA dehydratase 2 | Bos taurus (Bovine) | PR |
| Q9P035 | HACD3 | Very-long-chain (3R)-3-hydroxyacyl-CoA dehydratase 3 | Homo sapiens (Human) | PR |
| Q9D3B1 | Hacd2 | Very-long-chain (3R)-3-hydroxyacyl-CoA dehydratase 2 | Mus musculus (Mouse) | PR |
| Q7SY06 | hacd3 | Very-long-chain (3R)-3-hydroxyacyl-CoA dehydratase | Danio rerio (Zebrafish) (Brachydanio rerio) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MAAVAATAAA | KGNGGGGGRA | GAGDASGTRK | KKGPGPLATA | YLVIYNVVMT | AGWLVIAVGL |
| 70 | 80 | 90 | 100 | 110 | 120 |
| VRAYLAKGSY | HSLYYSIEKP | LKFFQTGALL | EILHCAIGIV | PSSVVLTSFQ | VMSRVFLIWA |
| 130 | 140 | 150 | 160 | 170 | 180 |
| VTHSVKEVQS | EDSVLLFVIA | WTITEIIRYS | FYTFSLLNHL | PYLIKWARYT | LFIVLYPMGV |
| 190 | 200 | 210 | 220 | 230 | 240 |
| SGELLTIYAA | LPFVRQAGLY | SISLPNKYNF | SFDYYAFLIL | IMISYIPIFP | QLYFHMIHQR |
| 250 | |||||
| RKILSHTEEH | KKFE |