Q9NQE9
Gene name |
HINT3 |
Protein name |
Adenosine 5'-monophosphoramidase HINT3 |
Names |
Histidine triad nucleotide-binding protein 3, HINT-3 |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:135114 |
EC number |
|
Protein Class |
|
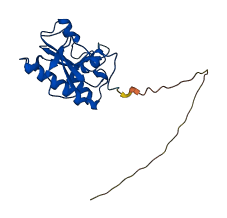
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for Q9NQE9
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-Q9NQE9-F1 | Predicted | AlphaFoldDB |
152 variants for Q9NQE9
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
CA365504031 rs1240302901 |
5 | Q>R | No |
ClinGen gnomAD |
|
|
rs1052697427 CA147166082 |
6 | V>G | No |
ClinGen Ensembl |
|
|
CA365504054 rs1284648874 |
7 | N>K | No |
ClinGen gnomAD |
|
|
rs571982659 CA3987399 |
8 | R>H | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA3987398 rs571982659 |
8 | R>P | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA365504081 rs1215071585 |
9 | S>I | No |
ClinGen gnomAD |
|
|
rs1285511399 CA365504073 |
9 | S>R | No |
ClinGen TOPMed gnomAD |
|
|
rs1443290773 CA365504095 |
10 | A>D | No |
ClinGen gnomAD |
|
|
CA365504093 rs1281188500 |
10 | A>S | No |
ClinGen gnomAD |
|
|
CA365504088 rs1281188500 |
10 | A>T | No |
ClinGen gnomAD |
|
|
CA3987400 rs568451027 |
12 | L>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA365504130 rs1235899515 |
13 | A>V | No |
ClinGen gnomAD |
|
|
rs1441759924 CA365504157 |
16 | C>R | No |
ClinGen gnomAD |
|
|
CA365504193 rs780714215 |
18 | A>D | No |
ClinGen gnomAD |
|
|
rs780714215 CA147166109 |
18 | A>G | No |
ClinGen gnomAD |
|
|
rs1174487408 CA365504187 |
18 | A>T | No |
ClinGen TOPMed |
|
|
rs921477725 CA365504204 |
19 | S>* | No |
ClinGen TOPMed |
|
|
rs921477725 CA147166112 |
19 | S>L | No |
ClinGen TOPMed |
|
|
CA365504230 rs1413649035 |
22 | A>E | No |
ClinGen TOPMed gnomAD |
|
|
rs1172302277 CA365504225 |
22 | A>T | No |
ClinGen TOPMed |
|
|
rs1331925405 CA365504248 |
24 | T>A | No |
ClinGen gnomAD |
|
|
rs932314563 CA147166113 |
25 | T>M | No |
ClinGen TOPMed gnomAD |
|
|
rs932314563 CA365504263 |
25 | T>R | No |
ClinGen TOPMed gnomAD |
|
|
rs780897427 CA3987403 |
27 | S>T | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 28 | S>Q | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA147166120 rs147213100 |
29 | V>L | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA147166119 rs147213100 |
29 | V>M | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA365504313 rs1238618773 |
30 | G>E | No |
ClinGen gnomAD |
|
|
rs1257670759 CA365504311 |
30 | G>R | No |
ClinGen TOPMed |
|
| TCGA novel | 31 | T>P | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1277081776 CA365504336 |
32 | C>Y | No |
ClinGen gnomAD |
|
|
rs1346181670 CA365504344 |
33 | E>K | No |
ClinGen TOPMed gnomAD |
|
|
CA147166123 rs978651628 |
35 | A>S | No |
ClinGen TOPMed gnomAD |
|
|
rs978651628 CA365504371 |
35 | A>T | No |
ClinGen TOPMed gnomAD |
|
|
rs2295005 VAR_039734 CA3987405 |
36 | G>A | 2.5-fold increase in affinity for indolepropinoic acyl-adenylate and cytosine; 2-fold decrease in hypoxanthine affinity; nearly no change in affinity for adenine, guanine and uracil [UniProt] | No |
ClinGen UniProt 1000Genomes ESP ExAC TOPMed dbSNP gnomAD |
|
rs2295005 CA365504385 |
36 | G>D | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs2295005 CA365504386 |
36 | G>V | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA3987406 rs774879956 |
39 | P>L | No |
ClinGen ExAC |
|
|
rs1419891850 CA365504428 |
39 | P>S | No |
ClinGen gnomAD |
|
|
rs868163659 CA147166163 |
41 | P>A | No |
ClinGen TOPMed gnomAD |
|
|
rs868163659 CA147166161 |
41 | P>T | No |
ClinGen TOPMed gnomAD |
|
|
CA365504478 rs1170664709 |
42 | K>* | No |
ClinGen gnomAD |
|
|
CA3987407 rs746337859 |
42 | K>M | No |
ClinGen ExAC |
|
|
rs1170664709 CA365504472 |
42 | K>Q | No |
ClinGen gnomAD |
|
|
CA365504485 rs746337859 |
42 | K>R | No |
ClinGen ExAC |
|
|
CA365504536 rs1583586370 |
45 | D>N | No |
ClinGen Ensembl |
|
|
rs769350443 CA147166202 |
47 | T>A | No |
ClinGen Ensembl |
|
|
CA365504718 rs1333792603 |
51 | C>F | No |
ClinGen TOPMed |
|
|
CA365504734 rs1387964531 |
52 | R>Q | No |
ClinGen TOPMed gnomAD |
|
|
CA365504759 rs1410682117 |
54 | A>P | No |
ClinGen TOPMed |
|
|
rs200559049 CA3987410 |
55 | G>E | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1320382726 CA365504814 |
56 | R>Q | No |
ClinGen gnomAD |
|
|
CA147166240 rs923286744 |
56 | R>W | No |
ClinGen TOPMed gnomAD |
|
|
rs1257621925 CA365504825 |
57 | Q>* | No |
ClinGen gnomAD |
|
|
CA365504837 rs1211764047 |
57 | Q>H | No |
ClinGen TOPMed gnomAD |
|
|
rs1456587960 CA365504826 |
57 | Q>P | No |
ClinGen TOPMed gnomAD |
|
|
CA365504827 rs1456587960 |
57 | Q>R | No |
ClinGen TOPMed gnomAD |
|
|
rs1236490877 CA365504916 |
59 | P>S | No |
ClinGen TOPMed |
|
|
CA147166244 rs1053251163 |
63 | L>V | No |
ClinGen TOPMed gnomAD |
|
|
CA365505018 rs1207886123 |
64 | L>Q | No |
ClinGen TOPMed |
|
|
rs1169555347 CA365505048 |
65 | H>R | No |
ClinGen gnomAD |
|
|
CA365505027 rs1477996124 |
65 | H>Y | No |
ClinGen TOPMed gnomAD |
|
|
CA147166252 rs1014462759 |
66 | C>F | No |
ClinGen TOPMed gnomAD |
|
|
rs895668347 CA147166249 |
66 | C>S | No |
ClinGen Ensembl |
|
|
CA365505075 rs1014462759 |
66 | C>Y | No |
ClinGen TOPMed gnomAD |
|
|
rs1459097829 CA365505108 |
67 | E>* | No |
ClinGen TOPMed gnomAD |
|
|
rs752349900 CA365508068 |
68 | N>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs752349900 CA3987422 |
68 | N>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA147173784 rs933072922 |
75 | K>Q | No |
ClinGen Ensembl |
|
|
CA365508215 rs1215728969 |
76 | D>G | No |
ClinGen gnomAD |
|
|
rs772622280 CA147173798 |
77 | I>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3987426 rs772622280 |
77 | I>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3987425 rs746250111 |
77 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs377194909 CA3987427 |
78 | K>T | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA3987428 rs747510663 |
79 | P>S | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 81 | A>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1282577335 CA365508323 |
82 | T>A | No |
ClinGen gnomAD |
|
|
rs1380371789 CA365508326 |
82 | T>I | No |
ClinGen TOPMed gnomAD |
|
| TCGA novel | 82 | T>S | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA365508328 rs1420842772 |
83 | H>N | No |
ClinGen gnomAD |
|
|
rs369239656 CA3987429 |
83 | H>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1420842772 CA365508332 |
83 | H>Y | No |
ClinGen gnomAD |
|
|
CA365508389 rs1467863087 |
85 | Y>* | No |
ClinGen gnomAD |
|
|
rs1343823990 CA365508380 |
85 | Y>C | No |
ClinGen gnomAD |
|
|
rs776593581 CA3987430 |
92 | H>R | No |
ClinGen ExAC |
|
|
CA3987432 rs554638960 |
93 | I>L | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA3987433 rs114751741 |
93 | I>T | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA3987431 rs554638960 |
93 | I>V | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA3987435 rs766130928 |
96 | C>F | No |
ClinGen ExAC gnomAD |
|
|
rs762735911 CA3987434 |
96 | C>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs762735911 CA365508580 |
96 | C>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3987436 rs201833844 |
97 | R>* | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1319185198 CA365508708 |
100 | R>T | No |
ClinGen TOPMed |
|
|
CA3987438 CA365508764 rs767014894 |
102 | D>E | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3987440 rs755772437 |
104 | V>A | No |
ClinGen ExAC gnomAD |
|
|
COSM1254185 CA3987439 rs752259987 |
104 | V>I | oesophagus [Cosmic] | No |
ClinGen cosmic curated ExAC gnomAD |
| TCGA novel | 105 | E>* | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA365508844 rs1222769508 |
105 | E>G | No |
ClinGen TOPMed |
|
|
rs1483100814 CA365509594 |
107 | V>G | No |
ClinGen TOPMed |
|
| TCGA novel | 108 | E>D | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA365509601 rs1220112806 |
108 | E>G | No |
ClinGen gnomAD |
|
|
CA3987449 rs748237915 |
108 | E>K | No |
ClinGen ExAC gnomAD |
|
|
CA365509624 rs1457015354 |
110 | M>V | No |
ClinGen gnomAD |
|
|
CA365509651 rs1218477612 |
112 | T>S | No |
ClinGen TOPMed |
|
|
rs769916214 CA3987450 |
113 | V>L | No |
ClinGen ExAC gnomAD |
|
|
CA3987451 rs372560513 |
115 | K>Q | No |
ClinGen ESP ExAC gnomAD |
|
|
CA3987452 rs749563161 |
115 | K>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3987453 rs145594277 |
117 | I>V | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA147177578 rs905275353 |
119 | E>Q | No |
ClinGen TOPMed gnomAD |
|
|
rs774046468 CA3987454 |
122 | N>T | No |
ClinGen ExAC gnomAD |
|
|
CA3987456 rs147740313 |
126 | F>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3987457 rs199906226 |
127 | T>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3987459 rs763734703 |
128 | N>S | No |
ClinGen ExAC gnomAD |
|
|
CA3987460 rs377239838 |
130 | R>K | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs145709677 CA147179948 |
131 | M>I | No |
ClinGen 1000Genomes |
|
|
CA147179942 rs149760356 |
131 | M>T | No |
ClinGen 1000Genomes |
|
|
rs370635400 CA147179956 |
132 | G>D | No |
ClinGen ESP TOPMed |
|
|
CA3987484 rs755291518 |
134 | H>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs767922040 CA3987485 |
136 | P>S | No |
ClinGen ExAC gnomAD |
|
|
CA365510298 rs1239471829 |
137 | P>R | No |
ClinGen gnomAD |
|
|
rs1183128006 CA365510334 |
139 | C>S | No |
ClinGen gnomAD |
|
|
CA365510333 rs1183128006 |
139 | C>Y | No |
ClinGen gnomAD |
|
|
rs943963042 CA147179963 |
141 | I>V | No |
ClinGen TOPMed gnomAD |
|
|
rs756648725 CA3987487 |
142 | S>F | No |
ClinGen ExAC gnomAD |
|
|
rs1441468677 CA365510412 |
143 | H>R | No |
ClinGen gnomAD |
|
|
CA365510424 rs777764486 |
144 | L>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3987488 rs777764486 |
144 | L>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA3987489 rs749341560 |
146 | L>F | No |
ClinGen ExAC gnomAD |
|
|
rs757417568 CA3987492 |
152 | V>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs779000488 CA3987493 |
154 | Q>R | No |
ClinGen ExAC gnomAD |
|
|
rs968782678 CA147180012 |
156 | G>S | No |
ClinGen Ensembl |
|
| TCGA novel | 157 | F>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA365510730 rs1378401893 |
159 | S>F | No |
ClinGen gnomAD |
|
|
rs1465529904 CA365510739 |
160 | K>E | No |
ClinGen TOPMed |
|
|
CA3987495 rs771967946 |
160 | K>M | No |
ClinGen ExAC gnomAD |
|
|
CA365510755 CA365510752 rs1350552571 |
160 | K>N | No |
ClinGen gnomAD |
|
|
rs780017028 CA3987496 |
161 | L>S | No |
ClinGen ExAC gnomAD |
|
|
rs1203194233 CA365510822 |
163 | Y>* | No |
ClinGen gnomAD |
|
|
rs768715314 CA3987498 |
163 | Y>C | No |
ClinGen ExAC gnomAD |
|
|
rs776144718 CA3987499 |
164 | R>G | No |
ClinGen ExAC gnomAD |
|
|
CA3987500 rs761212828 |
165 | V>A | No |
ClinGen ExAC gnomAD |
|
|
rs577650419 CA3987501 |
166 | N>S | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen 1000Genomes ExAC NCI-TCGA TOPMed gnomAD |
|
rs772720084 CA3987502 |
167 | S>F | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
rs772720084 CA147180069 |
167 | S>Y | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA365510934 rs1174176015 |
169 | W>L | No |
ClinGen gnomAD |
|
|
CA147180077 rs202125498 |
172 | T>I | No |
ClinGen gnomAD |
|
|
rs1393604471 CA365511368 |
173 | A>V | No |
ClinGen gnomAD |
|
|
rs759601933 CA147182382 |
174 | D>H | No |
ClinGen gnomAD |
|
|
rs748153797 CA3987518 |
175 | H>P | No |
ClinGen ExAC gnomAD |
|
|
CA3987517 rs748153797 |
175 | H>R | No |
ClinGen ExAC gnomAD |
|
|
rs780984691 CA3987516 |
175 | H>Y | No |
ClinGen ExAC TOPMed gnomAD |
|
| rs773941060 | 180 | L>T | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No | NCI-TCGA |
No associated diseases with Q9NQE9
3 regional properties for Q9NQE9
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| conserved_site | Clathrin adaptor, mu subunit, conserved site | 157 - 177 | IPR018240-1 |
| conserved_site | Clathrin adaptor, mu subunit, conserved site | 253 - 267 | IPR018240-2 |
| domain | Mu homology domain | 157 - 421 | IPR028565 |
2 GO annotations of cellular component
| Name | Definition |
|---|---|
| cytoplasm | The contents of a cell excluding the plasma membrane and nucleus, but including other subcellular structures. |
| nucleus | A membrane-bounded organelle of eukaryotic cells in which chromosomes are housed and replicated. In most cells, the nucleus contains all of the cell's chromosomes except the organellar chromosomes, and is the site of RNA synthesis and processing. In some species, or in specialized cell types, RNA metabolism or DNA replication may be absent. |
3 GO annotations of molecular function
| Name | Definition |
|---|---|
| adenosine 5'-monophosphoramidase activity | Catalysis of the reaction: adenosine 5'-monophosphoramidate + H2O = AMP + NH4+. Other substrates include AMP-morpholidate, AMP-N-alanine methyl ester and AMP-alpha-acetyl lysine methyl ester. |
| identical protein binding | Binding to an identical protein or proteins. |
| nucleotide binding | Binding to a nucleotide, any compound consisting of a nucleoside that is esterified with (ortho)phosphate or an oligophosphate at any hydroxyl group on the ribose or deoxyribose. |
No GO annotations of biological process
| Name | Definition |
|---|---|
| No GO annotations for biological process |
1 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| Q7Z2E3 | APTX | Aprataxin | Homo sapiens (Human) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MAEEQVNRSA | GLAPDCEASA | TAETTVSSVG | TCEAAGKSPE | PKDYDSTCVF | CRIAGRQDPG |
| 70 | 80 | 90 | 100 | 110 | 120 |
| TELLHCENED | LICFKDIKPA | ATHHYLVVPK | KHIGNCRTLR | KDQVELVENM | VTVGKTILER |
| 130 | 140 | 150 | 160 | 170 | 180 |
| NNFTDFTNVR | MGFHMPPFCS | ISHLHLHVLA | PVDQLGFLSK | LVYRVNSYWF | ITADHLIEKL |
| RT |