Q944K3
Gene name |
HDA2 (At5g26040, T1N24.9) |
Protein name |
Histone deacetylase 2 |
Names |
|
Species |
Arabidopsis thaliana (Mouse-ear cress) |
KEGG Pathway |
ath:AT5G26040 |
EC number |
3.5.1.98: In linear amides |
Protein Class |
|
Descriptions
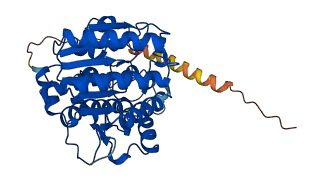
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for Q944K3
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-Q944K3-F1 | Predicted | AlphaFoldDB |
51 variants for Q944K3
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
| tmp_5_9101577_A_C | 8 | S>A | No | 1000Genomes | |
| tmp_5_9101567_G_A | 11 | T>I | No | 1000Genomes | |
| ENSVATH00649419 | 13 | L>F | No | 1000Genomes | |
| ENSVATH11070300 | 18 | A>S | No | 1000Genomes | |
| ENSVATH11070300 | 18 | A>T | No | 1000Genomes | |
| tmp_5_9101504_T_A | 32 | K>I | No | 1000Genomes | |
| ENSVATH03127842 | 32 | K>N | No | 1000Genomes | |
| ENSVATH03127841 | 33 | F>L | No | 1000Genomes | |
| ENSVATH11070299 | 35 | F>L | No | 1000Genomes | |
| ENSVATH00649418 | 36 | S>C | No | 1000Genomes | |
| tmp_5_9101480_G_A | 40 | T>I | No | 1000Genomes | |
| tmp_5_9101468_G_A | 44 | S>L | No | 1000Genomes | |
| ENSVATH03127835 | 69 | V>I | No | 1000Genomes | |
| ENSVATH00649416 | 81 | S>A | No | 1000Genomes | |
| tmp_5_9101213_A_T | 96 | D>E | No | 1000Genomes | |
| ENSVATH07048743 | 106 | F>L | No | 1000Genomes | |
| ENSVATH14205263 | 116 | K>N | No | 1000Genomes | |
| ENSVATH03127823 | 126 | K>N | No | 1000Genomes | |
| ENSVATH03127824 | 126 | K>T | No | 1000Genomes | |
| ENSVATH07048742 | 130 | L>F | No | 1000Genomes | |
| ENSVATH07048736 | 157 | A>G | No | 1000Genomes | |
| tmp_5_9100604_C_G | 206 | R>T | No | 1000Genomes | |
| tmp_5_9100601_C_T | 207 | G>E | No | 1000Genomes | |
| tmp_5_9100536_T_A | 229 | I>F | No | 1000Genomes | |
| ENSVATH11070259 | 258 | L>* | No | 1000Genomes | |
| ENSVATH11070258 | 258 | L>F | No | 1000Genomes | |
| tmp_5_9100265_C_G | 264 | E>Q | No | 1000Genomes | |
| ENSVATH07048719 | 271 | R>K | No | 1000Genomes | |
| ENSVATH03127777 | 279 | K>N | No | 1000Genomes | |
| ENSVATH03127778 | 279 | K>R | No | 1000Genomes | |
| tmp_5_9100112_C_T | 280 | V>I | No | 1000Genomes | |
| tmp_5_9100103_T_C | 283 | M>V | No | 1000Genomes | |
| ENSVATH00649398 | 301 | V>G | No | 1000Genomes | |
| tmp_5_9099787_G_A | 303 | S>L | No | 1000Genomes | |
| ENSVATH03127761 | 304 | R>P | No | 1000Genomes | |
| ENSVATH03127761 | 304 | R>Q | No | 1000Genomes | |
| tmp_5_9099774_T_A | 307 | Q>H | No | 1000Genomes | |
| tmp_5_9099708_C_A | 329 | K>N | No | 1000Genomes | |
| tmp_5_9099598_T_A | 331 | S>C | No | 1000Genomes | |
| ENSVATH14205258 | 332 | P>H | No | 1000Genomes | |
| tmp_5_9099592_C_T | 333 | D>N | No | 1000Genomes | |
| tmp_5_9099552_G_A | 346 | A>V | No | 1000Genomes | |
| tmp_5_9099517_A_C | 358 | S>A | No | 1000Genomes | |
| ENSVATH00649387 | 369 | I>T | No | 1000Genomes | |
| tmp_5_9099380_T_C | 369 | I>V | No | 1000Genomes | |
| tmp_5_9099376_G_A | 370 | A>V | No | 1000Genomes | |
| tmp_5_9099368_T_C | 373 | I>V | No | 1000Genomes | |
| tmp_5_9099364_T_C | 374 | E>G | No | 1000Genomes | |
| tmp_5_9099365_C_T | 374 | E>K | No | 1000Genomes | |
| tmp_5_9099359_G_T | 376 | L>I | No | 1000Genomes | |
| tmp_5_9099331_C_T | 385 | R>Q | No | 1000Genomes |
1 associated diseases with Q944K3
Without disease ID
1 regional properties for Q944K3
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| domain | Histone deacetylase domain | 25 - 321 | IPR023801 |
Functions
| Description | ||
|---|---|---|
| EC Number | 3.5.1.98 | In linear amides |
| Subcellular Localization |
|
|
| PANTHER Family | ||
| PANTHER Subfamily | ||
| PANTHER Protein Class | ||
| PANTHER Pathway Category | No pathway information available | |
1 GO annotations of cellular component
| Name | Definition |
|---|---|
| histone deacetylase complex | A protein complex that possesses histone deacetylase activity. |
2 GO annotations of molecular function
| Name | Definition |
|---|---|
| histone deacetylase activity | Catalysis of the reaction: histone N6-acetyl-L-lysine + H2O = histone L-lysine + acetate. This reaction represents the removal of an acetyl group from a histone, a class of proteins complexed to DNA in chromatin and chromosomes. |
| zinc ion binding | Binding to a zinc ion (Zn). |
2 GO annotations of biological process
| Name | Definition |
|---|---|
| chromatin organization | The assembly or remodeling of chromatin composed of DNA complexed with histones, other associated proteins, and sometimes RNA. |
| histone deacetylation | The modification of histones by removal of acetyl groups. |
1 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| Q8LRK8 | HDA18 | Histone deacetylase 18 | Arabidopsis thaliana (Mouse-ear cress) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MTHTRVISTW | TELTRDLAIY | LLFTFFAIKV | FKFLFSCNRT | SEISSFSMAT | HPEALRRERI |
| 70 | 80 | 90 | 100 | 110 | 120 |
| LNSKLYFDVP | LSKVSIIYSS | SYDISFMGIE | KLHPFDSSKW | GRVCKFLVSD | GFLEEKAIVE |
| 130 | 140 | 150 | 160 | 170 | 180 |
| PLEASKIDLL | VVHSENYLNS | LKSSATVARI | TEVAPVAFFP | NFLVQQKVLY | PFRKQVGGTI |
| 190 | 200 | 210 | 220 | 230 | 240 |
| LAAKLATERG | WAINIGGGFH | HCTAERGGGF | CAFADISLCI | HFAFLRLRIS | RVMIIDLDAH |
| 250 | 260 | 270 | 280 | 290 | 300 |
| QGNGHETDLG | DDNRVYILDM | YNPEIYPFDY | RARRFIDQKV | EVMSGTTTDE | YLRKLDEALE |
| 310 | 320 | 330 | 340 | 350 | 360 |
| VASRNFQPEL | VIYNAGTDIL | DGDPLGLLKI | SPDGITSRDE | KVFRFAREKN | IPLVMLTSGG |
| 370 | 380 | ||||
| YMKSSARVIA | DSIENLSRQG | LIQTRPE |