Q6ZRY4
Gene name |
RBPMS2 |
Protein name |
RNA-binding protein with multiple splicing 2 |
Names |
RNA binding protein, mRNA processing factor 2 |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:348093 |
EC number |
|
Protein Class |
|
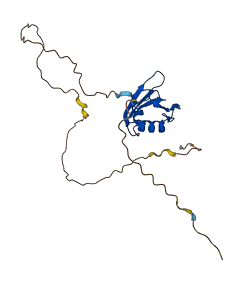
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
2 structures for Q6ZRY4
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| 2M9K | NMR | - | A/B | 27-117 | PDB |
| AF-Q6ZRY4-F1 | Predicted | AlphaFoldDB |
184 variants for Q6ZRY4
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
CA7611113 rs758862192 |
2 | S>N | No |
ClinGen ExAC gnomAD |
|
|
CA392835829 rs1165959512 |
3 | N>S | No |
ClinGen gnomAD |
|
|
CA392835808 rs1476165438 |
5 | K>E | No |
ClinGen TOPMed gnomAD |
|
|
CA392835796 rs1445004109 |
5 | K>N | No |
ClinGen TOPMed |
|
|
CA271454161 rs950662583 |
6 | P>S | No |
ClinGen TOPMed |
|
|
rs1242303758 CA392835776 |
7 | D>G | No |
ClinGen gnomAD |
|
|
rs1182648897 CA392835763 |
8 | G>C | No |
ClinGen gnomAD |
|
|
rs1595798841 CA392835759 |
8 | G>D | No |
ClinGen Ensembl |
|
|
rs1372735944 CA392835747 |
9 | E>G | No |
ClinGen TOPMed |
|
| TCGA novel | 9 | E>K | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1317489661 CA392835727 |
10 | H>Q | No |
ClinGen TOPMed |
|
|
rs1444614895 CA392835734 |
10 | H>Y | No |
ClinGen TOPMed |
|
|
rs1459582251 CA392835718 |
11 | G>D | No |
ClinGen TOPMed gnomAD |
|
|
rs1360434914 CA392835722 |
11 | G>R | No |
ClinGen TOPMed |
|
|
CA7611112 rs753419459 |
12 | G>C | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA gnomAD |
|
rs1206049711 CA392835696 |
13 | S>G | No |
ClinGen gnomAD |
|
|
CA392835677 rs1308987488 |
14 | T>S | No |
ClinGen TOPMed |
|
|
rs777493863 CA392835675 |
15 | G>C | No |
ClinGen ExAC gnomAD |
|
|
rs777493863 CA7611111 |
15 | G>R | No |
ClinGen ExAC gnomAD |
|
|
rs1341971766 CA392835663 |
17 | G>S | No |
ClinGen gnomAD |
|
|
CA392835655 rs1298595322 |
18 | S>Y | No |
ClinGen gnomAD |
|
|
rs1184893347 CA392835642 |
20 | A>G | No |
ClinGen TOPMed |
|
|
CA392835644 rs1380593560 |
20 | A>T | No |
ClinGen gnomAD |
|
|
rs1184893347 CA392835641 |
20 | A>V | No |
ClinGen TOPMed |
|
|
CA392835635 rs1453221789 |
21 | G>D | No |
ClinGen gnomAD |
|
|
rs1161033072 CA392835625 |
23 | G>D | No |
ClinGen TOPMed |
|
|
rs1326815098 CA392835613 |
25 | A>D | No |
ClinGen gnomAD |
|
|
CA7611030 rs763267659 |
31 | R>W | No |
ClinGen ExAC gnomAD |
|
|
rs372396252 CA271432144 |
36 | S>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1247676986 CA392832680 |
40 | V>G | No |
ClinGen TOPMed |
|
|
CA392832690 rs1414052266 |
40 | V>M | No |
ClinGen gnomAD |
|
|
rs1200481396 CA392832589 |
47 | L>I | No |
ClinGen TOPMed gnomAD |
|
|
CA392832569 rs1472951785 |
48 | Y>C | No |
ClinGen TOPMed |
|
|
rs867078048 CA271432112 |
51 | F>C | No |
ClinGen gnomAD |
|
|
rs575548719 CA7611016 |
52 | R>P | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs575548719 CA7611017 |
52 | R>Q | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA7611018 rs150042844 |
52 | R>W | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA392832511 rs1434111677 |
53 | P>S | No |
ClinGen TOPMed |
|
|
rs1317952764 CA392832482 |
55 | K>E | No |
ClinGen gnomAD |
|
|
CA392832322 rs1285883341 |
58 | E>G | No |
ClinGen gnomAD |
|
|
rs773219707 CA7610984 |
63 | K>T | No |
ClinGen ExAC gnomAD |
|
|
CA7610983 rs769653515 |
64 | L>F | No |
ClinGen ExAC gnomAD |
|
|
CA7610981 rs768536420 |
66 | A>E | No |
ClinGen ExAC gnomAD |
|
|
rs768136796 CA7610982 |
66 | A>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7610980 rs768536420 |
66 | A>V | No |
ClinGen ExAC gnomAD |
|
|
CA392832217 rs1163168657 |
67 | R>K | No |
ClinGen TOPMed |
|
|
CA392831601 rs1222355232 |
70 | V>F | No |
ClinGen TOPMed gnomAD |
|
|
CA392831605 rs1222355232 |
70 | V>I | No |
ClinGen TOPMed gnomAD |
|
|
rs373158060 CA271429818 |
76 | D>E | No |
ClinGen ESP TOPMed gnomAD |
|
|
rs749741830 CA7610951 |
78 | R>H | No |
ClinGen ExAC gnomAD |
|
|
rs1400806459 CA392831480 |
79 | A>G | No |
ClinGen TOPMed gnomAD |
|
|
CA7610950 rs778355375 |
79 | A>S | No |
ClinGen ExAC gnomAD |
|
|
CA7610949 rs756365664 |
80 | G>R | No |
ClinGen ExAC gnomAD |
|
|
rs201860883 CA271429801 |
81 | A>V | No |
ClinGen 1000Genomes |
|
|
COSM3386978 rs371776849 CA7610948 |
83 | A>V | pancreas [Cosmic] | No |
ClinGen cosmic curated 1000Genomes ESP ExAC TOPMed gnomAD |
|
rs1369249003 CA392831414 |
85 | K>R | No |
ClinGen TOPMed gnomAD |
|
|
CA392831415 rs1369249003 |
85 | K>T | No |
ClinGen TOPMed gnomAD |
|
|
CA392831399 rs1293805585 |
86 | N>S | No |
ClinGen gnomAD |
|
|
CA392831385 rs1429400493 |
87 | A>E | No |
ClinGen TOPMed gnomAD |
|
|
rs1429400493 CA392831381 |
87 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
rs1198077756 CA392831376 |
88 | L>V | No |
ClinGen TOPMed |
|
| rs750140091 | 89 | N>= | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1283931795 CA392831294 |
90 | G>D | No |
ClinGen gnomAD |
|
|
rs1285588603 CA392831286 |
91 | I>V | No |
ClinGen TOPMed |
|
|
CA7610920 COSM963970 rs752694645 |
92 | R>H | Variant assessed as Somatic; 0.0 impact. large_intestine endometrium [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ExAC NCI-TCGA TOPMed gnomAD |
|
rs1567064390 CA392831238 |
94 | D>V | No |
ClinGen Ensembl |
|
|
rs748590604 CA271429370 |
95 | P>S | No |
ClinGen Ensembl |
|
|
rs748590604 CA271429377 |
95 | P>T | No |
ClinGen Ensembl |
|
|
COSM193774 rs774369247 CA7610917 |
96 | E>K | large_intestine Variant assessed as Somatic; 4.619e-05 impact. [Cosmic, NCI-TCGA] | No |
ClinGen cosmic curated ExAC NCI-TCGA gnomAD |
|
CA392831186 rs1484071523 |
98 | P>S | No |
ClinGen gnomAD |
|
|
CA7610916 rs766653294 |
99 | Q>E | No |
ClinGen ExAC gnomAD |
|
|
rs762894837 CA7610915 |
100 | T>A | No |
ClinGen ExAC gnomAD |
|
|
CA392831093 rs1228470227 |
105 | F>L | No |
ClinGen gnomAD |
|
|
CA7610912 rs748660268 |
109 | N>S | No |
ClinGen ExAC |
|
| TCGA novel | 111 | K>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1025942217 CA271429297 |
111 | K>R | No |
ClinGen TOPMed gnomAD |
|
|
rs367588995 CA271429262 |
113 | A>S | No |
ClinGen Ensembl |
|
|
rs367588995 CA271429269 |
113 | A>T | No |
ClinGen Ensembl |
|
|
CA7610911 rs777339070 |
115 | S>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA392830942 rs1394807407 |
116 | K>N | No |
ClinGen TOPMed gnomAD |
|
|
CA7610910 rs769087353 |
117 | L>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1368921895 CA392830919 |
118 | M>R | No |
ClinGen gnomAD |
|
|
CA7610908 rs564171937 |
118 | M>V | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA271429199 rs139844024 |
120 | T>A | No |
ClinGen ESP |
|
|
rs1430480401 CA392830889 |
120 | T>I | No |
ClinGen TOPMed gnomAD |
|
|
CA7610906 rs375114329 |
122 | N>D | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA392830875 rs375114329 |
122 | N>H | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA392830852 rs1425505458 |
123 | P>R | No |
ClinGen gnomAD |
|
|
CA7610905 rs777329163 |
123 | P>T | No |
ClinGen ExAC gnomAD |
|
|
CA392830846 rs1256552996 |
124 | S>N | No |
ClinGen gnomAD |
|
|
CA7610904 rs755679041 |
124 | S>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA271429172 rs147479047 |
125 | N>K | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA392830812 rs767445444 |
126 | V>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7610902 rs767445444 |
126 | V>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1253511028 CA392830819 |
126 | V>M | No |
ClinGen gnomAD |
|
|
COSM963969 rs145944256 CA7610901 |
129 | A>T | endometrium [Cosmic] | No |
ClinGen cosmic curated 1000Genomes ESP ExAC TOPMed gnomAD |
|
rs377133037 CA7610899 |
130 | L>Q | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
| TCGA novel | 131 | G>* | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
| TCGA novel | 133 | H>Y | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs373694645 CA392830704 |
134 | F>L | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA7610894 rs777214314 |
135 | I>T | No |
ClinGen ExAC gnomAD |
|
|
rs762001990 CA7610895 |
135 | I>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA271429110 rs188576967 |
136 | A>S | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA7610892 rs188576967 |
136 | A>T | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen 1000Genomes ExAC NCI-TCGA TOPMed gnomAD |
|
CA7610889 rs748952790 |
137 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
COSM1223432 CA7610890 rs142321272 |
137 | R>W | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ESP ExAC NCI-TCGA TOPMed gnomAD |
|
rs777416076 CA7610888 |
138 | D>V | No |
ClinGen ExAC gnomAD |
|
|
rs1267277214 CA392830586 |
140 | Y>C | No |
ClinGen TOPMed |
|
|
rs1450172948 CA392830574 |
141 | D>Y | No |
ClinGen TOPMed |
|
|
rs1200635116 CA392830556 |
142 | L>R | No |
ClinGen gnomAD |
|
|
CA392830538 rs1246893308 |
143 | M>I | No |
ClinGen gnomAD |
|
|
rs772419094 CA7610873 |
143 | M>V | No |
ClinGen ExAC gnomAD |
|
|
rs148067403 CA7610872 |
144 | G>E | No |
ClinGen ESP ExAC gnomAD |
|
|
CA7610871 rs772809560 |
145 | A>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA392830525 rs772809560 |
145 | A>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA392830513 rs1421357944 |
146 | A>S | No |
ClinGen gnomAD |
|
|
rs1270615571 CA392830505 |
146 | A>V | No |
ClinGen gnomAD |
|
|
rs769457497 CA7610870 |
147 | L>V | No |
ClinGen ExAC gnomAD |
|
|
CA392830478 rs1567064124 |
149 | P>S | No |
ClinGen Ensembl |
|
|
CA392830468 rs1344826357 |
150 | A>S | No |
ClinGen TOPMed gnomAD |
|
|
CA392830471 rs1344826357 |
150 | A>T | No |
ClinGen TOPMed gnomAD |
|
|
CA392830462 rs1273297613 |
150 | A>V | No |
ClinGen gnomAD |
|
|
rs967227188 CA271428759 |
151 | S>P | No |
ClinGen TOPMed |
|
|
CA7610869 rs747849034 |
153 | E>D | No |
ClinGen ExAC gnomAD |
|
|
CA392830404 rs1162525637 |
155 | W>C | No |
ClinGen TOPMed |
|
|
CA7610867 rs111422187 |
155 | W>G | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA271428749 rs111422187 |
155 | W>R | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs78395952 CA7610866 |
156 | A>T | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA7610864 rs200454835 |
157 | P>S | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA392830373 rs1595786139 |
158 | Y>S | No |
ClinGen Ensembl |
|
|
CA392830364 rs1399801386 |
159 | P>A | No |
ClinGen gnomAD |
|
|
rs779230678 CA7610862 |
162 | T>A | No |
ClinGen ExAC gnomAD |
|
|
rs779230678 CA392830329 |
162 | T>P | No |
ClinGen ExAC gnomAD |
|
|
rs1595786127 CA392830316 |
163 | T>A | No |
ClinGen Ensembl |
|
|
rs757519713 CA7610861 |
164 | E>G | No |
ClinGen ExAC gnomAD |
|
|
CA392830283 rs1595786123 |
166 | T>P | No |
ClinGen Ensembl |
|
|
CA392830260 rs1331748424 |
168 | A>T | No |
ClinGen TOPMed |
|
|
rs867271733 CA271428670 |
170 | S>F | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
ClinGen Ensembl NCI-TCGA |
|
CA392830223 rs1442139936 |
171 | H>Y | No |
ClinGen gnomAD |
|
|
rs753180915 CA7610858 |
173 | A>E | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7610857 rs753180915 |
173 | A>V | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
CA392830201 rs1348909035 |
174 | F>L | No |
ClinGen gnomAD |
|
|
rs1243447249 CA392830183 |
175 | T>A | No |
ClinGen TOPMed |
|
|
rs1243447249 CA392830185 |
175 | T>P | No |
ClinGen TOPMed |
|
|
CA392830166 rs1595786094 |
176 | Y>S | No |
ClinGen Ensembl |
|
|
CA7610854 rs774674156 |
178 | T>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA392830119 rs771326456 |
180 | T>A | No |
ClinGen ExAC gnomAD |
|
|
CA271428633 rs149307777 |
180 | T>I | No |
ClinGen ESP TOPMed |
|
|
CA7610853 rs771326456 |
180 | T>P | No |
ClinGen ExAC gnomAD |
|
|
rs761452416 CA7610852 |
181 | A>T | No |
ClinGen ExAC gnomAD |
|
|
CA7610850 rs539053246 |
182 | A>T | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs150604668 CA392830069 |
184 | A>S | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs150604668 COSM1223431 CA7610847 |
184 | A>T | large_intestine [Cosmic] | No |
ClinGen cosmic curated 1000Genomes ESP ExAC TOPMed gnomAD |
|
rs778844103 CA7610845 |
185 | A>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA392830055 rs1186967789 |
185 | A>V | No |
ClinGen TOPMed |
|
|
COSM1708292 rs1208614343 CA392830045 |
186 | L>F | skin [Cosmic] | No |
ClinGen cosmic curated gnomAD |
|
rs1208614343 CA392830046 |
186 | L>V | No |
ClinGen gnomAD |
|
|
rs993604154 CA271428565 |
187 | H>D | No |
ClinGen TOPMed |
|
|
rs1595786048 CA392830032 |
187 | H>P | No |
ClinGen Ensembl |
|
|
rs141658779 CA7610842 |
188 | A>T | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs771676896 CA7610829 |
191 | R>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs948760638 CA271421236 |
191 | R>H | No |
ClinGen gnomAD |
|
|
rs1322622890 CA392829614 |
192 | W>C | No |
ClinGen TOPMed |
|
|
rs1180225015 CA392829602 |
193 | Y>F | No |
ClinGen TOPMed gnomAD |
|
|
CA392829606 rs1180225015 |
193 | Y>S | No |
ClinGen TOPMed gnomAD |
|
|
rs375982494 CA271421228 |
194 | P>A | No |
ClinGen ESP TOPMed |
|
|
rs1484175613 CA392829577 |
195 | S>F | No |
ClinGen TOPMed gnomAD |
|
|
rs894572812 CA271421222 |
196 | S>C | No |
ClinGen Ensembl |
|
|
rs1449995646 CA392829543 |
198 | T>N | No |
ClinGen gnomAD |
|
|
rs1291935581 CA392829535 |
199 | T>A | No |
ClinGen gnomAD |
|
|
rs774440320 CA7610827 |
199 | T>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs868644441 CA271421203 |
200 | Q>K | No |
ClinGen Ensembl |
|
|
rs748379722 CA271421194 |
201 | Q>* | No |
ClinGen Ensembl |
|
|
rs371422755 CA7610825 |
204 | K>* | No |
ClinGen ESP ExAC gnomAD |
|
| TCGA novel | 204 | K>M | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA392829466 rs1229809170 |
204 | K>T | No |
ClinGen gnomAD |
|
|
rs147894930 CA7610823 |
206 | R>C | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA7610822 rs374250029 |
206 | R>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7610824 rs147894930 |
206 | R>S | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1351120995 CA392829422 |
207 | Q>H | No |
ClinGen gnomAD |
|
|
rs1328444744 CA392829411 |
208 | F>S | No |
ClinGen gnomAD |
|
|
CA7610821 rs532717350 |
209 | C>S | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA392829382 rs985232954 |
210 | C>S | No |
ClinGen TOPMed gnomAD |
|
|
CA271421139 rs985232954 |
210 | C>W | No |
ClinGen TOPMed gnomAD |
No associated diseases with Q6ZRY4
1 GO annotations of cellular component
| Name | Definition |
|---|---|
| cytoplasm | The contents of a cell excluding the plasma membrane and nucleus, but including other subcellular structures. |
3 GO annotations of molecular function
| Name | Definition |
|---|---|
| identical protein binding | Binding to an identical protein or proteins. |
| mRNA binding | Binding to messenger RNA (mRNA), an intermediate molecule between DNA and protein. mRNA includes UTR and coding sequences, but does not contain introns. |
| protein homodimerization activity | Binding to an identical protein to form a homodimer. |
4 GO annotations of biological process
| Name | Definition |
|---|---|
| embryonic digestive tract morphogenesis | The process in which the anatomical structures of the digestive tract are generated and organized during embryonic development. The digestive tract is the anatomical structure through which food passes and is processed. |
| negative regulation of BMP signaling pathway | Any process that stops, prevents, or reduces the frequency, rate or extent of the BMP signaling pathway. |
| negative regulation of smooth muscle cell differentiation | Any process that stops, prevents, or reduces the frequency, rate or extent of smooth muscle cell differentiation. |
| positive regulation of smooth muscle cell proliferation | Any process that activates or increases the rate or extent of smooth muscle cell proliferation. |
3 homologous proteins in AiPD
| 10 | 20 | 30 | 40 | 50 | 60 |
| MSNLKPDGEH | GGSTGTGSGA | GSGGALEEEV | RTLFVSGLPV | DIKPRELYLL | FRPFKGYEGS |
| 70 | 80 | 90 | 100 | 110 | 120 |
| LIKLTARQPV | GFVIFDSRAG | AEAAKNALNG | IRFDPENPQT | LRLEFAKANT | KMAKSKLMAT |
| 130 | 140 | 150 | 160 | 170 | 180 |
| PNPSNVHPAL | GAHFIARDPY | DLMGAALIPA | SPEAWAPYPL | YTTELTPAIS | HAAFTYPTAT |
| 190 | 200 | ||||
| AAAAALHAQV | RWYPSSDTTQ | QGWKYRQFC |