E9PJI5
Gene name |
NPIPA7 |
Protein name |
Nuclear pore complex-interacting protein family member A7 |
Names |
|
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:101059953 |
EC number |
|
Protein Class |
|
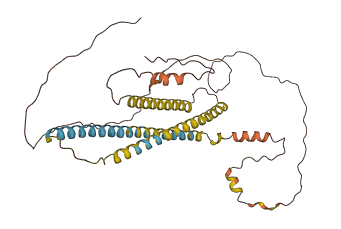
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for E9PJI5
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-E9PJI5-F1 | Predicted | AlphaFoldDB |
113 variants for E9PJI5
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
rs1291516097 CA395206327 |
65 | V>E | No |
ClinGen TOPMed gnomAD |
|
|
CA395206330 rs1291516097 |
65 | V>G | No |
ClinGen TOPMed gnomAD |
|
|
rs1231340525 CA395206319 |
65 | V>L | No |
ClinGen gnomAD |
|
|
CA395206388 rs1222387542 |
70 | T>A | No |
TOPMed gnomAD ClinGen |
|
|
CA395206392 rs1443664435 |
70 | T>N | No |
gnomAD ClinGen |
|
|
CA395206386 rs1222387542 |
70 | T>P | No |
TOPMed gnomAD ClinGen |
|
|
CA395206390 rs1222387542 |
70 | T>S | No |
TOPMed gnomAD ClinGen |
|
|
CA279018450 rs914936711 |
71 | I>T | No |
ClinGen TOPMed gnomAD |
|
|
rs1567585094 CA395206401 |
71 | I>V | No |
Ensembl ClinGen |
|
|
CA395206428 rs946363297 |
72 | F>L | No |
ClinGen TOPMed gnomAD |
|
|
rs760727162 CA395206435 |
73 | P>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs760727162 CA7927438 |
73 | P>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs775486134 CA7927437 |
73 | P>S | No |
ExAC gnomAD ClinGen |
|
|
rs1417754134 CA395206440 |
74 | S>P | No |
gnomAD ClinGen |
|
| TCGA novel | 75 | Q>* | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA279018453 rs1042362823 |
75 | Q>E | No |
TOPMed ClinGen |
|
|
rs750329494 CA7927440 |
75 | Q>R | No |
ClinGen ExAC gnomAD |
|
|
rs762783215 CA7927441 |
82 | T>M | No |
ExAC TOPMed gnomAD ClinGen |
|
|
CA395206596 rs1321307266 |
83 | D>V | No |
TOPMed ClinGen |
|
|
rs1388109168 CA395206580 |
83 | D>Y | No |
ClinGen TOPMed |
|
|
rs1308444067 CA395206606 |
84 | V>I | No |
gnomAD ClinGen |
|
|
CA395206639 rs1390806957 |
85 | Q>R | No |
TOPMed ClinGen |
|
|
CA395206664 rs1472382284 |
86 | Q>H | No |
ClinGen TOPMed |
|
|
CA279018455 rs944571256 |
86 | Q>K | No |
ClinGen TOPMed |
|
|
rs1040244767 CA395206698 |
88 | A>S | No |
ClinGen TOPMed gnomAD |
|
|
rs1040244767 CA279018456 |
88 | A>T | No |
ClinGen TOPMed gnomAD |
|
|
CA7927442 rs766147844 |
89 | R>W | No |
ExAC gnomAD ClinGen |
|
|
rs1379805237 CA395206744 |
91 | S>F | No |
ClinGen TOPMed gnomAD |
|
|
rs900309422 CA279018457 |
92 | N>H | No |
TOPMed ClinGen |
|
|
CA395206764 rs1314916153 |
92 | N>K | No |
gnomAD ClinGen |
|
|
rs1229007602 CA395206756 |
92 | N>T | No |
gnomAD ClinGen |
|
|
rs879335983 CA279018458 |
93 | R>C | No |
ClinGen TOPMed gnomAD |
|
|
CA395206776 rs1227860108 |
93 | R>H | No |
TOPMed gnomAD ClinGen |
|
|
rs751202960 CA395206797 |
94 | R>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA395206803 rs1484272157 |
94 | R>H | No |
ClinGen TOPMed gnomAD |
|
|
CA7927443 rs751202960 |
94 | R>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA7927444 rs754594654 |
97 | E>K | No |
ExAC gnomAD ClinGen |
|
|
CA395206874 rs1257478293 |
98 | G>* | No |
ClinGen TOPMed gnomAD |
|
|
CA395206870 CA395206872 rs1257478293 |
98 | G>R | No |
TOPMed gnomAD ClinGen |
|
|
CA395206928 rs1485293563 |
99 | I>N | No |
gnomAD ClinGen |
|
|
CA395206921 rs1482966264 |
99 | I>V | No |
ClinGen TOPMed |
|
|
rs1188636024 CA395206999 |
102 | V>A | No |
TOPMed gnomAD ClinGen |
|
|
rs1188636024 CA395207002 |
102 | V>G | No |
TOPMed gnomAD ClinGen |
|
|
CA395207015 rs1180124842 |
103 | L>R | No |
gnomAD ClinGen |
|
|
CA395207025 rs1249553966 |
104 | E>K | No |
ClinGen gnomAD |
|
|
rs1278118792 CA395207057 |
105 | D>E | No |
ClinGen TOPMed |
|
|
rs990614378 CA279018468 |
109 | L>S | No |
ClinGen TOPMed gnomAD |
|
|
CA395207159 rs1172810449 |
110 | W>* | No |
TOPMed gnomAD ClinGen |
|
|
CA395207223 rs1425563642 |
112 | Q>H | No |
ClinGen TOPMed gnomAD |
|
|
CA395207299 rs1226488483 |
115 | T>N | No |
TOPMed ClinGen |
|
|
CA395207351 rs1156902585 |
118 | R>* | No |
TOPMed gnomAD ClinGen |
|
|
CA279018469 rs914967567 |
118 | R>Q | No |
ClinGen TOPMed gnomAD |
|
|
rs755684730 CA7927448 |
122 | R>C | No |
ClinGen ExAC gnomAD |
|
|
rs1434511277 CA395207418 |
122 | R>H | No |
TOPMed gnomAD ClinGen |
|
|
CA395207446 rs1367648491 |
124 | M>R | No |
ClinGen gnomAD |
|
| TCGA novel | 126 | V>M | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA395207482 rs1274637315 |
127 | T>K | No |
TOPMed gnomAD ClinGen |
|
|
CA395207484 rs1274637315 |
127 | T>R | No |
ClinGen TOPMed gnomAD |
|
|
CA395207492 rs1368677173 |
128 | T>I | No |
ClinGen gnomAD |
|
|
CA395207507 rs1282852334 |
130 | V>I | No |
ClinGen gnomAD |
|
|
CA395207535 rs1208865217 |
132 | R>C | No |
ClinGen TOPMed gnomAD |
|
|
CA395207536 rs1269431194 |
132 | R>H | No |
ClinGen TOPMed gnomAD |
|
|
rs1197646025 CA395207546 |
133 | H>P | No |
ClinGen TOPMed gnomAD |
|
|
CA395207541 rs1466886059 |
133 | H>Y | No |
ClinGen gnomAD |
|
|
CA395207571 rs1246910126 |
135 | K>E | No |
gnomAD ClinGen |
|
|
CA395207583 rs1478924149 |
136 | I>V | No |
gnomAD ClinGen |
|
|
CA395207605 rs1175230910 |
137 | N>K | No |
ClinGen TOPMed gnomAD |
|
|
CA395207616 rs1237157075 |
138 | G>V | No |
TOPMed ClinGen |
|
|
CA395207627 rs1211085429 |
139 | K>N | No |
TOPMed ClinGen |
|
|
CA395207639 rs1555530905 |
140 | R>K | No |
ClinGen Ensembl |
|
|
CA395207640 rs1407228033 |
140 | R>S | No |
TOPMed gnomAD ClinGen |
|
|
CA279018470 rs541173073 |
142 | T>S | No |
1000Genomes ClinGen |
|
|
CA279018472 rs527482398 |
143 | A>D | No |
1000Genomes ClinGen |
|
|
CA395207665 rs1457656420 |
143 | A>T | No |
ClinGen TOPMed gnomAD |
|
|
rs1160040227 CA395207679 |
144 | K>R | No |
gnomAD ClinGen |
|
|
CA395207687 rs1390840548 |
145 | E>K | No |
gnomAD ClinGen |
|
|
CA395207768 rs1470543063 |
148 | R>K | No |
TOPMed ClinGen |
|
|
rs771224856 CA7927451 |
150 | L>P | No |
ExAC TOPMed gnomAD ClinGen |
|
|
CA279018514 rs1021760374 |
151 | S>R | No |
TOPMed gnomAD ClinGen |
|
|
CA395207791 rs1596865731 |
151 | S>R | No |
Ensembl ClinGen |
|
|
CA279018516 rs977813004 |
152 | M>V | No |
TOPMed gnomAD ClinGen |
|
|
CA395207824 rs1472879777 |
155 | R>C | No |
ClinGen TOPMed gnomAD |
|
|
CA395207823 rs1472879777 |
155 | R>G | No |
ClinGen TOPMed gnomAD |
|
|
CA395207825 rs1184182862 |
155 | R>H | No |
TOPMed gnomAD ClinGen |
|
|
rs1184182862 CA395207827 |
155 | R>L | No |
ClinGen TOPMed gnomAD |
|
|
rs1193713551 CA395207845 |
158 | R>* | No |
TOPMed gnomAD ClinGen |
|
|
rs1193713551 CA395207844 |
158 | R>G | No |
ClinGen TOPMed gnomAD |
|
|
CA395207846 rs1596865840 |
158 | R>I | No |
Ensembl ClinGen |
|
|
rs923625109 CA279018517 |
158 | R>S | No |
ClinGen TOPMed gnomAD |
|
|
rs1480608619 CA395207858 |
160 | E>K | No |
TOPMed gnomAD ClinGen |
|
|
CA395207872 rs1596865890 |
161 | E>D | No |
ClinGen Ensembl |
|
|
rs1407247355 CA395207888 |
163 | Q>H | No |
gnomAD ClinGen |
|
|
rs1454010458 CA395207902 |
164 | V>A | No |
ClinGen TOPMed |
|
|
rs1327310557 CA395207893 |
164 | V>M | No |
ClinGen gnomAD |
|
|
CA279018519 rs976057069 |
165 | S>P | No |
ClinGen TOPMed gnomAD |
|
|
CA395207915 rs1400456650 |
166 | E>Q | No |
ClinGen TOPMed |
|
|
CA395207950 rs1427053158 |
168 | E>G | No |
gnomAD ClinGen |
|
| TCGA novel | 169 | E>* | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA395207955 rs1409070625 |
169 | E>K | No |
ClinGen TOPMed |
|
|
CA395208021 rs1310455655 |
174 | D>N | No |
ClinGen gnomAD |
|
| TCGA novel | 175 | M>I | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA395208049 rs1354076302 |
176 | K>E | No |
TOPMed gnomAD ClinGen |
|
|
rs1284224101 CA395208067 |
177 | E>V | No |
ClinGen gnomAD |
|
|
rs1358062788 CA395208085 |
179 | H>Y | No |
ClinGen TOPMed gnomAD |
|
|
rs1176803016 CA395208118 |
182 | M>L | No |
ClinGen Ensembl |
|
|
rs1367850338 CA395208210 |
189 | Q>R | No |
TOPMed gnomAD ClinGen |
|
|
CA395209127 rs1555531164 |
268 | E>K | No |
Ensembl ClinGen |
|
|
rs1555531167 CA395209157 |
270 | V>L | No |
ClinGen Ensembl |
|
|
CA395209447 rs1555531168 |
301 | A>V | No |
Ensembl ClinGen |
|
|
CA395210018 rs1596867008 |
340 | P>L | No |
Ensembl ClinGen |
|
|
CA395210050 rs1555531170 |
343 | A>V | No |
Ensembl ClinGen |
|
|
CA395210136 rs1596867023 |
351 | P>A | No |
ClinGen Ensembl |
|
|
rs1596867058 CA395210204 |
357 | L>I | No |
Ensembl ClinGen |
No associated diseases with E9PJI5
No regional properties for E9PJI5
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| No domain, repeats, and functional sites for E9PJI5 | |||
1 GO annotations of cellular component
| Name | Definition |
|---|---|
| nucleoplasm | That part of the nuclear content other than the chromosomes or the nucleolus. |
No GO annotations of molecular function
| Name | Definition |
|---|---|
| No GO annotations for molecular function |
No GO annotations of biological process
| Name | Definition |
|---|---|
| No GO annotations for biological process |
6 homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| E9PKD4 | NPIPA5 | Nuclear pore complex-interacting protein family member A5 | Homo sapiens (Human) | PR |
| F8WFD2 | NPIPA3 | Nuclear pore complex-interacting protein family member A3 | Homo sapiens (Human) | PR |
| P0DM63 | NPIPA8 | Nuclear pore complex-interacting protein family member A8 | Homo sapiens (Human) | PR |
| Q9UND3 | NPIPA1 | Nuclear pore complex-interacting protein family member A1 | Homo sapiens (Human) | PR |
| E9PIF3 | NPIPA2 | Nuclear pore complex-interacting protein family member A2 | Homo sapiens (Human) | PR |
| A6NJ64 | NPIPB2 | Putative nuclear pore complex-interacting protein family member B2 | Homo sapiens (Human) | PR |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MFCCLGYEWL | SGGCTTWHSA | WVINTLADHR | HRGTDFGGSP | WLLIITVFLR | SYKFAISLCT |
| 70 | 80 | 90 | 100 | 110 | 120 |
| SYLCVSFLKT | IFPSQNGHDG | STDVQQRARR | SNRRRQEGIK | IVLEDIFTLW | RQVETKVRAK |
| 130 | 140 | 150 | 160 | 170 | 180 |
| IRKMKVTTKV | NRHDKINGKR | KTAKEHLRKL | SMKEREHREE | ERQVSEAEEN | GKLDMKEIHT |
| 190 | 200 | 210 | 220 | 230 | 240 |
| YMEMFQRAQA | LRRRAEDYYR | CKITPSARKP | LCNRVRMAAV | EHRHSSGLPY | WPYLTAETLK |
| 250 | 260 | 270 | 280 | 290 | 300 |
| NRMGHQPPPP | TQQHSIIDNS | LSLKTPSECV | LYPLPPSADD | NLKTPPECLL | TPLPPSALPS |
| 310 | 320 | 330 | 340 | 350 | 360 |
| ADDNLKTPAE | CLLYPLPPSA | DDNLKTPPEC | LLTPLPPSAP | PSADDNLKTP | PECVCSLPFH |
| PQRMIISRN |