Q9Y3D2
Gene name |
MSRB2 (CBS-1, MSRB, CGI-131) |
Protein name |
Methionine-R-sulfoxide reductase B2, mitochondrial |
Names |
MsrB2 |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:22921 |
EC number |
1.8.4.12: With a disulfide as acceptor |
Protein Class |
|
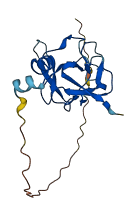
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for Q9Y3D2
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-Q9Y3D2-F1 | Predicted | AlphaFoldDB |
149 variants for Q9Y3D2
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
rs1452605254 CA376261754 |
2 | A>T | No |
ClinGen gnomAD |
|
|
CA376261782 rs1392670303 |
4 | L>P | No |
ClinGen TOPMed |
|
|
CA376261826 rs1372164028 |
8 | L>V | No |
ClinGen TOPMed |
|
|
rs1030350940 CA376261848 |
9 | R>P | No |
ClinGen TOPMed gnomAD |
|
|
CA204723105 rs1030350940 |
9 | R>Q | No |
ClinGen TOPMed gnomAD |
|
|
CA5438326 rs750343526 |
10 | G>D | No |
ClinGen ExAC gnomAD |
|
|
CA376261888 rs1258096267 |
13 | L>F | No |
ClinGen TOPMed |
|
|
rs755965887 CA5438327 |
15 | T>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs779826374 CA5438328 |
17 | P>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1484661078 CA376261925 |
17 | P>S | No |
ClinGen TOPMed |
|
|
CA204723106 rs1014037816 |
18 | R>Q | No |
ClinGen TOPMed |
|
|
rs1441889372 CA376261937 |
18 | R>W | No |
ClinGen TOPMed gnomAD |
|
|
rs986072137 CA204723107 |
19 | R>L | No |
ClinGen gnomAD |
|
|
CA376261949 rs986072137 |
19 | R>Q | No |
ClinGen gnomAD |
|
|
rs538025424 CA5438329 |
20 | A>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA204723109 rs986445754 |
21 | V>G | No |
ClinGen Ensembl |
|
|
CA204723108 rs1024209728 |
21 | V>M | No |
ClinGen TOPMed gnomAD |
|
|
rs1312679200 CA376261988 |
23 | G>D | No |
ClinGen TOPMed |
|
|
rs1312679200 CA376261990 |
23 | G>V | No |
ClinGen TOPMed |
|
|
rs1302272777 CA376262020 |
25 | A>E | No |
ClinGen TOPMed gnomAD |
|
| TCGA novel | 25 | A>T | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs548533289 CA5438331 |
26 | G>A | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
| TCGA novel | 27 | G>C | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA376262040 rs1158437022 |
27 | G>V | No |
ClinGen gnomAD |
|
|
rs941912699 CA204723111 |
29 | G>E | No |
ClinGen Ensembl |
|
|
rs1422139042 CA376262099 |
33 | G>R | No |
ClinGen TOPMed gnomAD |
|
|
rs1422139042 CA376262103 |
33 | G>W | No |
ClinGen TOPMed gnomAD |
|
|
rs747733953 CA5438332 |
34 | P>L | No |
ClinGen ExAC gnomAD |
|
|
rs1186990841 CA376262133 |
36 | L>M | No |
ClinGen TOPMed |
|
|
rs777336578 CA5438334 |
36 | L>Q | No |
ClinGen ExAC gnomAD |
|
|
CA204723117 rs907669280 |
37 | G>A | No |
ClinGen TOPMed gnomAD |
|
|
CA204723118 rs911851386 |
38 | E>G | No |
ClinGen Ensembl |
|
|
CA376262161 rs1393759626 |
38 | E>Q | No |
ClinGen gnomAD |
|
|
rs189447854 CA5438353 |
40 | G>E | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA204723119 rs961732000 |
40 | G>R | No |
ClinGen TOPMed gnomAD |
|
|
CA376263571 rs1237128471 |
41 | S>F | No |
ClinGen TOPMed |
|
|
rs770449041 CA5438354 |
42 | L>P | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs749705647 CA5438356 |
44 | T>A | No |
ClinGen ExAC gnomAD |
|
|
CA5438357 rs201559207 |
44 | T>M | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA5438359 rs761942342 |
45 | C>R | No |
ClinGen ExAC gnomAD |
|
|
CA5438360 VAR_050448 rs2296466 |
46 | E>G | No |
ClinGen UniProt 1000Genomes ESP ExAC TOPMed dbSNP gnomAD |
|
|
CA376263654 rs1406829788 |
48 | P>R | No |
ClinGen gnomAD |
|
| TCGA novel | 50 | A>P | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA5438362 rs760704622 |
51 | K>E | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA5438363 rs766343038 |
52 | S>C | No |
ClinGen ExAC gnomAD |
|
|
rs199630858 CA5438364 |
52 | S>N | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA204724065 rs1009222530 |
53 | E>G | No |
ClinGen TOPMed gnomAD |
|
|
CA376263712 rs1436360915 |
53 | E>K | No |
ClinGen TOPMed |
|
|
CA376263730 rs1383169718 |
54 | W>* | No |
ClinGen gnomAD |
|
|
COSM262074 rs759432644 CA5438365 |
56 | K>N | large_intestine endometrium [Cosmic] | No |
ClinGen cosmic curated ExAC TOPMed gnomAD |
| TCGA novel | 57 | K>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA204724067 rs201493683 |
59 | T>I | No |
ClinGen Ensembl |
|
|
CA5438368 rs758002036 |
60 | P>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs752471479 CA5438367 |
60 | P>S | No |
ClinGen ExAC gnomAD |
|
|
CA376263821 rs1261222481 |
61 | E>A | No |
ClinGen gnomAD |
|
|
CA5438370 rs753222533 |
61 | E>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs367638197 CA5438372 |
64 | Y>* | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA376263860 rs1213380301 |
64 | Y>C | No |
ClinGen TOPMed |
|
|
rs745379676 CA5438373 |
65 | V>I | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
rs745379676 CA5438374 |
65 | V>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA5438375 rs181802942 |
66 | T>A | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA5438376 rs375428530 |
71 | T>M | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs375428530 CA5438377 |
71 | T>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA5438379 rs368383198 |
72 | E>D | No |
ClinGen ESP ExAC TOPMed |
|
|
CA5438380 rs187064900 |
73 | P>L | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1300746366 CA376264034 |
74 | P>A | No |
ClinGen gnomAD |
|
|
rs769642851 CA5438400 |
79 | Y>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs191932981 CA5438402 |
81 | N>D | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA5438403 rs201313808 |
81 | N>K | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA5438405 rs759780347 |
84 | E>K | No |
ClinGen ExAC gnomAD |
|
|
CA376264114 rs1393133301 |
85 | A>V | No |
ClinGen TOPMed |
|
|
CA376264118 rs767861534 |
86 | G>A | No |
ClinGen ExAC gnomAD |
|
|
CA5438406 rs767861534 |
86 | G>E | No |
ClinGen ExAC gnomAD |
|
|
CA5438408 rs761111249 |
87 | M>I | No |
ClinGen ExAC gnomAD |
|
|
CA5438407 rs775926786 |
87 | M>T | No |
ClinGen ExAC gnomAD |
|
|
CA376264132 rs1176687507 |
88 | Y>C | No |
ClinGen gnomAD |
|
|
rs764571708 CA5438409 |
89 | H>R | No |
ClinGen ExAC gnomAD |
|
|
CA376264145 rs1164644706 |
90 | C>Y | No |
ClinGen gnomAD |
|
|
rs41277408 CA5438412 |
91 | V>M | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs918579486 CA204724761 |
94 | D>E | No |
ClinGen TOPMed gnomAD |
|
|
rs754558586 CA5438414 |
94 | D>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA204724760 rs754558586 |
94 | D>N | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
CA376264200 rs1454477252 |
98 | F>L | No |
ClinGen TOPMed gnomAD |
|
|
CA376264206 rs1267042770 |
98 | F>L | No |
ClinGen gnomAD |
|
|
CA376264210 rs1315480667 |
99 | S>N | No |
ClinGen TOPMed gnomAD |
|
|
CA5438458 rs199642000 |
103 | K>Q | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1302637480 CA376260636 |
106 | S>F | No |
ClinGen gnomAD |
|
|
CA5438459 rs758435342 |
106 | S>P | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs780227396 CA5438460 |
108 | T>I | No |
ClinGen ExAC gnomAD |
|
|
rs1033214738 CA204725747 |
110 | W>* | No |
ClinGen TOPMed gnomAD |
|
|
CA5438461 rs747117917 |
110 | W>R | No |
ClinGen ExAC gnomAD |
|
|
rs1259507732 CA376260672 |
112 | S>L | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA TOPMed |
|
rs141332961 CA5438463 |
113 | F>S | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
COSM1504834 rs373939180 CA376260687 |
115 | E>* | lung Variant assessed as Somatic; 0.0 impact. [Cosmic, NCI-TCGA] | No |
ClinGen cosmic curated ESP ExAC NCI-TCGA TOPMed gnomAD |
|
rs373939180 CA5438465 |
115 | E>K | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs375734008 CA204725748 |
117 | H>Y | No |
ClinGen ESP TOPMed |
|
| TCGA novel | 118 | G>D | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1368393520 CA376260713 |
119 | T>A | No |
ClinGen TOPMed |
|
|
CA5438466 rs773597613 |
119 | T>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs771438695 CA5438468 |
121 | G>R | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 122 | S>P | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA376260735 rs774911226 |
123 | D>H | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
CA5438469 rs774911226 |
123 | D>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1233433395 CA376260750 |
125 | S>G | No |
ClinGen TOPMed gnomAD |
|
|
CA5438470 rs760223127 |
125 | S>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs760719737 CA5438471 |
126 | H>L | No |
ClinGen ExAC gnomAD |
|
|
rs760719737 CA5438472 |
126 | H>R | No |
ClinGen ExAC gnomAD |
|
|
CA376260764 rs1359849079 |
127 | T>P | No |
ClinGen TOPMed gnomAD |
|
|
rs1163248567 CA376260770 |
128 | G>R | No |
ClinGen gnomAD |
|
|
rs183079090 CA5438475 |
132 | R>C | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1411767051 CA376260795 |
132 | R>H | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA gnomAD |
|
CA376260799 rs1329598503 |
133 | L>V | No |
ClinGen gnomAD |
|
| TCGA novel | 134 | D>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs750260291 CA5438476 |
136 | S>L | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
rs1317625485 CA376260829 |
138 | G>R | No |
ClinGen gnomAD |
|
|
rs766417540 CA5438478 |
139 | S>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA5438479 rs751511192 COSM135970 |
141 | R>C | large_intestine skin [Cosmic] | No |
ClinGen cosmic curated ExAC gnomAD |
|
CA5438480 rs368959044 |
141 | R>H | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ESP ExAC NCI-TCGA TOPMed gnomAD |
| TCGA novel | 142 | T>A | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA376260868 rs1260006890 |
144 | V>A | No |
ClinGen TOPMed |
|
|
CA376260867 rs1260006890 |
144 | V>D | No |
ClinGen TOPMed |
|
|
rs1273046710 CA376260866 |
144 | V>I | No |
ClinGen gnomAD |
|
|
CA376260882 rs1215428630 |
146 | C>* | No |
ClinGen TOPMed gnomAD |
|
|
CA376260888 rs1280216604 |
147 | K>R | No |
ClinGen TOPMed |
|
|
rs1437172626 CA376260895 |
148 | Q>R | No |
ClinGen gnomAD |
|
|
CA376260940 rs1469701868 |
152 | H>L | No |
ClinGen TOPMed gnomAD |
|
|
CA204725889 rs1036360483 |
153 | L>P | No |
ClinGen TOPMed gnomAD |
|
|
rs1462264206 CA376260947 |
154 | G>S | No |
ClinGen TOPMed |
|
|
rs765602616 CA5438499 |
155 | H>Y | No |
ClinGen ExAC gnomAD |
|
|
rs756258301 CA5438501 |
156 | V>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs887223244 CA376260974 |
158 | P>S | No |
ClinGen TOPMed gnomAD |
|
|
CA204725890 rs887223244 |
158 | P>T | No |
ClinGen TOPMed gnomAD |
|
|
CA5438502 rs777965156 |
159 | D>N | No |
ClinGen ExAC gnomAD |
|
|
rs754112541 CA5438503 |
160 | G>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA5438504 rs757592264 |
161 | P>L | No |
ClinGen ExAC gnomAD |
|
|
rs1254157451 CA376260995 |
162 | G>R | No |
ClinGen gnomAD |
|
|
CA376260998 rs1486761597 |
162 | G>V | No |
ClinGen TOPMed gnomAD |
|
|
rs1261358808 CA376261008 |
164 | N>D | No |
ClinGen gnomAD |
|
|
CA5438506 rs560833189 |
164 | N>S | No |
ClinGen ExAC gnomAD |
|
|
CA5438507 rs772472605 |
165 | G>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1215371885 CA376261021 |
166 | Q>* | No |
ClinGen TOPMed |
|
|
CA5438508 rs780689128 |
166 | Q>P | No |
ClinGen ExAC gnomAD |
|
|
CA5438510 rs769488096 |
172 | S>G | No |
ClinGen ExAC gnomAD |
|
|
rs1366056470 CA376261066 |
172 | S>N | No |
ClinGen gnomAD |
|
|
rs762733560 CA5438512 |
176 | K>E | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs11554774 CA204725891 |
177 | F>S | No |
ClinGen Ensembl |
|
|
rs1359527041 CA376261131 |
181 | K>N | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA gnomAD |
|
rs774035939 CA5438514 |
183 | H>C | No |
ClinGen ExAC gnomAD |
|
|
rs770808976 CA5438513 |
183 | H>L | No |
ClinGen ExAC TOPMed gnomAD |
No associated diseases with Q9Y3D2
4 regional properties for Q9Y3D2
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| domain | DNA mismatch repair protein MutS, C-terminal | 789 - 984 | IPR000432 |
| domain | DNA mismatch repair protein MutS-like, N-terminal | 142 - 265 | IPR007695 |
| domain | DNA mismatch repair protein MutS, core | 426 - 773 | IPR007696 |
| domain | DNA mismatch repair protein MutS, connector domain | 297 - 372 | IPR007860 |
Functions
| Description | ||
|---|---|---|
| EC Number | 1.8.4.12 | With a disulfide as acceptor |
| Subcellular Localization |
|
|
| PANTHER Family | ||
| PANTHER Subfamily | ||
| PANTHER Protein Class | ||
| PANTHER Pathway Category | No pathway information available | |
3 GO annotations of cellular component
| Name | Definition |
|---|---|
| cytoplasm | The contents of a cell excluding the plasma membrane and nucleus, but including other subcellular structures. |
| cytosol | The part of the cytoplasm that does not contain organelles but which does contain other particulate matter, such as protein complexes. |
| mitochondrion | A semiautonomous, self replicating organelle that occurs in varying numbers, shapes, and sizes in the cytoplasm of virtually all eukaryotic cells. It is notably the site of tissue respiration. |
4 GO annotations of molecular function
| Name | Definition |
|---|---|
| actin binding | Binding to monomeric or multimeric forms of actin, including actin filaments. |
| L-methionine-(R)-S-oxide reductase activity | Catalysis of the reaction: L-methionine + thioredoxin disulfide + H2O = L-methionine (R)-S-oxide + thioredoxin. |
| peptide-methionine (R)-S-oxide reductase activity | Catalysis of the reaction: peptide-L-methionine + H(2)O + thioredoxin disulfide = peptide-L-methionine (R)-S-oxide + thioredoxin. Can act on oxidized methionine in peptide linkage with specificity for the R enantiomer. Thioredoxin disulfide is the oxidized form of thioredoxin. |
| zinc ion binding | Binding to a zinc ion (Zn). |
3 GO annotations of biological process
| Name | Definition |
|---|---|
| actin filament polymerization | Assembly of actin filaments by the addition of actin monomers to a filament. |
| protein repair | The process of restoring a protein to its original state after damage by such things as oxidation or spontaneous decomposition of residues. |
| response to oxidative stress | Any process that results in a change in state or activity of a cell or an organism (in terms of movement, secretion, enzyme production, gene expression, etc.) as a result of oxidative stress, a state often resulting from exposure to high levels of reactive oxygen species, e.g. superoxide anions, hydrogen peroxide (H2O2), and hydroxyl radicals. |
No homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| No homologous proteins | ||||
| 10 | 20 | 30 | 40 | 50 | 60 |
| MARLLWLLRG | LTLGTAPRRA | VRGQAGGGGP | GTGPGLGEAG | SLATCELPLA | KSEWQKKLTP |
| 70 | 80 | 90 | 100 | 110 | 120 |
| EQFYVTREKG | TEPPFSGIYL | NNKEAGMYHC | VCCDSPLFSS | EKKYCSGTGW | PSFSEAHGTS |
| 130 | 140 | 150 | 160 | 170 | 180 |
| GSDESHTGIL | RRLDTSLGSA | RTEVVCKQCE | AHLGHVFPDG | PGPNGQRFCI | NSVALKFKPR |
| KH |