Q9H9H5
Gene name |
MAP6D1 |
Protein name |
MAP6 domain-containing protein 1 |
Names |
21 kDa STOP-like protein, SL21 |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:79929 |
EC number |
|
Protein Class |
|
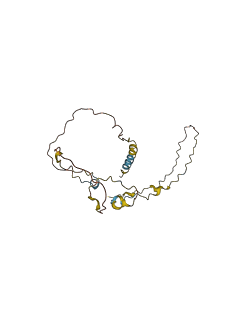
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for Q9H9H5
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-Q9H9H5-F1 | Predicted | AlphaFoldDB |
218 variants for Q9H9H5
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
rs1412451282 CA355357180 |
2 | A>P | No |
ClinGen TOPMed |
|
|
rs1363765614 CA355357176 |
2 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
CA2723304 rs771395990 |
3 | W>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1358048859 CA355357169 |
3 | W>* | No |
ClinGen TOPMed |
|
|
rs1448178502 CA355357162 |
4 | P>L | No |
ClinGen TOPMed |
|
|
rs1420868676 CA355357165 |
4 | P>S | No |
ClinGen gnomAD |
|
|
CA355357160 rs1157202636 |
5 | C>R | No |
ClinGen gnomAD |
|
|
CA355357152 rs1577254408 |
6 | I>V | No |
ClinGen Ensembl |
|
|
rs1408856588 CA355357144 |
7 | S>C | No |
ClinGen TOPMed |
|
|
rs1377908491 CA355357133 |
8 | R>L | No |
ClinGen gnomAD |
|
|
rs1197688594 CA355357132 |
9 | L>M | No |
ClinGen gnomAD |
|
|
CA355357121 rs1487925057 |
10 | C>* | No |
ClinGen gnomAD |
|
|
rs1216655892 CA355357124 |
10 | C>F | No |
ClinGen gnomAD |
|
|
rs1264735499 CA355357127 |
10 | C>R | No |
ClinGen gnomAD |
|
|
rs1216655892 CA355357122 |
10 | C>Y | No |
ClinGen gnomAD |
|
|
CA355357114 rs1220794872 |
11 | C>* | No |
ClinGen gnomAD |
|
|
rs749823342 CA355357115 |
11 | C>F | No |
ClinGen ExAC gnomAD |
|
|
rs749823342 CA2723303 |
11 | C>Y | No |
ClinGen ExAC gnomAD |
|
|
rs1345448060 CA355357112 |
12 | L>M | No |
ClinGen gnomAD |
|
|
rs1275715279 CA355357108 |
12 | L>Q | No |
ClinGen gnomAD |
|
|
CA355357104 rs1300119443 |
13 | A>E | No |
ClinGen gnomAD |
|
|
rs1343828370 CA355357106 |
13 | A>P | No |
ClinGen TOPMed gnomAD |
|
|
CA355357107 rs1343828370 |
13 | A>T | No |
ClinGen TOPMed gnomAD |
|
|
CA355357102 rs1300119443 |
13 | A>V | No |
ClinGen gnomAD |
|
|
rs1316834471 CA355357097 |
14 | R>L | No |
ClinGen gnomAD |
|
|
CA355357100 rs1360508811 |
14 | R>W | No |
ClinGen gnomAD |
|
|
rs1426291178 CA355357096 |
15 | R>C | No |
ClinGen gnomAD |
|
|
CA355357093 rs1172311031 |
15 | R>H | No |
ClinGen gnomAD |
|
|
rs1172311031 CA355357091 |
15 | R>L | No |
ClinGen gnomAD |
|
|
rs1426291178 CA355357094 |
15 | R>S | No |
ClinGen gnomAD |
|
|
rs1193772027 CA355357082 |
16 | W>C | No |
ClinGen gnomAD |
|
|
rs1425245420 CA355357085 |
16 | W>L | No |
ClinGen gnomAD |
|
|
rs1477202337 CA355357080 |
17 | N>D | No |
ClinGen gnomAD |
|
|
CA355357077 rs1240354202 |
17 | N>S | No |
ClinGen gnomAD |
|
|
CA355357071 rs1442885026 |
18 | Q>* | No |
ClinGen gnomAD |
|
|
rs867097085 CA88806391 |
18 | Q>H | No |
ClinGen gnomAD |
|
|
CA355357066 rs1201468733 |
19 | L>M | No |
ClinGen gnomAD |
|
|
rs1321683726 CA355357062 |
19 | L>P | No |
ClinGen gnomAD |
|
|
CA88806375 rs955076767 |
20 | D>G | No |
ClinGen TOPMed gnomAD |
|
|
rs985747743 CA88806389 |
20 | D>H | No |
ClinGen TOPMed gnomAD |
|
|
rs985747743 CA355357061 |
20 | D>Y | No |
ClinGen TOPMed gnomAD |
|
|
rs1029283585 CA88806368 |
21 | R>C | No |
ClinGen TOPMed gnomAD |
|
|
rs1360212745 CA355357053 |
21 | R>H | No |
ClinGen gnomAD |
|
|
CA355357051 rs1360212745 |
21 | R>L | No |
ClinGen gnomAD |
|
|
rs1402096381 CA355357045 |
22 | S>F | No |
ClinGen TOPMed gnomAD |
|
|
rs1468513695 CA355357050 |
22 | S>P | No |
ClinGen gnomAD |
|
|
CA355357047 rs1402096381 |
22 | S>Y | No |
ClinGen TOPMed gnomAD |
|
|
CA355357037 rs1416798490 |
23 | D>E | No |
ClinGen gnomAD |
|
|
rs1464686309 CA355357044 |
23 | D>N | No |
ClinGen gnomAD |
|
|
rs1464686309 CA355357042 |
23 | D>Y | No |
ClinGen gnomAD |
|
|
rs1183056543 CA355357034 |
24 | V>L | No |
ClinGen gnomAD |
|
|
CA355357036 rs1183056543 |
24 | V>M | No |
ClinGen gnomAD |
|
|
rs1473087047 CA355357025 |
25 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
CA355357024 rs1189367126 |
26 | V>M | No |
ClinGen TOPMed |
|
|
rs868388777 CA88806363 |
27 | P>S | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA gnomAD |
|
rs1414997547 CA355356993 |
31 | H>P | No |
ClinGen TOPMed |
|
|
rs1260277084 CA355356986 |
32 | G>C | No |
ClinGen gnomAD |
|
| TCGA novel | 34 | S>L | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1307092103 CA355356958 |
36 | L>F | No |
ClinGen gnomAD |
|
|
rs1230037795 CA355356937 |
39 | E>* | No |
ClinGen TOPMed gnomAD |
|
|
rs1230037795 CA355356938 |
39 | E>Q | No |
ClinGen TOPMed gnomAD |
|
|
rs868078982 CA88806357 |
41 | P>S | No |
ClinGen gnomAD |
|
|
CA355356914 rs1428696298 |
42 | G>D | No |
ClinGen TOPMed |
|
|
CA355356917 rs1314951002 |
42 | G>S | No |
ClinGen gnomAD |
|
|
rs769304543 CA2723301 |
43 | T>M | No |
ClinGen ExAC gnomAD |
|
|
CA88806354 rs961100991 |
44 | G>D | No |
ClinGen TOPMed gnomAD |
|
|
CA355356894 rs1017068925 |
46 | A>S | No |
ClinGen TOPMed gnomAD |
|
|
rs1017068925 CA88806347 |
46 | A>T | No |
ClinGen TOPMed gnomAD |
|
|
CA355356881 rs1166307553 |
48 | S>* | No |
ClinGen TOPMed gnomAD |
|
|
CA355356879 rs1166307553 |
48 | S>L | No |
ClinGen TOPMed gnomAD |
|
|
rs1405429727 CA355356878 |
49 | R>C | No |
ClinGen TOPMed gnomAD |
|
|
CA355356877 rs1405429727 |
49 | R>G | No |
ClinGen TOPMed gnomAD |
|
|
CA88806343 rs1005719253 |
49 | R>L | No |
ClinGen TOPMed gnomAD |
|
|
rs959769906 CA88806337 |
51 | G>R | No |
ClinGen TOPMed gnomAD |
|
|
rs551404235 CA2723300 |
51 | G>V | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs1033968335 CA88806336 |
53 | P>T | No |
ClinGen TOPMed gnomAD |
|
|
CA355356848 rs1238589623 |
54 | P>A | No |
ClinGen gnomAD |
|
|
rs1238589623 CA355356849 |
54 | P>S | No |
ClinGen gnomAD |
|
|
CA355356838 rs1177738658 |
55 | A>V | No |
ClinGen gnomAD |
|
|
CA355356824 rs1560357825 |
58 | R>Q | No |
ClinGen Ensembl |
|
|
rs780698630 CA2723299 |
58 | R>W | No |
ClinGen ExAC gnomAD |
|
|
rs1231340008 CA355356800 |
62 | R>W | No |
ClinGen TOPMed gnomAD |
|
|
rs1322403470 CA355356787 |
64 | V>L | No |
ClinGen gnomAD |
|
|
rs545671364 CA88806300 |
65 | P>Q | No |
ClinGen gnomAD |
|
| TCGA novel | 68 | Q>H | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1448397991 CA355356750 |
69 | Y>* | No |
ClinGen TOPMed |
|
|
CA355356753 rs1577254105 |
69 | Y>C | No |
ClinGen Ensembl |
|
|
CA355356748 rs1042397257 |
70 | Q>* | No |
ClinGen TOPMed gnomAD |
|
|
rs1042397257 CA88806285 |
70 | Q>E | No |
ClinGen TOPMed gnomAD |
|
|
rs1310455905 CA355356738 |
71 | R>L | No |
ClinGen gnomAD |
|
|
CA355356740 rs1310455905 |
71 | R>Q | No |
ClinGen gnomAD |
|
|
CA355356741 rs1356418752 |
71 | R>W | No |
ClinGen TOPMed gnomAD |
|
|
rs1391122161 CA355356737 |
72 | D>N | No |
ClinGen gnomAD |
|
|
rs1370799895 CA355356711 |
74 | G>D | No |
ClinGen gnomAD |
|
|
CA355356714 rs1403266506 |
74 | G>R | No |
ClinGen TOPMed |
|
|
rs1370799895 CA355356708 |
74 | G>V | No |
ClinGen gnomAD |
|
|
CA88806276 rs77515107 |
75 | L>W | No |
ClinGen Ensembl |
|
|
CA355356668 rs1350837763 |
78 | T>A | No |
ClinGen TOPMed |
|
|
rs1294916055 CA355356659 |
79 | P>T | No |
ClinGen gnomAD |
|
|
rs1054241938 CA88806254 |
83 | K>N | No |
ClinGen TOPMed gnomAD |
|
|
rs1364379567 CA355356614 |
83 | K>R | No |
ClinGen TOPMed gnomAD |
|
|
CA355356591 rs1577254041 |
85 | P>L | No |
ClinGen Ensembl |
|
|
CA2723296 rs568881694 |
86 | P>L | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA88806241 rs1049706088 |
86 | P>S | No |
ClinGen TOPMed gnomAD |
|
|
CA88806235 rs1049706088 |
86 | P>T | No |
ClinGen TOPMed gnomAD |
|
|
rs758363343 CA2723295 |
87 | P>S | No |
ClinGen ExAC gnomAD |
|
|
rs1246156706 CA355356568 |
88 | G>E | No |
ClinGen TOPMed |
|
|
rs750399591 CA2723294 |
89 | R>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA88806194 rs972388049 |
90 | G>* | No |
ClinGen TOPMed |
|
|
CA355356542 rs1162352794 |
91 | P>S | No |
ClinGen TOPMed |
|
|
rs1414951131 CA355356532 |
92 | G>E | No |
ClinGen TOPMed |
|
|
rs1319001250 CA355356514 |
94 | G>S | No |
ClinGen TOPMed |
|
|
rs1388487338 CA355356493 |
96 | R>C | No |
ClinGen TOPMed |
|
|
CA88806192 rs528962937 |
98 | G>D | No |
ClinGen 1000Genomes |
|
|
rs961007375 CA88806191 |
99 | K>N | No |
ClinGen TOPMed |
|
|
CA355356435 rs1406146908 |
101 | S>F | No |
ClinGen gnomAD |
|
|
CA355356429 rs760667646 |
102 | A>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA2723293 COSM3695937 rs370227160 |
102 | A>T | large_intestine [Cosmic] | No |
ClinGen cosmic curated 1000Genomes ExAC TOPMed gnomAD |
|
CA2723292 rs760667646 |
102 | A>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA355356410 rs1266032541 |
104 | S>P | No |
ClinGen TOPMed |
|
|
rs1287352837 CA355356382 |
106 | A>V | No |
ClinGen gnomAD |
|
|
rs752878396 CA2723291 |
107 | P>R | No |
ClinGen ExAC |
|
|
CA355356377 rs1315467539 |
107 | P>T | No |
ClinGen gnomAD |
|
| TCGA novel | 108 | P>S | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA355356342 rs1300755220 |
110 | P>L | No |
ClinGen TOPMed gnomAD |
|
|
rs1300755220 CA355356344 |
110 | P>R | No |
ClinGen TOPMed gnomAD |
|
|
rs1186361264 CA355356347 |
110 | P>S | No |
ClinGen TOPMed |
|
|
CA88806159 rs996799680 |
111 | G>D | No |
ClinGen Ensembl |
|
|
CA355356341 rs1361157524 |
111 | G>S | No |
ClinGen gnomAD |
|
|
CA88806152 rs970981446 |
112 | A>P | No |
ClinGen TOPMed gnomAD |
|
|
rs1360663642 CA355356320 |
113 | R>C | No |
ClinGen gnomAD |
|
|
CA355356323 rs1360663642 |
113 | R>S | No |
ClinGen gnomAD |
|
|
CA355356305 rs964325398 |
114 | G>A | No |
ClinGen TOPMed |
|
|
CA88806151 rs964325398 |
114 | G>E | No |
ClinGen TOPMed |
|
|
CA355356313 rs1176461144 |
114 | G>R | No |
ClinGen gnomAD |
|
|
rs1019462828 CA88806146 |
115 | V>I | No |
ClinGen TOPMed gnomAD |
|
|
rs1428784968 CA355356290 |
116 | Y>C | No |
ClinGen TOPMed gnomAD |
|
|
rs1478840611 CA355356280 |
117 | V>E | No |
ClinGen gnomAD |
|
|
rs1197432974 CA355356282 |
117 | V>L | No |
ClinGen gnomAD |
|
|
CA355356281 rs1197432974 |
117 | V>M | No |
ClinGen gnomAD |
|
|
CA355356277 rs1263090362 |
118 | L>M | No |
ClinGen gnomAD |
|
|
rs528408351 CA2723288 |
119 | P>R | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs771303753 CA355356264 |
120 | I>L | No |
ClinGen ExAC gnomAD |
|
|
CA2723287 rs771303753 |
120 | I>V | No |
ClinGen ExAC gnomAD |
|
|
CA2723285 rs545006671 |
121 | G>S | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA355356229 rs1334961531 |
123 | A>S | No |
ClinGen TOPMed |
|
|
rs1357553038 CA355356217 |
124 | D>A | No |
ClinGen TOPMed |
|
|
rs747592296 CA2723283 |
125 | A>T | No |
ClinGen ExAC gnomAD |
|
|
CA88806088 rs1008036778 |
127 | A>P | No |
ClinGen TOPMed |
|
|
CA88806081 rs556401220 |
130 | T>A | No |
ClinGen 1000Genomes |
|
|
CA355356141 rs1380481799 |
131 | T>K | No |
ClinGen TOPMed gnomAD |
|
|
rs1294833422 CA355356146 |
131 | T>S | No |
ClinGen gnomAD |
|
|
CA355356132 rs1303223379 |
132 | S>* | No |
ClinGen gnomAD |
|
|
CA2723268 rs375663308 |
138 | Q>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA2723267 rs763296244 |
139 | A>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA2723266 rs552622624 |
142 | G>A | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs1180858614 CA355355015 |
142 | G>R | No |
ClinGen gnomAD |
|
|
CA355354993 rs1193640815 |
145 | P>L | No |
ClinGen gnomAD |
|
|
rs534835483 CA2723265 |
145 | P>S | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA355354991 rs1343824093 |
146 | S>P | No |
ClinGen TOPMed |
|
|
rs762417809 CA2723264 |
147 | R>G | No |
ClinGen ExAC gnomAD |
|
|
CA2723263 rs775959153 |
147 | R>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA2723262 rs768225948 |
148 | S>C | No |
ClinGen ExAC gnomAD |
|
|
rs1311187474 CA355354949 |
152 | K>N | No |
ClinGen gnomAD |
|
|
CA2723261 rs373151457 |
153 | P>A | No |
ClinGen ESP ExAC gnomAD |
|
|
CA2723259 rs771910480 |
154 | A>G | No |
ClinGen ExAC gnomAD |
|
|
rs775278881 CA355354942 |
154 | A>P | No |
ClinGen ExAC gnomAD |
|
|
CA2723260 rs775278881 |
154 | A>T | No |
ClinGen ExAC gnomAD |
|
|
rs570590442 CA2723257 |
155 | R>* | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA2723258 rs570590442 |
155 | R>G | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA2723256 rs757103099 |
155 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs749266192 CA2723255 |
158 | T>A | No |
ClinGen ExAC |
|
|
CA355354919 rs1303785644 |
158 | T>I | No |
ClinGen gnomAD |
|
|
CA2723254 rs137891664 |
159 | T>I | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA2723251 rs766568506 |
160 | H>P | No |
ClinGen ExAC gnomAD |
|
|
rs751702934 CA2723252 |
160 | H>Y | No |
ClinGen ExAC gnomAD |
|
|
rs750749698 CA2723249 |
161 | T>I | No |
ClinGen ExAC gnomAD |
|
|
rs758662891 CA2723250 |
161 | T>P | No |
ClinGen ExAC gnomAD |
|
|
CA355354900 rs200895198 |
162 | S>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA2723247 rs200895198 |
162 | S>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs764577957 CA2723245 |
164 | W>R | No |
ClinGen ExAC gnomAD |
|
|
rs760250180 CA2723244 |
166 | S>G | No |
ClinGen ExAC gnomAD |
|
|
CA2723243 rs775186756 |
166 | S>T | No |
ClinGen ExAC gnomAD |
|
|
rs771818432 CA2723242 |
168 | P>L | No |
ClinGen ExAC gnomAD |
|
|
rs771818432 CA355354858 |
168 | P>R | No |
ClinGen ExAC gnomAD |
|
|
CA2723241 rs536995855 |
169 | G>V | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs11544780 CA88798168 |
171 | G>C | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs867410269 CA88798166 |
171 | G>D | No |
ClinGen Ensembl |
|
|
rs11544780 CA2723239 |
171 | G>S | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs749110009 CA2723238 |
173 | Q>* | No |
ClinGen ExAC gnomAD |
|
|
rs1321617841 CA355354811 |
175 | P>A | No |
ClinGen gnomAD |
|
|
CA355354799 rs1215176025 |
176 | E>D | No |
ClinGen gnomAD |
|
|
rs1275207272 CA355354802 |
176 | E>G | No |
ClinGen TOPMed gnomAD |
|
|
rs766247025 CA88797404 |
176 | E>Q | No |
ClinGen Ensembl |
|
|
CA2723212 rs779184025 |
177 | V>G | No |
ClinGen ExAC gnomAD |
|
|
CA355354797 rs1339371318 |
177 | V>M | No |
ClinGen gnomAD |
|
|
rs1383963637 CA355354791 |
178 | R>K | No |
ClinGen gnomAD |
|
|
rs1336435405 CA355354776 |
180 | K>* | No |
ClinGen TOPMed gnomAD |
|
|
CA355354773 rs1450050668 |
180 | K>M | No |
ClinGen TOPMed gnomAD |
|
|
rs1170551995 CA355354754 |
183 | P>S | No |
ClinGen gnomAD |
|
|
CA355354741 rs1408851698 |
185 | P>A | No |
ClinGen TOPMed gnomAD |
|
|
CA355354740 rs1408851698 |
185 | P>S | No |
ClinGen TOPMed gnomAD |
|
|
CA355354742 rs1408851698 |
185 | P>T | No |
ClinGen TOPMed gnomAD |
|
|
CA355354732 rs1347233400 |
186 | S>C | No |
ClinGen TOPMed |
|
|
CA88797349 rs867682635 |
187 | A>T | No |
ClinGen TOPMed gnomAD |
|
|
rs1242333776 CA355354725 |
188 | I>L | No |
ClinGen gnomAD |
|
|
rs1257926738 CA355354709 |
190 | Q>K | No |
ClinGen gnomAD |
|
|
rs1181446978 CA355354696 |
191 | A>V | No |
ClinGen gnomAD |
|
|
rs1234799977 CA355354689 |
192 | S>L | No |
ClinGen TOPMed gnomAD |
|
|
CA355354677 rs1205390920 |
193 | A>V | No |
ClinGen gnomAD |
|
|
rs62285797 CA88797340 |
194 | P>L | No |
ClinGen gnomAD |
|
|
rs1437285588 CA355354675 |
194 | P>T | No |
ClinGen TOPMed gnomAD |
|
|
rs778312659 CA355354656 |
195 | R>P | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs778312659 CA2723209 |
195 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs754196904 CA2723210 |
195 | R>W | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1314802106 CA355354651 |
196 | I>V | No |
ClinGen gnomAD |
|
|
rs1244167232 CA355354637 |
197 | L>I | No |
ClinGen gnomAD |
|
|
rs756638893 CA2723208 |
199 | V>M | No |
ClinGen ExAC TOPMed gnomAD |
No associated diseases with Q9H9H5
No regional properties for Q9H9H5
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| No domain, repeats, and functional sites for Q9H9H5 | |||
3 GO annotations of cellular component
| Name | Definition |
|---|---|
| cis-Golgi network | The network of interconnected tubular and cisternal structures located at the convex side of the Golgi apparatus, which abuts the endoplasmic reticulum. |
| Golgi-associated vesicle | Any vesicle associated with the Golgi complex and involved in mediating transport within the Golgi or between the Golgi and other parts of the cell. |
| microtubule | Any of the long, generally straight, hollow tubes of internal diameter 12-15 nm and external diameter 24 nm found in a wide variety of eukaryotic cells; each consists (usually) of 13 protofilaments of polymeric tubulin, staggered in such a manner that the tubulin monomers are arranged in a helical pattern on the microtubular surface, and with the alpha/beta axes of the tubulin subunits parallel to the long axis of the tubule; exist in equilibrium with pool of tubulin monomers and can be rapidly assembled or disassembled in response to physiological stimuli; concerned with force generation, e.g. in the spindle. |
2 GO annotations of molecular function
| Name | Definition |
|---|---|
| calmodulin binding | Binding to calmodulin, a calcium-binding protein with many roles, both in the calcium-bound and calcium-free states. |
| microtubule binding | Binding to a microtubule, a filament composed of tubulin monomers. |
5 GO annotations of biological process
| Name | Definition |
|---|---|
| cytoskeleton-dependent intracellular transport | The directed movement of substances along cytoskeletal fibers such as microfilaments or microtubules within a cell. |
| microtubule cytoskeleton organization | A process that is carried out at the cellular level which results in the assembly, arrangement of constituent parts, or disassembly of cytoskeletal structures comprising microtubules and their associated proteins. |
| N-terminal peptidyl-L-cysteine N-palmitoylation | The covalent attachment of a palmitoyl group to a nitrogen (N) atom in an N-terminal cysteine residue to form N-palmitoyl-L-cysteine. |
| negative regulation of microtubule depolymerization | Any process that stops, prevents, or reduces the frequency, rate or extent of microtubule depolymerization; prevention of depolymerization of a microtubule can result from binding by 'capping' at the plus end (e.g. by interaction with another cellular protein of structure) or by exposing microtubules to a stabilizing drug such as taxol. |
| regulation of microtubule cytoskeleton organization | Any process that modulates the frequency, rate or extent of the formation, arrangement of constituent parts, or disassembly of cytoskeletal structures comprising microtubules and their associated proteins. |
No homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| No homologous proteins | ||||
| 10 | 20 | 30 | 40 | 50 | 60 |
| MAWPCISRLC | CLARRWNQLD | RSDVAVPLTL | HGYSDLDSEE | PGTGGAASRR | GQPPAGARDS |
| 70 | 80 | 90 | 100 | 110 | 120 |
| GRDVPLTQYQ | RDFGLWTTPA | GPKDPPPGRG | PGAGGRRGKS | SAQSSAPPAP | GARGVYVLPI |
| 130 | 140 | 150 | 160 | 170 | 180 |
| GDADAAAAVT | TSYRQEFQAW | TGVKPSRSTK | TKPARVITTH | TSGWDSSPGA | GFQVPEVRKK |
| 190 | |||||
| FTPNPSAIFQ | ASAPRILNV |