Q92747
Gene name |
ARPC1A (SOP2L) |
Protein name |
Actin-related protein 2/3 complex subunit 1A |
Names |
SOP2-like protein |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:10552 |
EC number |
|
Protein Class |
|
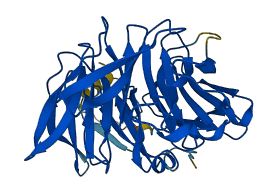
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
2 structures for Q92747
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| 6YW7 | EM | 450 A | C | 1-370 | PDB |
| AF-Q92747-F1 | Predicted | AlphaFoldDB |
196 variants for Q92747
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
CA368417274 rs1462466144 |
2 | S>P | No |
ClinGen gnomAD |
|
|
CA368417286 rs1170404248 |
3 | L>Q | No |
ClinGen gnomAD |
|
|
rs1427868082 CA368417284 |
3 | L>V | No |
ClinGen gnomAD |
|
|
rs1363229886 CA368417294 |
4 | H>Y | No |
ClinGen gnomAD |
|
|
rs1303163511 CA368417354 |
9 | E>G | No |
ClinGen gnomAD |
|
|
CA4363538 rs766393624 |
11 | I>M | No |
ClinGen ExAC gnomAD |
|
|
CA4363537 rs762792286 |
11 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs149266584 CA4363539 |
17 | N>S | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA368417449 rs1391822757 |
18 | R>G | No |
ClinGen gnomAD |
|
|
rs1229874788 CA368417471 |
20 | R>C | No |
ClinGen gnomAD |
|
|
CA368417474 rs759448154 |
20 | R>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA4363540 rs759448154 |
20 | R>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA4363541 rs144806851 |
21 | T>A | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA163762106 rs201712782 |
21 | T>I | No |
ClinGen 1000Genomes |
|
|
CA4363556 rs540837088 |
23 | I>M | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1303918172 CA368417506 |
23 | I>T | No |
ClinGen gnomAD |
|
|
CA368417511 rs1313025212 |
24 | A>V | No |
ClinGen gnomAD |
|
|
rs760240726 CA163762656 |
28 | N>S | No |
ClinGen TOPMed |
|
|
rs759358554 CA4363558 |
31 | E>K | No |
ClinGen ExAC gnomAD |
|
|
rs1330112758 CA368417583 |
34 | I>M | No |
ClinGen gnomAD |
|
|
rs1230440501 CA368417588 |
35 | Y>C | No |
ClinGen gnomAD |
|
|
rs1460702509 CA368417598 |
36 | K>N | No |
ClinGen gnomAD |
|
|
rs948572767 CA163762658 |
37 | K>R | No |
ClinGen TOPMed gnomAD |
|
|
CA4363560 rs562099938 |
39 | G>R | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA4363561 rs761938418 |
40 | S>N | No |
ClinGen ExAC gnomAD |
|
|
rs1176146383 CA368417640 |
42 | W>L | No |
ClinGen gnomAD |
|
|
rs1198716831 CA368417648 |
43 | V>A | No |
ClinGen TOPMed |
|
|
rs765553717 CA4363562 |
45 | A>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA163762659 rs142906076 |
46 | H>R | No |
ClinGen ESP |
|
|
rs1473391237 CA368417679 |
48 | L>V | No |
ClinGen gnomAD |
|
|
CA163762660 rs926009586 |
49 | K>R | No |
ClinGen Ensembl |
|
|
CA368417703 rs1173808204 |
51 | H>R | No |
ClinGen gnomAD |
|
|
rs1286844642 CA368417711 |
52 | N>S | No |
ClinGen TOPMed |
|
|
CA4363564 rs763123089 |
53 | G>R | No |
ClinGen ExAC gnomAD |
|
|
rs1425548319 CA368417726 |
54 | H>Q | No |
ClinGen TOPMed gnomAD |
|
|
CA4363565 rs199988949 |
54 | H>R | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs932128800 CA163762661 |
56 | T>A | No |
ClinGen TOPMed |
|
|
CA4363589 rs547379680 COSM1453249 |
58 | I>V | large_intestine [Cosmic] | No |
ClinGen cosmic curated 1000Genomes ExAC gnomAD |
|
CA368418167 rs1175568269 |
60 | W>* | No |
ClinGen TOPMed |
|
|
CA4363590 rs756536931 |
62 | P>S | No |
ClinGen ExAC gnomAD |
|
|
rs756763453 CA4363593 |
65 | D>G | No |
ClinGen ExAC gnomAD |
|
|
rs1264985190 CA368418212 |
65 | D>N | No |
ClinGen TOPMed |
|
|
CA4363594 rs778562420 |
66 | R>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1368025200 CA368418226 COSM1453250 |
66 | R>H | large_intestine [Cosmic] | No |
ClinGen cosmic curated TOPMed gnomAD |
|
CA368418329 rs1406100266 |
77 | Y>C | No |
ClinGen gnomAD |
|
|
rs140164246 CA4363595 |
80 | S>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs758388290 CA4363596 |
81 | Q>* | No |
ClinGen ExAC |
|
|
CA163763358 rs948990159 |
82 | K>N | No |
ClinGen TOPMed |
|
|
CA4363597 rs780080032 |
84 | G>S | No |
ClinGen ExAC gnomAD |
|
|
rs369324399 CA163763360 |
97 | R>C | No |
ClinGen ESP |
|
|
CA368418539 rs1247110812 |
97 | R>H | No |
ClinGen gnomAD |
|
|
CA163763361 COSM274054 rs1032525792 |
98 | A>T | large_intestine [Cosmic] | No |
ClinGen cosmic curated TOPMed gnomAD |
|
rs773238714 CA4363600 |
100 | T>A | No |
ClinGen ExAC gnomAD |
|
|
CA163763362 rs904544696 |
101 | F>L | No |
ClinGen TOPMed gnomAD |
|
|
CA163763363 rs892175396 |
102 | V>L | No |
ClinGen Ensembl |
|
|
rs749505817 CA4363601 |
103 | K>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs774390263 COSM1197581 CA163763364 |
106 | P>A | lung [Cosmic] | No |
ClinGen cosmic curated ExAC TOPMed gnomAD |
|
rs1256074182 CA368418607 |
106 | P>L | No |
ClinGen gnomAD |
|
|
rs774390263 CA4363603 |
106 | P>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1425588491 CA368418642 |
111 | F>C | No |
ClinGen TOPMed |
|
|
CA163763365 rs996740506 |
112 | A>S | No |
ClinGen Ensembl |
|
|
rs1028182511 CA163763366 |
116 | G>E | No |
ClinGen Ensembl |
|
|
rs370232879 CA4363608 |
118 | R>Q | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs983944152 CA163763368 |
122 | V>L | No |
ClinGen Ensembl |
|
|
CA163763832 rs746134443 |
140 | P>L | No |
ClinGen gnomAD |
|
|
rs777116048 CA4363628 COSM272125 |
142 | R>H | large_intestine [Cosmic] | No |
ClinGen cosmic curated ExAC gnomAD |
|
CA4363630 rs139328388 |
145 | V>I | No |
ClinGen ESP ExAC gnomAD |
|
|
rs750113267 CA4363631 |
147 | S>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1215354018 CA368418943 |
153 | N>D | No |
ClinGen TOPMed |
|
|
rs1341990677 CA368418954 |
154 | N>S | No |
ClinGen TOPMed gnomAD |
|
|
CA4363634 rs751088038 |
155 | V>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA368418958 rs751088038 |
155 | V>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs781029729 CA4363636 |
164 | F>L | No |
ClinGen ExAC gnomAD |
|
|
CA368294923 rs1562801455 |
168 | V>L | No |
ClinGen Ensembl |
|
|
rs1164787781 CA368294991 |
172 | Y>C | No |
ClinGen gnomAD |
|
|
rs571833149 CA4363649 |
173 | I>F | No |
ClinGen ExAC gnomAD |
|
|
rs571833149 CA163097546 |
173 | I>V | No |
ClinGen ExAC gnomAD |
|
|
CA368295004 rs1451118438 |
174 | K>E | No |
ClinGen gnomAD |
|
|
rs1451118438 CA368295003 |
174 | K>Q | No |
ClinGen gnomAD |
|
|
rs756403062 CA163097551 |
174 | K>T | No |
ClinGen Ensembl |
|
|
rs765993633 CA4363650 |
180 | P>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs952422659 CA368295084 |
181 | A>P | No |
ClinGen TOPMed gnomAD |
|
|
rs952422659 CA163097554 |
181 | A>T | No |
ClinGen TOPMed gnomAD |
|
|
rs1436553465 COSM271989 CA368295126 |
183 | T>M | large_intestine endometrium [Cosmic] | No |
ClinGen cosmic curated gnomAD |
|
CA368295233 rs1377531226 |
189 | M>T | No |
ClinGen gnomAD |
|
|
CA163097563 rs573083020 |
190 | P>A | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA4363653 rs573083020 |
190 | P>T | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA4363655 rs150009166 |
194 | L>P | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA368295434 rs1226764031 |
198 | F>L | No |
ClinGen gnomAD |
|
|
rs376725540 CA4363656 |
199 | G>D | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA368295467 rs1456217590 |
200 | G>C | No |
ClinGen TOPMed |
|
|
CA4363657 rs145223474 |
200 | G>V | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs11550144 CA163097573 |
207 | V>F | No |
ClinGen Ensembl |
|
|
CA368295748 rs1584384312 |
207 | V>G | No |
ClinGen Ensembl |
|
|
CA368295758 rs1378579075 |
208 | H>P | No |
ClinGen TOPMed |
|
|
rs781736363 CA4363662 |
209 | G>A | No |
ClinGen ExAC gnomAD |
|
|
CA4363661 rs768642928 |
209 | G>R | No |
ClinGen ExAC gnomAD |
|
|
rs1584384330 CA368295821 |
210 | V>G | No |
ClinGen Ensembl |
|
|
CA4363663 rs748658169 |
210 | V>I | No |
ClinGen ExAC gnomAD |
|
|
rs1412172519 CA368295827 |
211 | S>G | No |
ClinGen gnomAD |
|
|
CA4363665 rs773688364 |
215 | S>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs773895160 CA4363668 |
217 | S>N | No |
ClinGen ExAC gnomAD |
|
|
CA368296017 rs1209496423 |
218 | R>C | No |
ClinGen TOPMed |
|
|
CA368296024 rs1303538597 |
218 | R>H | No |
ClinGen TOPMed gnomAD |
|
|
rs1408294470 CA368296069 |
220 | A>G | No |
ClinGen gnomAD |
|
|
rs1584384360 CA368296113 |
222 | V>G | No |
ClinGen Ensembl |
|
|
rs1266272841 CA368296142 |
224 | H>Y | No |
ClinGen TOPMed |
|
|
rs767022179 COSM1093777 CA4363670 |
225 | D>N | endometrium [Cosmic] | No |
ClinGen cosmic curated ExAC TOPMed gnomAD |
|
CA4363672 rs760596520 |
228 | V>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs147646339 CA163097599 |
230 | V>A | No |
ClinGen ESP gnomAD |
|
|
rs764069129 CA4363674 |
232 | D>A | No |
ClinGen ExAC gnomAD |
|
|
rs200602020 CA163097605 |
232 | D>E | No |
ClinGen Ensembl |
|
|
rs764069129 CA4363673 |
232 | D>V | No |
ClinGen ExAC gnomAD |
|
|
CA368296334 rs1297846118 |
233 | A>G | No |
ClinGen TOPMed |
|
|
rs150004356 CA4363676 |
238 | Q>R | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1168095915 CA368297913 |
239 | V>F | No |
ClinGen TOPMed gnomAD |
|
|
rs1168095915 CA368297911 |
239 | V>I | No |
ClinGen TOPMed gnomAD |
|
|
CA4363689 rs774962272 |
240 | S>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs959257298 CA163098753 |
244 | T>A | No |
ClinGen TOPMed |
|
|
rs375022680 CA368298041 |
245 | E>D | No |
ClinGen ESP |
|
|
CA4363690 rs760218517 |
246 | F>S | No |
ClinGen ExAC gnomAD |
|
|
rs761612783 CA4363693 |
250 | L>R | No |
ClinGen ExAC gnomAD |
|
|
CA4363694 rs764935367 |
253 | S>* | No |
ClinGen ExAC gnomAD |
|
|
CA163098776 rs200974680 |
255 | V>A | No |
ClinGen 1000Genomes |
|
|
CA4363695 rs750287772 |
255 | V>F | No |
ClinGen ExAC gnomAD |
|
|
rs199658497 CA4363697 |
258 | N>D | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA368298260 rs1187679094 |
259 | S>C | No |
ClinGen gnomAD |
|
|
rs368913591 CA4363699 |
259 | S>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA4363700 rs201570380 |
260 | V>I | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA4363701 rs201570380 |
260 | V>L | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs779134177 CA368298280 |
261 | V>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs779134177 CA4363703 |
261 | V>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1584386397 CA368298311 |
263 | A>G | No |
ClinGen Ensembl |
|
|
CA368299370 rs1353514891 |
266 | D>E | No |
ClinGen gnomAD |
|
|
rs901011710 CA163099189 |
268 | C>F | No |
ClinGen TOPMed |
|
|
rs922447965 CA163099186 |
268 | C>R | No |
ClinGen Ensembl |
|
|
rs142247800 CA4363736 |
270 | M>V | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1278076111 CA368299581 |
274 | Y>C | No |
ClinGen gnomAD |
|
|
rs781337932 CA163099196 |
275 | D>G | No |
ClinGen Ensembl |
|
|
CA368299602 rs1428599750 |
275 | D>N | No |
ClinGen gnomAD |
|
|
CA368299643 rs1584387196 |
276 | D>A | No |
ClinGen Ensembl |
|
|
CA4363738 rs187071817 |
277 | R>C | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA4363739 rs187071817 |
277 | R>G | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs200959894 CA4363740 |
277 | R>H | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs576410572 CA4363742 |
278 | G>S | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA368299738 rs1365295123 |
279 | C>F | No |
ClinGen TOPMed gnomAD |
|
|
rs1365295123 CA368299739 |
279 | C>S | No |
ClinGen TOPMed gnomAD |
|
|
CA368299773 rs1584387224 |
281 | T>P | No |
ClinGen Ensembl |
|
|
rs2286160 CA4363746 |
283 | V>I | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs747559622 CA368299922 |
286 | L>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA163099215 rs910006701 |
287 | D>E | No |
ClinGen TOPMed gnomAD |
|
|
CA368299954 rs1305603218 |
287 | D>G | No |
ClinGen TOPMed gnomAD |
|
|
CA4363748 rs755659135 |
288 | I>L | No |
ClinGen ExAC gnomAD |
|
|
rs755659135 CA368299972 |
288 | I>V | No |
ClinGen ExAC gnomAD |
|
|
CA4363749 rs777784312 |
291 | Q>R | No |
ClinGen ExAC gnomAD |
|
|
CA4363751 rs529951024 |
295 | R>C | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA368300575 rs1349181083 |
302 | R>C | No |
ClinGen gnomAD |
|
|
CA368300579 rs1363073216 |
302 | R>H | No |
ClinGen TOPMed |
|
|
CA368300722 rs1156685683 |
304 | R>H | No |
ClinGen TOPMed |
|
|
rs776934695 CA4363755 |
305 | N>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs137914882 CA4363756 |
308 | K>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA368301041 rs1198178592 |
311 | T>A | No |
ClinGen TOPMed |
|
|
CA4363758 rs773348651 |
315 | R>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA4363760 rs766909995 |
316 | N>D | No |
ClinGen ExAC gnomAD |
|
|
CA4363761 rs751880782 |
316 | N>K | No |
ClinGen ExAC gnomAD |
|
|
rs1378168814 CA368301277 |
316 | N>S | No |
ClinGen gnomAD |
|
|
CA4363762 rs755391152 |
317 | T>A | No |
ClinGen ExAC gnomAD |
|
|
CA4363763 rs767015647 |
317 | T>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1237336619 CA368301416 |
319 | L>S | No |
ClinGen TOPMed |
|
|
rs1223105723 CA368301578 |
324 | Q>K | No |
ClinGen TOPMed |
|
|
CA368301654 rs1297798577 |
326 | S>G | No |
ClinGen TOPMed |
|
|
rs1382792215 CA368301671 |
326 | S>N | No |
ClinGen TOPMed |
|
|
rs759749177 CA4363780 |
335 | V>M | No |
ClinGen ExAC gnomAD |
|
|
rs1365023857 CA368302857 |
336 | D>H | No |
ClinGen TOPMed gnomAD |
|
|
CA4363781 rs767917071 |
337 | K>E | No |
ClinGen ExAC gnomAD |
|
|
rs1297758151 CA368304120 |
337 | K>N | No |
ClinGen gnomAD |
|
|
rs1320197623 CA368304126 |
338 | Q>K | No |
ClinGen gnomAD |
|
|
rs753059514 CA4363782 |
339 | D>A | No |
ClinGen ExAC gnomAD |
|
|
rs755771767 CA4363783 |
341 | R>C | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
COSM1093779 CA368304188 rs1336685684 |
341 | R>H | Variant assessed as Somatic; 0.0 impact. endometrium [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated NCI-TCGA TOPMed gnomAD |
|
rs1206513602 CA368304261 |
345 | T>A | No |
ClinGen gnomAD |
|
|
rs763882333 CA4363784 |
348 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs1159010389 CA368304338 |
349 | D>N | No |
ClinGen TOPMed |
|
|
CA163100223 rs987326157 |
352 | M>L | No |
ClinGen TOPMed gnomAD |
|
|
rs987326157 CA368304398 |
352 | M>V | No |
ClinGen TOPMed gnomAD |
|
|
CA4363785 rs187296347 |
354 | I>V | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
| TCGA novel | 357 | F>L | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1584390308 CA368304902 |
359 | T>P | No |
ClinGen Ensembl |
|
|
CA163100888 rs984482950 |
361 | E>K | No |
ClinGen TOPMed |
|
|
CA4363814 rs374155785 |
363 | S>F | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA4363815 rs758323414 |
367 | L>I | No |
ClinGen ExAC gnomAD |
|
|
CA4363817 rs755155389 |
368 | R>Q | No |
ClinGen ExAC gnomAD |
|
|
rs188648717 CA4363816 |
368 | R>W | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs754781207 CA4363818 |
370 | M>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA4363819 rs777900143 |
371 | M>C | No |
ClinGen ExAC gnomAD |
|
|
CA368305225 rs1276241239 |
371 | M>R | No |
ClinGen gnomAD |
No associated diseases with Q92747
No regional properties for Q92747
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| No domain, repeats, and functional sites for Q92747 | |||
6 GO annotations of cellular component
| Name | Definition |
|---|---|
| actin cytoskeleton | The part of the cytoskeleton (the internal framework of a cell) composed of actin and associated proteins. Includes actin cytoskeleton-associated complexes. |
| Arp2/3 protein complex | A stable protein complex that contains two actin-related proteins, Arp2 and Arp3, and five novel proteins (ARPC1-5), and functions in the nucleation of branched actin filaments. |
| cytosol | The part of the cytoplasm that does not contain organelles but which does contain other particulate matter, such as protein complexes. |
| extracellular exosome | A vesicle that is released into the extracellular region by fusion of the limiting endosomal membrane of a multivesicular body with the plasma membrane. Extracellular exosomes, also simply called exosomes, have a diameter of about 40-100 nm. |
| nucleus | A membrane-bounded organelle of eukaryotic cells in which chromosomes are housed and replicated. In most cells, the nucleus contains all of the cell's chromosomes except the organellar chromosomes, and is the site of RNA synthesis and processing. In some species, or in specialized cell types, RNA metabolism or DNA replication may be absent. |
| site of double-strand break | A region of a chromosome at which a DNA double-strand break has occurred. DNA damage signaling and repair proteins accumulate at the lesion to respond to the damage and repair the DNA to form a continuous DNA helix. |
2 GO annotations of molecular function
| Name | Definition |
|---|---|
| actin binding | Binding to monomeric or multimeric forms of actin, including actin filaments. |
| actin filament binding | Binding to an actin filament, also known as F-actin, a helical filamentous polymer of globular G-actin subunits. |
3 GO annotations of biological process
| Name | Definition |
|---|---|
| actin cytoskeleton organization | A process that is carried out at the cellular level which results in the assembly, arrangement of constituent parts, or disassembly of cytoskeletal structures comprising actin filaments and their associated proteins. |
| Arp2/3 complex-mediated actin nucleation | The actin nucleation process in which actin monomers combine to form a new branch on the side of an existing actin filament; mediated by the Arp2/3 protein complex and its interaction with other proteins. |
| regulation of actin filament polymerization | Any process that modulates the frequency, rate or extent of the assembly of actin filaments by the addition of actin monomers to a filament. |
No homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| No homologous proteins | ||||
| 10 | 20 | 30 | 40 | 50 | 60 |
| MSLHQFLLEP | ITCHAWNRDR | TQIALSPNNH | EVHIYKKNGS | QWVKAHELKE | HNGHITGIDW |
| 70 | 80 | 90 | 100 | 110 | 120 |
| APKSDRIVTC | GADRNAYVWS | QKDGVWKPTL | VILRINRAAT | FVKWSPLENK | FAVGSGARLI |
| 130 | 140 | 150 | 160 | 170 | 180 |
| SVCYFESEND | WWVSKHIKKP | IRSTVLSLDW | HPNNVLLAAG | SCDFKCRVFS | AYIKEVDEKP |
| 190 | 200 | 210 | 220 | 230 | 240 |
| ASTPWGSKMP | FGQLMSEFGG | SGTGGWVHGV | SFSASGSRLA | WVSHDSTVSV | ADASKSVQVS |
| 250 | 260 | 270 | 280 | 290 | 300 |
| TLKTEFLPLL | SVSFVSENSV | VAAGHDCCPM | LFNYDDRGCL | TFVSKLDIPK | QSIQRNMSAM |
| 310 | 320 | 330 | 340 | 350 | 360 |
| ERFRNMDKRA | TTEDRNTALE | TLHQNSITQV | SIYEVDKQDC | RKFCTTGIDG | AMTIWDFKTL |
| ESSIQGLRIM |