Q8NI29
Gene name |
FBXO27 (FBG5, FBX27) |
Protein name |
F-box only protein 27 |
Names |
F-box/G-domain protein 5 |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:126433 |
EC number |
|
Protein Class |
|
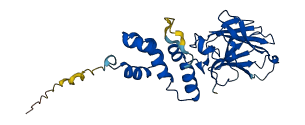
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for Q8NI29
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-Q8NI29-F1 | Predicted | AlphaFoldDB |
301 variants for Q8NI29
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
CA9424192 rs748940205 |
2 | G>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs945398955 CA308184252 |
3 | A>G | No |
ClinGen TOPMed |
|
|
CA9424190 rs755913113 |
4 | S>L | No |
ClinGen ExAC gnomAD |
|
|
CA405739963 rs1361536016 |
7 | R>T | No |
ClinGen TOPMed |
|
|
CA308184234 rs953290876 |
8 | G>D | No |
ClinGen TOPMed |
|
|
CA405739917 rs1465325096 |
11 | A>T | No |
ClinGen gnomAD |
|
|
rs1028876470 CA405739912 |
12 | R>G | No |
ClinGen TOPMed gnomAD |
|
|
rs767374933 CA9424188 |
12 | R>P | No |
ClinGen ExAC gnomAD |
|
|
rs767374933 CA405739910 |
12 | R>Q | No |
ClinGen ExAC gnomAD |
|
|
rs1028876470 CA308184229 |
12 | R>W | No |
ClinGen TOPMed gnomAD |
|
|
CA308184219 rs1049319969 |
13 | V>A | No |
ClinGen Ensembl |
|
|
CA405739882 rs1474873203 |
14 | P>L | No |
ClinGen gnomAD |
|
|
rs1167992316 CA405739891 |
14 | P>T | No |
ClinGen gnomAD |
|
|
rs1191448651 CA405739872 |
15 | A>E | No |
ClinGen gnomAD |
|
|
rs1371041324 CA405739878 |
15 | A>T | No |
ClinGen TOPMed gnomAD |
|
|
rs1225930428 CA405739856 |
16 | P>L | No |
ClinGen TOPMed |
|
|
rs1246333117 CA405739863 |
16 | P>S | No |
ClinGen gnomAD |
|
|
rs200735613 CA9424185 |
17 | E>D | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1465780933 CA405739854 |
17 | E>K | No |
ClinGen gnomAD |
|
|
rs1467266408 CA405739798 |
20 | P>L | No |
ClinGen TOPMed |
|
|
rs974716301 CA308184210 |
20 | P>S | No |
ClinGen TOPMed |
|
|
CA308184208 rs962963221 |
21 | E>K | No |
ClinGen TOPMed gnomAD |
|
|
CA9424183 rs775668068 |
22 | E>K | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA9424182 rs568874703 |
26 | L>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs759836493 CA9424181 |
27 | S>G | No |
ClinGen ExAC gnomAD |
|
|
rs999667583 CA308184204 |
27 | S>N | No |
ClinGen gnomAD |
|
|
rs1345856806 CA405739649 |
30 | P>T | No |
ClinGen gnomAD |
|
|
CA405739639 rs776796424 |
31 | P>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1021964250 CA308184203 |
31 | P>R | No |
ClinGen gnomAD |
|
|
CA9424180 rs776796424 |
31 | P>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA308184199 rs1011952943 |
32 | E>D | No |
ClinGen Ensembl |
|
|
CA405739619 rs1372402878 |
33 | L>V | No |
ClinGen gnomAD |
|
|
CA405739610 rs1328931311 |
34 | L>F | No |
ClinGen gnomAD |
|
|
CA308184187 rs866241766 |
35 | L>M | No |
ClinGen Ensembl |
|
|
CA9424179 rs771343796 |
35 | L>P | No |
ClinGen ExAC gnomAD |
|
|
CA405739599 rs747509291 |
36 | V>L | No |
ClinGen ExAC gnomAD |
|
|
rs747509291 CA9424178 |
36 | V>M | No |
ClinGen ExAC gnomAD |
|
|
CA308184176 rs950368719 |
37 | V>M | No |
ClinGen TOPMed |
|
|
rs1459507209 CA405739580 |
38 | L>P | No |
ClinGen TOPMed |
|
|
rs773919297 CA9424177 |
39 | S>G | No |
ClinGen ExAC gnomAD |
|
|
rs1328159250 CA405739354 |
39 | S>R | No |
ClinGen gnomAD |
|
|
CA405739342 rs1444868783 |
40 | H>Q | No |
ClinGen TOPMed |
|
|
CA405739344 rs1332054883 |
40 | H>R | No |
ClinGen TOPMed gnomAD |
|
|
CA308184166 rs867416088 |
41 | V>A | No |
ClinGen Ensembl |
|
|
CA405739315 rs1479737378 |
43 | P>Q | No |
ClinGen gnomAD |
|
|
rs1201047888 CA405739308 |
44 | R>C | No |
ClinGen Ensembl |
|
|
rs1600229918 CA405739293 |
45 | T>M | No |
ClinGen Ensembl |
|
|
rs557937230 CA9424175 |
47 | L>F | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs557937230 CA9424174 |
47 | L>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1324541866 CA405739275 |
48 | G>R | No |
ClinGen gnomAD |
|
|
CA405739261 rs1221520499 |
49 | R>P | No |
ClinGen gnomAD |
|
|
CA308184156 rs900315974 |
49 | R>S | No |
ClinGen TOPMed gnomAD |
|
|
rs780792637 CA405739196 |
55 | R>P | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA9424171 rs780792637 |
55 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1258992497 CA405739178 |
57 | W>* | No |
ClinGen TOPMed |
|
|
rs751469287 CA9424169 |
57 | W>C | No |
ClinGen ExAC gnomAD |
|
|
CA405739168 rs1335628265 |
58 | R>Q | No |
ClinGen TOPMed gnomAD |
|
|
CA9424168 rs764069272 |
59 | A>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA405739156 rs1404979921 |
60 | L>V | No |
ClinGen gnomAD |
|
|
rs1176137350 CA405739149 |
61 | V>M | No |
ClinGen gnomAD |
|
| TCGA novel | 62 | D>H | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs752735983 CA9424166 |
63 | G>D | No |
ClinGen ExAC gnomAD |
|
|
CA308184126 rs201772247 |
63 | G>S | No |
ClinGen Ensembl |
|
| TCGA novel | 65 | A>S | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
| TCGA novel | 65 | A>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA405739095 rs1178229448 |
66 | L>P | No |
ClinGen gnomAD |
|
|
rs1600229872 CA405739086 |
67 | W>L | No |
ClinGen Ensembl |
|
|
rs759623095 CA9424164 |
69 | L>M | No |
ClinGen ExAC |
|
|
CA405739050 rs776973730 |
71 | L>V | No |
ClinGen ExAC gnomAD |
|
|
CA9424162 rs766644679 |
72 | A>D | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1242815388 CA405739043 |
72 | A>T | No |
ClinGen gnomAD |
|
|
rs766644679 CA308184113 |
72 | A>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1284710177 CA405739009 |
75 | H>N | No |
ClinGen TOPMed gnomAD |
|
|
CA405738971 rs1388521897 |
78 | T>I | No |
ClinGen TOPMed gnomAD |
|
|
CA9424158 rs772655162 |
79 | G>A | No |
ClinGen ExAC gnomAD |
|
|
CA405738963 rs772655162 |
79 | G>D | No |
ClinGen ExAC gnomAD |
|
|
CA405738966 rs1348541993 |
79 | G>S | No |
ClinGen gnomAD |
|
|
rs762439507 CA9424157 |
80 | R>L | No |
ClinGen ExAC gnomAD |
|
|
CA405738961 rs1452798456 |
80 | R>S | No |
ClinGen TOPMed gnomAD |
|
|
rs1466968563 CA405738952 |
81 | A>P | No |
ClinGen TOPMed |
|
|
rs1466968563 CA405738953 |
81 | A>T | No |
ClinGen TOPMed |
|
|
CA9424155 rs769359931 |
81 | A>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA308184095 rs1037226082 |
83 | L>P | No |
ClinGen Ensembl |
|
|
CA308184089 rs996408877 |
84 | H>P | No |
ClinGen Ensembl |
|
|
rs201987206 CA405738928 |
84 | H>Q | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1160289289 CA405738925 |
85 | L>F | No |
ClinGen gnomAD |
|
|
rs780938353 CA405738920 |
86 | A>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA9424152 rs780938353 |
86 | A>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1406496126 CA405738914 |
87 | R>H | No |
ClinGen gnomAD |
|
|
rs770611381 CA9424151 |
87 | R>S | No |
ClinGen ExAC |
|
|
rs777578401 CA9424149 |
88 | S>R | No |
ClinGen ExAC gnomAD |
|
|
CA9424150 rs372776744 |
88 | S>R | No |
ClinGen ESP ExAC gnomAD |
|
|
CA308184074 rs910004508 |
90 | Q>* | No |
ClinGen Ensembl |
|
|
CA405738889 rs1279060763 |
91 | S>P | No |
ClinGen TOPMed |
|
|
rs199702227 CA9424148 |
92 | P>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs752647836 CA9424147 |
92 | P>L | No |
ClinGen ExAC gnomAD |
|
|
rs778849319 CA9424146 |
94 | R>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs755156097 CA9424145 |
94 | R>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA405738854 rs1445190869 |
97 | R>K | No |
ClinGen TOPMed gnomAD |
|
|
CA405738842 rs1293916015 |
99 | C>R | No |
ClinGen gnomAD |
|
|
rs140307492 CA405738834 |
100 | P>A | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs140307492 CA9424144 |
100 | P>S | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs557177068 CA9424143 |
101 | L>Q | No |
ClinGen 1000Genomes ExAC |
|
|
CA405738826 rs1476153033 |
102 | G>S | No |
ClinGen TOPMed |
|
|
CA405738821 rs1358042925 |
102 | G>V | No |
ClinGen gnomAD |
|
|
CA405738818 rs1481897417 |
103 | R>C | No |
ClinGen gnomAD |
|
|
CA405738807 rs1312291712 |
104 | F>L | No |
ClinGen gnomAD |
|
|
CA9424142 rs760998404 |
105 | C>R | No |
ClinGen ExAC gnomAD |
|
|
CA405738804 rs1600229751 |
105 | C>Y | No |
ClinGen Ensembl |
|
|
CA308184057 rs976416138 |
106 | A>G | No |
ClinGen Ensembl |
|
|
CA405738798 rs1289802789 |
106 | A>T | No |
ClinGen gnomAD |
|
|
CA405738792 rs1430523967 |
107 | R>C | No |
ClinGen gnomAD |
|
|
rs1419194841 CA405738775 |
110 | I>F | No |
ClinGen TOPMed |
|
|
rs762351705 CA9424139 |
110 | I>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1455010584 CA405738770 |
110 | I>S | No |
ClinGen TOPMed |
|
|
rs774980896 CA9424138 |
111 | G>E | No |
ClinGen ExAC gnomAD |
|
|
CA9424137 rs374354881 |
112 | R>C | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA308184042 rs374354881 |
112 | R>G | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1266929552 CA405738763 |
112 | R>H | No |
ClinGen Ensembl |
|
|
CA405738748 rs1430512278 |
114 | L>P | No |
ClinGen gnomAD |
|
|
CA9424135 rs776028592 |
115 | I>T | No |
ClinGen ExAC gnomAD |
|
|
rs1318982501 CA405738738 |
116 | R>C | No |
ClinGen TOPMed |
|
|
rs923749815 CA308184033 |
117 | N>D | No |
ClinGen Ensembl |
|
|
CA405738728 rs1347066714 |
117 | N>K | No |
ClinGen TOPMed |
|
|
rs977988168 CA308184030 |
118 | P>A | No |
ClinGen Ensembl |
|
|
CA405738721 rs1474282576 |
119 | C>R | No |
ClinGen TOPMed gnomAD |
|
|
COSM566466 rs377322565 CA308184026 |
120 | G>C | lung Variant assessed as Somatic; 0.0 impact. [Cosmic, NCI-TCGA] | No |
ClinGen cosmic curated ESP NCI-TCGA TOPMed gnomAD |
|
CA9424133 rs746672014 |
121 | Q>* | No |
ClinGen ExAC gnomAD |
|
|
CA9424131 rs771915331 |
122 | E>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1474027158 CA405738679 |
123 | G>D | No |
ClinGen TOPMed |
|
|
rs749184816 CA9424108 |
124 | L>P | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs780227318 CA9424107 |
125 | R>Q | No |
ClinGen ExAC gnomAD |
|
|
CA9424106 rs756321805 |
126 | K>N | No |
ClinGen ExAC gnomAD |
|
|
rs746083782 CA9424105 |
127 | W>* | No |
ClinGen ExAC gnomAD |
|
|
rs1028475471 CA308183770 |
128 | M>V | No |
ClinGen Ensembl |
|
|
rs201412395 CA9424104 |
129 | V>G | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 130 | Q>* | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs751910218 CA9424102 |
130 | Q>E | No |
ClinGen ExAC gnomAD |
|
|
CA405738621 rs1297016941 |
132 | G>D | No |
ClinGen TOPMed |
|
|
rs1369997227 CA405738614 |
133 | G>E | No |
ClinGen TOPMed |
|
|
CA9424099 rs753198889 |
134 | D>G | No |
ClinGen ExAC gnomAD |
|
|
CA405738612 rs1241716944 |
134 | D>Y | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA TOPMed gnomAD |
|
CA405738602 rs765866290 |
135 | G>D | No |
ClinGen ExAC gnomAD |
|
|
rs765866290 CA9424098 |
135 | G>V | No |
ClinGen ExAC gnomAD |
|
|
rs901294561 CA308183742 |
136 | W>* | No |
ClinGen Ensembl |
|
|
CA9424097 rs760214234 |
137 | V>G | No |
ClinGen ExAC gnomAD |
|
|
CA9424095 rs767112070 |
138 | V>G | No |
ClinGen ExAC gnomAD |
|
|
CA405738587 rs772833753 |
138 | V>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA9424096 rs772833753 |
138 | V>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs752994471 CA9424094 |
138 | V>S* | No |
ClinGen ExAC |
|
|
rs71356832 CA308183734 |
139 | E>K | No |
ClinGen Ensembl |
|
|
CA405738574 rs1290483675 |
140 | E>K | No |
ClinGen TOPMed gnomAD |
|
|
CA405738547 rs1363206148 |
144 | T>A | No |
ClinGen TOPMed gnomAD |
|
|
rs373360130 CA9424089 |
146 | P>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1250631666 CA405738527 |
147 | G>E | No |
ClinGen TOPMed gnomAD |
|
|
CA405738519 rs1182541239 |
148 | A>V | No |
ClinGen gnomAD |
|
|
rs1041434110 CA308183719 |
149 | P>A | No |
ClinGen TOPMed |
|
|
CA308183717 rs934686950 |
149 | P>L | No |
ClinGen Ensembl |
|
|
CA9424087 rs745893570 |
151 | Q>* | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
CA9424086 rs745893570 |
151 | Q>E | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA405738497 rs1430710553 |
152 | T>M | No |
ClinGen TOPMed |
|
|
rs1207317244 CA405738487 |
154 | F>L | No |
ClinGen TOPMed gnomAD |
|
|
rs553352586 CA9424085 |
155 | V>A | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs757431980 CA9424084 |
156 | T>I | No |
ClinGen ExAC gnomAD |
|
|
rs758754066 CA9424081 |
158 | F>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA9424080 rs560128340 |
159 | S>C | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 160 | W>C | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs779284829 CA9424062 |
161 | C>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA9424061 rs755414012 |
161 | C>W | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA405738429 rs1347123075 |
161 | C>Y | No |
ClinGen TOPMed |
|
|
CA405738419 rs372038018 |
162 | C>* | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA9424060 rs372038018 |
162 | C>W | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1168086252 CA405738422 |
162 | C>Y | No |
ClinGen gnomAD |
|
|
rs1039954348 CA308183649 |
164 | K>N | No |
ClinGen TOPMed gnomAD |
|
|
rs142305195 CA9424059 |
165 | Q>* | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs756786324 CA405738401 |
165 | Q>P | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs756786324 CA9424058 |
165 | Q>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs147557604 CA9424055 |
168 | D>A | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA405738382 rs147557604 |
168 | D>G | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA9424056 rs147557604 |
168 | D>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs751194105 CA9424057 |
168 | D>Y | No |
ClinGen ExAC gnomAD |
|
|
CA405738355 rs1275229083 |
172 | E>A | No |
ClinGen gnomAD |
|
| TCGA novel | 173 | G>R | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs759531862 CA9424052 |
173 | G>S | No |
ClinGen ExAC gnomAD |
|
|
CA308183624 rs1016232677 |
173 | G>V | No |
ClinGen Ensembl |
|
|
rs776774177 CA9424051 |
175 | W>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA308183618 rs984326093 |
175 | W>C | No |
ClinGen Ensembl |
|
|
rs1247770151 CA405738332 |
176 | P>S | No |
ClinGen TOPMed |
|
|
CA405738321 rs1225165851 |
177 | E>D | No |
ClinGen gnomAD |
|
|
rs1469221384 CA405738320 |
178 | L>V | No |
ClinGen TOPMed |
|
|
CA308183615 rs952987504 |
179 | L>P | No |
ClinGen TOPMed gnomAD |
|
|
CA9424049 rs760713666 |
180 | D>A | No |
ClinGen ExAC gnomAD |
|
|
rs750675525 CA405738306 |
180 | D>E | No |
ClinGen gnomAD |
|
|
CA9424047 rs375020908 |
183 | R>G | No |
ClinGen ESP ExAC gnomAD |
|
|
rs1600229164 CA405738280 |
184 | I>S | No |
ClinGen Ensembl |
|
|
rs772148808 CA9424046 |
184 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs748377164 CA9424045 |
185 | E>* | No |
ClinGen ExAC |
|
|
rs779194592 CA9424044 |
185 | E>G | No |
ClinGen ExAC |
|
|
rs769069394 CA9424043 |
186 | I>F | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 186 | I>M | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs769069394 CA405738271 |
186 | I>V | No |
ClinGen ExAC gnomAD |
|
|
CA9424041 rs780467479 |
187 | C>* | No |
ClinGen ExAC gnomAD |
|
|
CA9424042 rs749792128 |
187 | C>F | No |
ClinGen ExAC |
|
|
rs1177784179 CA405738249 |
189 | S>F | No |
ClinGen TOPMed |
|
| TCGA novel | 190 | D>E | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA308183582 rs111281031 |
190 | D>G | No |
ClinGen Ensembl |
|
|
CA405738238 rs1477330257 |
191 | W>* | No |
ClinGen TOPMed gnomAD |
|
|
CA9424020 rs145041815 |
191 | W>* | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA9424019 rs758046659 |
192 | W>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA405737831 rs1600227824 |
192 | W>G | No |
ClinGen Ensembl |
|
|
rs747770133 CA9424018 |
194 | A>V | No |
ClinGen ExAC gnomAD |
|
|
CA9424017 rs148842661 |
195 | R>* | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA308181543 rs375668074 |
195 | R>L | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs375668074 CA9424016 |
195 | R>Q | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1284817892 CA405737784 |
196 | H>Y | No |
ClinGen gnomAD |
|
|
CA9424014 rs145513352 |
197 | D>N | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1316543674 CA405737754 |
198 | S>G | No |
ClinGen gnomAD |
|
|
CA308181518 rs923431957 |
199 | G>S | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA TOPMed gnomAD |
|
CA405737719 rs1600227790 |
200 | C>R | No |
ClinGen Ensembl |
|
|
CA9424012 rs750436603 |
200 | C>Y | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs767582463 CA9424011 |
201 | M>I | No |
ClinGen ExAC gnomAD |
|
|
rs1446329924 CA405737701 |
201 | M>R | No |
ClinGen TOPMed gnomAD |
|
|
CA405737704 rs1446329924 |
201 | M>T | No |
ClinGen TOPMed gnomAD |
|
|
rs1206673695 CA405737709 |
201 | M>V | No |
ClinGen gnomAD |
|
|
rs1319499602 CA405737679 |
202 | Y>* | No |
ClinGen gnomAD |
|
|
CA9424008 rs764253515 |
206 | V>A | No |
ClinGen ExAC gnomAD |
|
|
rs377599554 CA9424009 |
206 | V>I | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ESP ExAC NCI-TCGA TOPMed gnomAD |
|
rs770250225 CA308181479 |
211 | A>P | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA9424005 rs770250225 |
211 | A>T | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
rs746355794 CA9424004 |
211 | A>V | No |
ClinGen ExAC gnomAD |
|
|
CA9424003 rs777232845 |
212 | N>S | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA gnomAD |
| TCGA novel | 213 | Q>H | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA405737491 rs1215727397 |
214 | T>I | No |
ClinGen gnomAD |
|
|
rs771683753 CA9424002 |
215 | V>D | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 216 | L>I | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs375252138 CA9424001 |
216 | L>V | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1600227750 CA405737466 |
217 | D>E | No |
ClinGen Ensembl |
|
|
rs978336508 CA308181437 |
217 | D>Y | No |
ClinGen TOPMed |
|
|
rs1320704648 CA405737413 |
223 | P>S | No |
ClinGen TOPMed gnomAD |
|
|
CA405737415 rs1320704648 |
223 | P>T | No |
ClinGen TOPMed gnomAD |
|
|
CA9423998 rs748987624 |
226 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs199923366 CA9423997 |
227 | P>L | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs199923366 CA9423996 |
227 | P>R | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs757208196 CA9423993 |
228 | Q>R | No |
ClinGen ExAC gnomAD |
|
|
CA9423992 rs751598989 |
229 | W>* | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 230 | N>S | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1425337024 CA405737317 |
231 | N>K | No |
ClinGen gnomAD |
|
|
CA308181413 rs376116058 |
232 | N>K | No |
ClinGen ESP TOPMed gnomAD |
|
|
CA405737309 rs1349393688 |
232 | N>S | No |
ClinGen gnomAD |
|
|
rs1411872866 CA405737275 |
236 | H>D | No |
ClinGen gnomAD |
|
|
CA9423990 rs763073051 |
236 | H>Q | No |
ClinGen ExAC gnomAD |
|
|
rs1419962459 CA405737271 |
236 | H>R | No |
ClinGen gnomAD |
|
|
rs766867465 CA9423965 |
240 | V>M | No |
ClinGen ExAC gnomAD |
|
|
CA405737212 rs1330871779 |
241 | F>C | No |
ClinGen TOPMed gnomAD |
|
|
CA405737213 rs1330871779 |
241 | F>S | No |
ClinGen TOPMed gnomAD |
|
|
CA9423964 rs761254347 |
242 | S>F | No |
ClinGen ExAC gnomAD |
|
|
CA405737189 COSM1304533 rs151102214 |
244 | I>M | urinary_tract [Cosmic] | No |
ClinGen cosmic curated ESP TOPMed gnomAD |
|
rs768023711 CA9423962 |
245 | K>E | No |
ClinGen ExAC gnomAD |
|
|
CA405737184 rs1222059770 |
245 | K>M | No |
ClinGen TOPMed |
|
|
rs1248348865 CA405737173 |
246 | M>I | No |
ClinGen TOPMed |
|
|
rs528287295 CA9423960 |
248 | V>F | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs528287295 CA9423959 |
248 | V>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA9423957 rs780951197 |
249 | R>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA308180594 rs961417634 |
249 | R>H | No |
ClinGen TOPMed |
|
|
rs1600227208 CA405737154 |
250 | F>S | No |
ClinGen Ensembl |
|
|
CA9423954 CA9423955 rs139767377 |
253 | F>L | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA9423952 rs370891116 |
254 | E>K | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
CA9423950 rs201679838 |
255 | H>P | No |
ClinGen 1000Genomes ExAC TOPMed |
|
|
CA9423951 rs778859564 |
255 | H>Y | No |
ClinGen ExAC gnomAD |
|
|
rs766850878 CA9423948 |
256 | R>Q | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
rs369513367 CA9423949 |
256 | R>W | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ESP ExAC NCI-TCGA gnomAD |
|
CA9423947 rs756589663 |
257 | G>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA405737098 rs1308628122 |
259 | D>V | No |
ClinGen TOPMed gnomAD |
|
|
CA308180546 rs910417292 |
261 | Q>* | No |
ClinGen TOPMed |
|
|
TCGA novel rs768021249 CA9423945 |
262 | F>L | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
NCI-TCGA ClinGen ExAC TOPMed gnomAD |
|
CA405737069 rs1291822747 |
263 | W>C | No |
ClinGen TOPMed |
|
|
rs1600227167 CA405737061 |
264 | A>V | No |
ClinGen Ensembl |
|
|
rs762261066 CA9423944 |
266 | H>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1399836340 CA405737042 |
267 | Y>* | No |
ClinGen gnomAD |
|
|
rs774999328 CA9423943 |
267 | Y>C | No |
ClinGen ExAC gnomAD |
|
|
CA405737046 rs1313131954 |
267 | Y>H | No |
ClinGen gnomAD |
|
|
rs1568459907 CA405737034 |
269 | A>T | No |
ClinGen Ensembl |
|
|
rs1290500823 CA405737026 |
270 | R>C | No |
ClinGen TOPMed gnomAD |
|
|
CA9423942 COSM144811 rs764710611 |
270 | R>H | Variant assessed as Somatic; 0.0 impact. haematopoietic_and_lymphoid_tissue [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ExAC NCI-TCGA TOPMed gnomAD |
|
CA9423941 rs759184088 |
271 | V>G | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 272 | T>I | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1385525052 CA405737007 |
273 | N>K | No |
ClinGen gnomAD |
|
|
CA308180537 rs112158067 |
273 | N>S | No |
ClinGen TOPMed gnomAD |
|
|
rs112158067 CA405737008 |
273 | N>T | No |
ClinGen TOPMed gnomAD |
|
| TCGA novel | 274 | S>C | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1231910868 CA405736997 |
275 | S>C | No |
ClinGen TOPMed |
|
|
CA405736996 rs1600227144 |
275 | S>N | No |
ClinGen Ensembl |
|
|
CA9423939 rs770688848 |
277 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs746754083 CA9423938 |
278 | V>M | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
CA9423937 rs371562321 |
279 | R>* | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ESP ExAC NCI-TCGA TOPMed gnomAD |
|
COSM188934 CA9423936 rs771973559 |
279 | R>Q | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ExAC NCI-TCGA TOPMed gnomAD |
|
rs1488939822 CA405736971 |
280 | V>I | No |
ClinGen gnomAD |
|
|
rs1488939822 CA405736970 |
280 | V>L | No |
ClinGen gnomAD |
|
|
CA9423935 rs369267515 |
281 | R>C | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ESP ExAC NCI-TCGA gnomAD |
|
CA9423934 rs141960657 COSM188933 |
281 | R>H | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ESP ExAC NCI-TCGA TOPMed gnomAD |
|
rs1568459876 CA405736944 |
284 | S>Y | No |
ClinGen Ensembl |
No associated diseases with Q8NI29
3 GO annotations of cellular component
| Name | Definition |
|---|---|
| cytoplasm | The contents of a cell excluding the plasma membrane and nucleus, but including other subcellular structures. |
| cytosol | The part of the cytoplasm that does not contain organelles but which does contain other particulate matter, such as protein complexes. |
| SCF ubiquitin ligase complex | A ubiquitin ligase complex in which a cullin from the Cul1 subfamily and a RING domain protein form the catalytic core; substrate specificity is conferred by a Skp1 adaptor and an F-box protein. SCF complexes are involved in targeting proteins for degradation by the proteasome. The best characterized complexes are those from yeast and mammals (with core subunits named Cdc53/Cul1, Rbx1/Hrt1/Roc1). |
No GO annotations of molecular function
| Name | Definition |
|---|---|
| No GO annotations for molecular function |
4 GO annotations of biological process
| Name | Definition |
|---|---|
| glycoprotein catabolic process | The chemical reactions and pathways resulting in the breakdown of a glycoprotein, a protein that contains covalently bound glycose (i.e. monosaccharide) residues; the glycose occurs most commonly as oligosaccharide or fairly small polysaccharide but occasionally as monosaccharide. |
| protein ubiquitination | The process in which one or more ubiquitin groups are added to a protein. |
| SCF-dependent proteasomal ubiquitin-dependent protein catabolic process | The chemical reactions and pathways resulting in the breakdown of a protein or peptide by hydrolysis of its peptide bonds, initiated by the covalent attachment of ubiquitin, with ubiquitin-protein ligation catalyzed by an SCF (Skp1/Cul1/F-box protein) complex, and mediated by the proteasome. |
| ubiquitin-dependent ERAD pathway | The series of steps necessary to target endoplasmic reticulum (ER)-resident proteins for degradation by the cytoplasmic proteasome. Begins with recognition of the ER-resident protein, includes retrotranslocation (dislocation) of the protein from the ER to the cytosol, protein ubiquitination necessary for correct substrate transfer, transport of the protein to the proteasome, and ends with degradation of the protein by the cytoplasmic proteasome. |
| 10 | 20 | 30 | 40 | 50 | 60 |
| MGASVSRGRA | ARVPAPEPEP | EEALDLSQLP | PELLLVVLSH | VPPRTLLGRC | RQVCRGWRAL |
| 70 | 80 | 90 | 100 | 110 | 120 |
| VDGQALWLLI | LARDHGATGR | ALLHLARSCQ | SPARNARPCP | LGRFCARRPI | GRNLIRNPCG |
| 130 | 140 | 150 | 160 | 170 | 180 |
| QEGLRKWMVQ | HGGDGWVVEE | NRTTVPGAPS | QTCFVTSFSW | CCKKQVLDLE | EEGLWPELLD |
| 190 | 200 | 210 | 220 | 230 | 240 |
| SGRIEICVSD | WWGARHDSGC | MYRLLVQLLD | ANQTVLDKFS | AVPDPIPQWN | NNACLHVTHV |
| 250 | 260 | 270 | 280 | ||
| FSNIKMGVRF | VSFEHRGQDT | QFWAGHYGAR | VTNSSVIVRV | RLS |