Q8IVV7
Gene name |
GID4 (C17orf39, VID24) |
Protein name |
Glucose-induced degradation protein 4 homolog |
Names |
Vacuolar import and degradation protein 24 homolog |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:79018 |
EC number |
|
Protein Class |
|
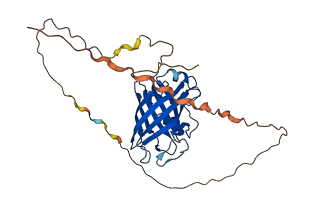
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
23 structures for Q8IVV7
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| 6CCR | X-ray | 160 A | A | 116-300 | PDB |
| 6CCT | X-ray | 240 A | A | 124-289 | PDB |
| 6CCU | X-ray | 175 A | A | 116-300 | PDB |
| 6CD8 | X-ray | 160 A | A/B | 124-289 | PDB |
| 6CD9 | X-ray | 155 A | A | 124-289 | PDB |
| 6CDC | X-ray | 175 A | A | 124-289 | PDB |
| 6CDG | X-ray | 160 A | A | 124-289 | PDB |
| 6WZX | X-ray | 175 A | A/B | 124-289 | PDB |
| 6WZZ | X-ray | 160 A | A | 124-289 | PDB |
| 7NSC | EM | 330 A | D | 1-300 | PDB |
| 7Q4Y | X-ray | 308 A | A/B | 100-300 | PDB |
| 7Q50 | X-ray | 316 A | A | 121-290 | PDB |
| 7SLZ | X-ray | 197 A | A | 124-289 | PDB |
| 7U3E | X-ray | 185 A | A/B | 124-289 | PDB |
| 7U3F | X-ray | 230 A | A | 124-289 | PDB |
| 7U3G | X-ray | 224 A | A | 124-289 | PDB |
| 7U3H | X-ray | 180 A | A | 124-289 | PDB |
| 7U3I | X-ray | 199 A | A/B | 124-289 | PDB |
| 7U3J | X-ray | 164 A | A | 124-289 | PDB |
| 7U3K | X-ray | 220 A | A | 124-289 | PDB |
| 7U3L | X-ray | 229 A | A | 124-289 | PDB |
| 8V1P | X-ray | 221 A | A | 124-289 | PDB |
| AF-Q8IVV7-F1 | Predicted | AlphaFoldDB |
186 variants for Q8IVV7
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
rs1235158213 CA398580991 |
3 | A>V | No |
ClinGen gnomAD |
|
|
rs889280811 CA288419051 |
4 | R>Q | No |
ClinGen Ensembl |
|
|
CA288419071 rs1032543574 |
8 | G>R | No |
ClinGen Ensembl |
|
|
rs956950340 CA288419078 |
10 | G>R | No |
ClinGen gnomAD |
|
|
rs553766703 CA8422050 |
11 | T>A | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs186674984 CA8422051 |
18 | P>S | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA398581126 rs186674984 |
18 | P>T | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1487775591 CA398581133 |
19 | C>R | No |
ClinGen gnomAD |
|
|
CA398581167 rs988567617 |
22 | V>F | No |
ClinGen TOPMed |
|
|
rs988567617 CA288419092 |
22 | V>I | No |
ClinGen TOPMed |
|
|
CA398581181 rs1248583561 |
23 | P>L | No |
ClinGen TOPMed |
|
|
rs1451181632 CA398581178 |
23 | P>S | No |
ClinGen TOPMed |
|
|
CA398581184 rs1182695949 |
24 | G>R | No |
ClinGen TOPMed |
|
|
rs1459836808 CA398581193 |
25 | S>P | No |
ClinGen TOPMed |
|
|
rs1209727327 CA398581208 |
26 | R>L | No |
ClinGen TOPMed gnomAD |
|
|
rs1209727327 CA398581209 |
26 | R>P | No |
ClinGen TOPMed gnomAD |
|
|
rs369896915 CA8422052 |
30 | E>K | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA398581241 rs369896915 |
30 | E>Q | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA398581254 rs1187074288 |
31 | R>C | No |
ClinGen gnomAD |
|
|
CA288419108 rs971226127 |
31 | R>P | No |
ClinGen TOPMed gnomAD |
|
|
CA398581256 rs1187074288 |
31 | R>S | No |
ClinGen gnomAD |
|
|
rs1344870465 CA398581290 |
34 | R>L | No |
ClinGen TOPMed |
|
|
CA288419134 rs927153372 |
35 | R>G | No |
ClinGen TOPMed gnomAD |
|
|
rs937141107 CA288419138 |
35 | R>K | No |
ClinGen Ensembl |
|
|
CA398581301 rs1452325956 |
36 | Q>* | No |
ClinGen TOPMed |
|
|
rs984736907 CA288419148 |
37 | R>P | No |
ClinGen TOPMed |
|
|
rs984736907 CA398581317 |
37 | R>Q | No |
ClinGen TOPMed |
|
|
CA288419153 rs909144033 |
38 | A>E | No |
ClinGen TOPMed gnomAD |
|
|
rs1348157956 CA398581341 |
40 | G>D | No |
ClinGen gnomAD |
|
|
rs751616570 CA8422053 |
40 | G>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1012350685 CA288419185 |
43 | S>P | No |
ClinGen TOPMed gnomAD |
|
|
rs1457488664 CA398581378 |
44 | R>P | No |
ClinGen TOPMed gnomAD |
|
|
CA288419189 rs1049247858 |
46 | H>P | No |
ClinGen TOPMed gnomAD |
|
|
rs922879032 CA288419197 |
46 | H>Q | No |
ClinGen TOPMed |
|
|
rs1388287942 CA398581411 |
48 | A>P | No |
ClinGen TOPMed gnomAD |
|
|
rs531574702 CA288419223 |
49 | R>L | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
rs531574702 CA288419212 |
49 | R>P | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA398581427 rs1245863567 |
50 | A>T | No |
ClinGen TOPMed |
|
|
rs1409625422 CA398581440 |
51 | R>L | No |
ClinGen TOPMed gnomAD |
|
|
CA398581441 rs1409625422 |
51 | R>P | No |
ClinGen TOPMed gnomAD |
|
|
rs1306433609 CA398581457 |
53 | G>C | No |
ClinGen TOPMed |
|
|
rs1597685500 CA398581470 |
54 | L>P | No |
ClinGen Ensembl |
|
|
CA398581480 rs1597685517 |
55 | S>F | No |
ClinGen Ensembl |
|
|
CA398581485 rs1318358699 |
56 | L>F | No |
ClinGen TOPMed gnomAD |
|
|
rs1597685531 CA398581488 |
56 | L>P | No |
ClinGen Ensembl |
|
|
rs1567582590 CA398581516 |
59 | T>I | No |
ClinGen Ensembl |
|
|
CA398581511 rs1445183315 |
59 | T>P | No |
ClinGen TOPMed gnomAD |
|
|
rs1183862074 CA398581520 |
60 | L>F | No |
ClinGen TOPMed |
|
|
CA398581523 rs1483210141 |
60 | L>H | No |
ClinGen TOPMed |
|
|
CA398581524 rs1483210141 |
60 | L>P | No |
ClinGen TOPMed |
|
|
rs1267548943 CA398581557 |
63 | S>P | No |
ClinGen TOPMed |
|
|
rs1038896729 CA288419242 |
64 | R>C | No |
ClinGen TOPMed gnomAD |
|
|
rs1319357393 CA398581574 |
64 | R>H | No |
ClinGen gnomAD |
|
| TCGA novel | 64 | R>S | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs894559468 CA288419252 |
65 | A>E | No |
ClinGen TOPMed |
|
|
CA398581579 rs1243455060 |
65 | A>T | No |
ClinGen gnomAD |
|
|
rs1286897078 CA398581602 |
66 | A>V | No |
ClinGen TOPMed |
|
|
rs564429104 CA288419258 |
67 | A>V | No |
ClinGen 1000Genomes gnomAD |
|
|
rs535142636 CA288419275 |
69 | V>A | No |
ClinGen TOPMed gnomAD |
|
|
CA398581637 rs747919270 |
69 | V>F | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs747919270 CA8422057 |
69 | V>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1411914709 CA398581668 |
71 | L>F | No |
ClinGen gnomAD |
|
|
rs533427067 CA8422058 |
72 | P>S | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA8422059 rs546695787 |
73 | L>F | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA398581707 rs1597685694 |
73 | L>P | No |
ClinGen Ensembl |
|
|
CA8422060 rs748773460 |
74 | P>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA8422062 rs775970305 |
75 | P>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA288419298 rs901476160 |
75 | P>S | No |
ClinGen TOPMed gnomAD |
|
|
CA398581748 rs1290214061 |
76 | A>S | No |
ClinGen gnomAD |
|
|
CA398581755 rs1376528231 |
76 | A>V | No |
ClinGen gnomAD |
|
|
CA288419305 rs1005076763 |
77 | L>M | No |
ClinGen Ensembl |
|
|
rs747481250 CA8422063 |
77 | L>P | No |
ClinGen ExAC gnomAD |
|
|
CA8422064 rs769053973 |
78 | A>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA288419320 rs933099340 |
80 | G>V | No |
ClinGen Ensembl |
|
|
rs1208144679 CA398581818 |
81 | D>H | No |
ClinGen TOPMed gnomAD |
|
|
CA8422066 rs762112011 |
81 | D>V | No |
ClinGen ExAC gnomAD |
|
|
rs1208144679 CA398581816 |
81 | D>Y | No |
ClinGen TOPMed gnomAD |
|
|
rs1330174550 CA398581844 |
82 | P>L | No |
ClinGen TOPMed gnomAD |
|
|
CA398581889 rs1266623731 |
85 | P>T | No |
ClinGen TOPMed |
|
| TCGA novel | 86 | V>I | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA8422068 rs773630948 |
87 | R>H | No |
ClinGen ExAC gnomAD |
|
|
rs1330024154 CA398581947 |
89 | E>K | No |
ClinGen TOPMed |
|
|
CA398582000 rs1262781665 |
91 | P>L | No |
ClinGen TOPMed |
|
|
rs1258397473 CA398582032 |
93 | P>L | No |
ClinGen gnomAD |
|
|
rs751607901 CA398582048 |
95 | G>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs751607901 COSM3402642 CA8422071 |
95 | G>S | Variant assessed as Somatic; 0.0 impact. central_nervous_system [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ExAC NCI-TCGA TOPMed gnomAD |
|
rs1411171337 CA398582066 |
96 | A>S | No |
ClinGen gnomAD |
|
|
rs759471091 CA288419381 |
98 | A>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs759471091 CA8422074 |
98 | A>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1161105911 CA398582109 |
99 | A>V | No |
ClinGen gnomAD |
|
|
rs1357059384 CA398582120 |
101 | A>T | No |
ClinGen gnomAD |
|
|
rs752508173 CA8422077 |
103 | S>L | No |
ClinGen ExAC gnomAD |
|
|
CA398582166 rs777389039 |
105 | I>M | No |
ClinGen ExAC TOPMed |
|
|
CA398582160 rs1356760005 |
105 | I>V | No |
ClinGen gnomAD |
|
|
rs1425240402 CA398582186 |
108 | P>S | No |
ClinGen TOPMed |
|
|
CA398582206 rs1288200102 |
110 | I>V | No |
ClinGen TOPMed gnomAD |
|
|
rs1010568648 CA288419416 |
111 | N>S | No |
ClinGen TOPMed |
|
|
CA8422081 rs756907498 |
113 | Q>E | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1277004671 CA398582251 |
113 | Q>R | No |
ClinGen gnomAD |
|
|
rs1311792554 CA398582277 |
115 | P>L | No |
ClinGen gnomAD |
|
|
rs1482083189 CA398582373 |
124 | S>G | No |
ClinGen gnomAD |
|
|
rs377621102 CA398582386 |
125 | G>C | No |
ClinGen ESP TOPMed gnomAD |
|
|
rs377621102 CA288419450 |
125 | G>S | No |
ClinGen ESP TOPMed gnomAD |
|
|
CA288419460 rs1032447528 |
126 | S>C | No |
ClinGen Ensembl |
|
|
rs781586887 CA8422085 |
129 | R>H | No |
ClinGen ExAC gnomAD |
|
|
CA8422086 rs748535840 |
131 | H>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA398582456 rs1432417586 |
131 | H>Y | No |
ClinGen TOPMed gnomAD |
|
| TCGA novel | 134 | S>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs975539508 CA288419477 |
144 | V>G | No |
ClinGen TOPMed |
|
|
CA398583085 rs764917589 |
147 | H>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA8422119 rs761634608 |
147 | H>R | No |
ClinGen ExAC gnomAD |
|
|
CA398583091 rs1389150572 |
148 | V>A | No |
ClinGen TOPMed |
|
|
rs750112471 CA8422121 COSM976179 |
148 | V>M | Variant assessed as Somatic; 0.0 impact. endometrium [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated ExAC NCI-TCGA gnomAD |
|
rs758076439 CA8422122 |
149 | D>N | No |
ClinGen ExAC gnomAD |
|
|
rs765753088 CA8422124 |
150 | T>K | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA8422123 rs765753088 |
150 | T>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA398583121 rs1406510354 |
151 | G>E | No |
ClinGen TOPMed gnomAD |
|
|
rs1406510354 CA398583124 |
151 | G>V | No |
ClinGen TOPMed gnomAD |
|
|
CA288421270 rs112996306 |
152 | N>S | No |
ClinGen Ensembl |
|
|
CA398583216 rs1157075473 |
160 | K>N | No |
ClinGen TOPMed |
|
|
CA398583245 rs1321386564 |
163 | G>D | No |
ClinGen gnomAD |
|
|
rs530802625 CA8422149 |
167 | E>A | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs1485680786 CA398572682 |
169 | P>R | No |
ClinGen gnomAD |
|
|
rs1250231709 CA398572699 |
171 | L>F | No |
ClinGen gnomAD |
|
|
rs1264041250 CA398572727 |
173 | T>I | No |
ClinGen TOPMed |
|
|
CA398572758 rs758509286 |
176 | E>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA8422152 rs758509286 |
176 | E>K | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 177 | G>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA398572793 rs1477023288 |
179 | I>K | No |
ClinGen gnomAD |
|
|
rs1192460626 CA398572803 |
180 | I>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA gnomAD |
|
CA8422155 rs768778982 |
181 | S>G | No |
ClinGen ExAC gnomAD |
|
|
CA398572812 rs144872624 |
181 | S>N | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA398572816 rs1166253296 |
181 | S>R | No |
ClinGen gnomAD |
|
|
CA8422156 rs144872624 |
181 | S>T | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA398572828 rs1215025561 |
182 | K>N | No |
ClinGen TOPMed |
|
| TCGA novel | 183 | K>N | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA288375951 rs146677351 |
184 | H>P | No |
ClinGen Ensembl |
|
| TCGA novel | 184 | H>T | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA8422158 rs769796611 |
185 | P>R | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 187 | L>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
| TCGA novel | 189 | R>C | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs138700962 CA8422159 |
189 | R>H | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1454415687 CA398572977 |
195 | E>D | No |
ClinGen TOPMed |
|
|
rs1383045516 CA398572999 |
197 | V>D | No |
ClinGen TOPMed |
|
|
rs762847388 CA8422160 |
199 | R>Q | No |
ClinGen ExAC gnomAD |
|
|
rs1409183480 CA398573029 |
199 | R>W | No |
ClinGen gnomAD |
|
|
CA398576420 rs1408493697 |
207 | A>S | No |
ClinGen gnomAD |
|
| TCGA novel | 209 | Y>L | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1374432386 CA398576465 |
210 | Q>E | No |
ClinGen gnomAD |
|
|
CA288378314 rs1015548587 |
210 | Q>R | No |
ClinGen Ensembl |
|
|
rs1225837408 COSM976180 CA398576492 |
211 | Y>C | Variant assessed as Somatic; 0.0 impact. endometrium [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated NCI-TCGA TOPMed gnomAD |
|
CA398576508 rs1311889156 |
212 | A>T | No |
ClinGen gnomAD |
|
|
CA398576514 rs1235084408 |
212 | A>V | No |
ClinGen gnomAD |
|
|
CA288378317 rs866971433 |
214 | S>L | No |
ClinGen Ensembl |
|
|
CA8422203 rs768276699 |
217 | S>L | No |
ClinGen ExAC gnomAD |
|
|
CA398576622 rs1232249563 |
219 | D>G | No |
ClinGen gnomAD |
|
|
CA398576643 rs1567588708 |
220 | F>L | No |
ClinGen Ensembl |
|
|
rs763403472 CA8422205 |
223 | E>K | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA288378330 rs961266678 |
224 | E>K | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
ClinGen Ensembl NCI-TCGA |
|
rs1312815100 CA398576721 |
225 | L>V | No |
ClinGen TOPMed |
|
|
CA8422206 rs766905777 |
226 | K>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA8422207 rs141270542 |
227 | N>S | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA288378337 rs560517467 |
229 | D>N | No |
ClinGen Ensembl |
|
|
rs200321621 CA8422209 |
231 | V>I | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs200321621 CA8422210 |
231 | V>L | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1567589413 CA398577520 |
243 | D>G | No |
ClinGen Ensembl |
|
| TCGA novel | 252 | A>T | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA398577602 rs1363379650 |
253 | S>A | No |
ClinGen gnomAD |
|
| TCGA novel | 254 | F>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs775732469 CA8422228 |
261 | C>S | No |
ClinGen ExAC gnomAD |
|
|
CA8422229 rs760900535 |
262 | F>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA398577704 rs1471141922 |
266 | A>P | No |
ClinGen TOPMed |
|
|
CA398577734 rs1216203904 |
269 | I>V | No |
ClinGen gnomAD |
|
|
rs764253071 COSM3378092 CA8422230 |
275 | H>R | pancreas [Cosmic] | No |
ClinGen cosmic curated ExAC gnomAD |
|
rs1021022672 CA288380082 |
278 | S>L | No |
ClinGen Ensembl |
|
|
CA8422231 rs753921949 |
280 | W>R | No |
ClinGen ExAC gnomAD |
|
|
CA8422257 rs754791891 |
285 | N>I | No |
ClinGen ExAC gnomAD |
|
|
CA8422258 rs754791891 |
285 | N>S | No |
ClinGen ExAC gnomAD |
|
|
rs150762880 CA8422256 |
285 | N>Y | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA8422259 rs752280108 |
287 | T>A | No |
ClinGen ExAC gnomAD |
|
|
CA398578129 rs752280108 |
287 | T>S | No |
ClinGen ExAC gnomAD |
|
|
CA398578149 rs1365431309 |
289 | V>I | No |
ClinGen TOPMed |
|
|
CA8422260 rs755777454 |
290 | P>S | No |
ClinGen ExAC gnomAD |
|
|
rs201429044 CA288381859 |
291 | E>G | No |
ClinGen Ensembl |
|
|
rs1314671213 CA398578188 |
294 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
rs1333710659 CA398578191 |
295 | P>S | No |
ClinGen gnomAD |
No associated diseases with Q8IVV7
1 GO annotations of cellular component
| Name | Definition |
|---|---|
| ubiquitin ligase complex | A protein complex that includes a ubiquitin-protein ligase and enables ubiquitin protein ligase activity. The complex also contains other proteins that may confer substrate specificity on the complex. |
1 GO annotations of molecular function
| Name | Definition |
|---|---|
| ubiquitin protein ligase activity | Catalysis of the transfer of ubiquitin to a substrate protein via the reaction X-ubiquitin + S -> X + S-ubiquitin, where X is either an E2 or E3 enzyme, the X-ubiquitin linkage is a thioester bond, and the S-ubiquitin linkage is an amide bond: an isopeptide bond between the C-terminal glycine of ubiquitin and the epsilon-amino group of lysine residues in the substrate or, in the linear extension of ubiquitin chains, a peptide bond the between the C-terminal glycine and N-terminal methionine of ubiquitin residues. |
1 GO annotations of biological process
| Name | Definition |
|---|---|
| proteasome-mediated ubiquitin-dependent protein catabolic process | The chemical reactions and pathways resulting in the breakdown of a protein or peptide by hydrolysis of its peptide bonds, initiated by the covalent attachment of ubiquitin, and mediated by the proteasome. |
No homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| No homologous proteins | ||||
| 10 | 20 | 30 | 40 | 50 | 60 |
| MCARGQVGRG | TQLRTGRPCS | QVPGSRWRPE | RLLRRQRAGG | RPSRPHPARA | RPGLSLPATL |
| 70 | 80 | 90 | 100 | 110 | 120 |
| LGSRAAAAVP | LPLPPALAPG | DPAMPVRTEC | PPPAGASAAS | AASLIPPPPI | NTQQPGVATS |
| 130 | 140 | 150 | 160 | 170 | 180 |
| LLYSGSKFRG | HQKSKGNSYD | VEVVLQHVDT | GNSYLCGYLK | IKGLTEEYPT | LTTFFEGEII |
| 190 | 200 | 210 | 220 | 230 | 240 |
| SKKHPFLTRK | WDADEDVDRK | HWGKFLAFYQ | YAKSFNSDDF | DYEELKNGDY | VFMRWKEQFL |
| 250 | 260 | 270 | 280 | 290 | |
| VPDHTIKDIS | GASFAGFYYI | CFQKSAASIE | GYYYHRSSEW | YQSLNLTHVP | EHSAPIYEFR |