Q7Z5D8
Gene name |
NANOGNB |
Protein name |
NANOG neighbor homeobox |
Names |
Homeobox protein C14 |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:360030 |
EC number |
|
Protein Class |
|
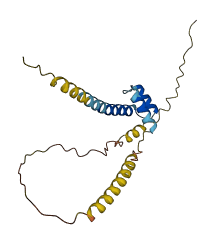
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for Q7Z5D8
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-Q7Z5D8-F1 | Predicted | AlphaFoldDB |
188 variants for Q7Z5D8
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
CA383769930 rs1448697391 |
2 | H>Y | No |
ClinGen gnomAD |
|
|
rs775855759 CA232529466 |
3 | R>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs866678269 CA383769960 |
3 | R>P | No |
ClinGen TOPMed gnomAD |
|
|
rs866678269 CA232529472 |
3 | R>Q | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA TOPMed gnomAD |
|
rs775855759 CA232529468 |
3 | R>W | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1004499232 CA232529476 |
4 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
CA232529477 rs747317808 |
5 | R>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA383770002 rs141049797 |
5 | R>L | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA6429820 rs141049797 |
5 | R>P | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA383769997 rs141049797 |
5 | R>Q | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA6429819 rs747317808 |
5 | R>W | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1193948826 CA383770006 |
6 | W>R | No |
ClinGen TOPMed |
|
|
CA383770048 rs1363620658 |
8 | T>M | No |
ClinGen TOPMed gnomAD |
|
|
CA383770100 rs1298795291 |
12 | P>L | No |
ClinGen gnomAD |
|
|
CA232529491 rs796713985 |
13 | A>E | No |
ClinGen TOPMed gnomAD |
|
|
rs1344595825 CA383770107 |
13 | A>T | No |
ClinGen gnomAD |
|
|
CA232529493 rs796713985 |
13 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
rs1258329211 CA383770126 |
14 | L>F | No |
ClinGen TOPMed |
|
| TCGA novel | 14 | L>I | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1357079068 CA383770148 |
15 | W>* | No |
ClinGen TOPMed gnomAD |
|
|
rs1211690983 CA383770154 |
15 | W>* | No |
ClinGen gnomAD |
|
|
CA383770143 rs1264965838 |
15 | W>R | No |
ClinGen gnomAD |
|
|
CA232529497 rs886214263 |
16 | E>D | No |
ClinGen TOPMed |
|
|
rs1266206139 CA383770173 |
16 | E>G | No |
ClinGen TOPMed gnomAD |
|
|
CA383770198 rs149820722 |
17 | A>G | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs149820722 CA6429821 |
17 | A>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA383770213 rs1421693425 |
18 | E>G | No |
ClinGen gnomAD |
|
|
rs1249603000 CA383770203 |
18 | E>K | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA gnomAD |
|
CA383770236 rs1368562230 |
19 | A>G | No |
ClinGen TOPMed gnomAD |
|
|
rs12818448 CA6429823 |
19 | A>T | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1368562230 CA383770238 |
19 | A>V | No |
ClinGen TOPMed gnomAD |
|
|
rs913303343 CA383770259 |
21 | R>G | No |
ClinGen gnomAD |
|
|
CA383770270 rs1457167753 |
22 | S>T | No |
ClinGen gnomAD |
|
|
CA383770280 rs1367741383 |
23 | R>* | No |
ClinGen gnomAD |
|
|
rs1394528557 CA383770283 |
23 | R>Q | No |
ClinGen TOPMed gnomAD |
|
|
CA383770298 rs1464066389 |
25 | Q>K | No |
ClinGen TOPMed |
|
|
CA383770302 rs1384149279 |
25 | Q>R | No |
ClinGen gnomAD |
|
|
rs1341261705 CA383770330 |
27 | I>F | No |
ClinGen gnomAD |
|
|
CA383770339 rs1247167975 |
27 | I>M | No |
ClinGen gnomAD |
|
|
rs1427988437 CA383770337 |
27 | I>S | No |
ClinGen TOPMed |
|
|
CA383770344 rs1266300920 |
28 | E>* | No |
ClinGen TOPMed gnomAD |
|
|
CA383770341 rs1266300920 |
28 | E>K | No |
ClinGen TOPMed gnomAD |
|
|
rs1478589413 CA383770350 |
28 | E>V | No |
ClinGen TOPMed |
|
|
CA383770360 rs1193354082 |
29 | T>A | No |
ClinGen TOPMed |
|
|
CA383770381 rs1199258327 |
30 | I>M | No |
ClinGen TOPMed |
|
|
CA383770374 rs1209208359 |
30 | I>N | No |
ClinGen TOPMed gnomAD |
|
|
rs1209208359 CA383770379 |
30 | I>S | No |
ClinGen TOPMed gnomAD |
|
|
rs763011633 CA6429825 |
32 | A>S | No |
ClinGen ExAC gnomAD |
|
|
CA383770415 rs1258791968 |
34 | K>Q | No |
ClinGen TOPMed |
|
|
CA383770418 rs1199645570 |
34 | K>T | No |
ClinGen gnomAD |
|
|
CA383770973 rs1183670554 |
35 | K>N | No |
ClinGen TOPMed gnomAD |
|
|
CA232532940 rs1034341755 |
37 | S>T | No |
ClinGen TOPMed |
|
|
CA232532946 rs778968033 |
38 | A>G | No |
ClinGen Ensembl |
|
|
rs1260603097 CA383770998 |
39 | M>I | No |
ClinGen gnomAD |
|
|
rs755627184 CA6429831 |
40 | P>L | No |
ClinGen ExAC gnomAD |
|
|
CA383771006 rs1433479206 |
41 | W>R | No |
ClinGen TOPMed |
|
|
rs1436850930 CA383771044 |
45 | P>L | No |
ClinGen TOPMed gnomAD |
|
|
CA383771046 rs1463684279 |
46 | E>Q | No |
ClinGen TOPMed |
|
|
rs1306356071 CA383771058 |
47 | Q>L | No |
ClinGen TOPMed gnomAD |
|
|
rs1306356071 CA383771057 |
47 | Q>R | No |
ClinGen TOPMed gnomAD |
|
|
CA383771073 rs1435887727 |
50 | G>R | No |
ClinGen gnomAD |
|
|
CA383771080 rs1565471587 |
51 | N>D | No |
ClinGen Ensembl |
|
|
rs1427686963 CA383771103 |
52 | Y>* | No |
ClinGen TOPMed |
|
|
CA383771118 rs1410560373 |
54 | E>K | No |
ClinGen gnomAD |
|
|
CA6429833 rs114136506 |
58 | N>S | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1218520248 CA383771199 |
59 | G>E | No |
ClinGen gnomAD |
|
|
rs1592110296 CA383771206 |
60 | K>R | No |
ClinGen Ensembl |
|
|
CA383771272 rs1225869520 |
63 | W>C | No |
ClinGen gnomAD |
|
|
CA383771260 rs1008856218 |
63 | W>G | No |
ClinGen TOPMed gnomAD |
|
|
CA232532982 rs1008856218 |
63 | W>R | No |
ClinGen TOPMed gnomAD |
|
|
CA383771279 rs1249277936 |
64 | R>K | No |
ClinGen TOPMed |
|
|
rs1249277936 CA383771280 |
64 | R>T | No |
ClinGen TOPMed |
|
|
rs1322694842 CA383771320 |
67 | G>* | No |
ClinGen TOPMed |
|
|
rs758922229 CA6429834 |
69 | A>T | No |
ClinGen ExAC gnomAD |
|
|
CA232533013 rs929362242 |
74 | E>K | No |
ClinGen Ensembl |
|
|
CA6429835 rs185000545 |
75 | R>* | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA383771442 rs1244414463 |
75 | R>Q | No |
ClinGen TOPMed gnomAD |
|
|
rs769053712 CA6429837 |
76 | E>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1487793811 CA383771449 |
76 | E>K | No |
ClinGen gnomAD |
|
|
CA383771516 rs1167068511 |
80 | K>I | No |
ClinGen gnomAD |
|
| rs1455893486 | 81 | N>K | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA6429838 rs774570733 |
81 | N>S | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
| TCGA novel | 81 | N>T | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs143895543 CA6429840 |
82 | E>K | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
rs1348135869 CA383771573 |
84 | E>A | No |
ClinGen gnomAD |
|
|
CA6429841 rs776296089 |
85 | L>P | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs899708417 CA232533065 |
89 | Q>* | No |
ClinGen TOPMed gnomAD |
|
|
rs899708417 CA383771624 |
89 | Q>E | No |
ClinGen TOPMed gnomAD |
|
|
rs1432713702 CA383771685 |
93 | R>K | No |
ClinGen gnomAD |
|
|
CA232533071 rs932491421 |
93 | R>S | No |
ClinGen Ensembl |
|
|
CA6429842 rs763066551 |
95 | R>K | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 96 | E>A | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1365487163 CA383771723 |
96 | E>K | No |
ClinGen gnomAD |
|
|
rs1417091123 CA383771766 |
98 | E>V | No |
ClinGen TOPMed |
|
|
CA383771774 rs1181833946 |
99 | K>E | No |
ClinGen TOPMed |
|
|
rs373676869 CA6429843 |
102 | Q>E | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA232533086 rs924409705 |
102 | Q>R | No |
ClinGen TOPMed |
|
|
rs1221633120 CA383771827 |
104 | P>L | No |
ClinGen gnomAD |
|
|
rs1320541317 CA383771822 |
104 | P>S | No |
ClinGen TOPMed gnomAD |
|
|
rs1470218122 CA383771832 |
105 | E>K | No |
ClinGen TOPMed gnomAD |
|
| TCGA novel | 106 | K>R | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs759460411 CA6429845 |
107 | R>I | No |
ClinGen ExAC gnomAD |
|
|
rs993148562 CA383771872 |
107 | R>S | No |
ClinGen TOPMed |
|
|
rs767321679 CA6429846 |
108 | L>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs917955933 CA232533124 |
108 | L>F | No |
ClinGen TOPMed |
|
|
CA232533128 rs1053589945 |
109 | V>I | No |
ClinGen Ensembl |
|
|
rs948031139 CA232533129 |
112 | S>C | No |
ClinGen TOPMed |
|
|
CA6429847 rs752332013 |
115 | H>R | No |
ClinGen ExAC gnomAD |
|
|
rs749994978 CA6429848 |
116 | T>S | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1165562657 CA383772014 |
118 | W>* | No |
ClinGen gnomAD |
|
|
CA6429849 rs763596163 |
118 | W>R | No |
ClinGen ExAC gnomAD |
|
|
CA383772026 rs1396670870 |
119 | A>E | No |
ClinGen gnomAD |
|
|
CA383772030 rs1396670870 |
119 | A>G | No |
ClinGen gnomAD |
|
|
CA383772061 rs1455520176 |
121 | F>Y | No |
ClinGen gnomAD |
|
|
rs1216201382 CA383772073 |
122 | K>R | No |
ClinGen gnomAD |
|
|
rs1389050325 CA383772108 |
124 | N>K | No |
ClinGen gnomAD |
|
|
CA232533147 rs1045049151 |
124 | N>S | No |
ClinGen TOPMed gnomAD |
|
|
rs1459694844 CA383772115 |
125 | R>K | No |
ClinGen TOPMed |
|
|
rs1159073365 CA383772131 |
126 | C>Y | No |
ClinGen TOPMed |
|
|
CA383772145 rs1282118809 |
127 | P>S | No |
ClinGen gnomAD |
|
|
CA232533151 rs893631836 |
128 | T>I | No |
ClinGen TOPMed |
|
|
CA383772174 rs1294583298 |
129 | I>M | No |
ClinGen gnomAD |
|
|
rs1228464836 CA383772165 |
129 | I>V | No |
ClinGen gnomAD |
|
|
rs1337603031 CA383772177 |
130 | Q>* | No |
ClinGen TOPMed gnomAD |
|
|
rs1337603031 CA383772178 |
130 | Q>E | No |
ClinGen TOPMed gnomAD |
|
|
rs1207316556 CA383772183 |
130 | Q>P | No |
ClinGen gnomAD |
|
|
rs1009345618 CA232533155 |
132 | S>N | No |
ClinGen TOPMed |
|
|
CA383772241 rs1447982666 |
134 | S>A | No |
ClinGen TOPMed gnomAD |
|
|
CA383772237 rs1447982666 |
134 | S>T | No |
ClinGen TOPMed gnomAD |
|
|
rs906235511 CA232533160 |
137 | F>S | No |
ClinGen TOPMed |
|
|
rs756756506 CA6429851 |
139 | F>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA383772323 rs1301512948 |
140 | D>G | No |
ClinGen TOPMed |
|
|
CA383772315 rs1453256049 |
140 | D>N | No |
ClinGen TOPMed gnomAD |
|
|
CA383772342 rs1565471700 |
141 | M>I | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen Ensembl NCI-TCGA |
|
CA383772332 rs1420028097 |
141 | M>L | No |
ClinGen gnomAD |
|
|
rs1420028097 CA383772330 |
141 | M>V | No |
ClinGen gnomAD |
|
|
CA383772354 rs1471587269 |
142 | T>K | No |
ClinGen gnomAD |
|
|
CA383772367 rs1421305006 |
143 | H>R | No |
ClinGen TOPMed gnomAD |
|
|
rs1393420217 CA383772361 |
143 | H>Y | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA TOPMed |
|
rs1033935847 CA232533197 |
144 | K>Q | No |
ClinGen TOPMed gnomAD |
|
|
CA232533201 rs959864912 |
145 | Q>H | No |
ClinGen Ensembl |
|
|
CA6429857 rs748408334 |
146 | I>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs748408334 CA6429856 |
146 | I>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1471113052 CA383772732 |
147 | S>R | No |
ClinGen gnomAD |
|
|
rs1170611480 CA383772744 |
148 | Q>H | No |
ClinGen gnomAD |
|
|
rs1424127864 CA383772755 |
150 | F>I | No |
ClinGen gnomAD |
|
|
rs1435307624 CA383772767 |
151 | C>S | No |
ClinGen TOPMed |
|
|
CA383772772 rs1376715336 |
152 | K>E | No |
ClinGen TOPMed |
|
|
CA232533277 rs77290736 |
153 | T>K | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA6429858 COSM943676 rs77290736 |
153 | T>M | large_intestine endometrium [Cosmic] | No |
ClinGen cosmic curated 1000Genomes ExAC TOPMed gnomAD |
|
rs968445530 CA232533269 |
153 | T>P | No |
ClinGen TOPMed gnomAD |
|
|
CA383772809 rs1336880724 |
157 | Y>C | No |
ClinGen gnomAD |
|
|
CA232533305 rs548793247 |
158 | N>D | No |
ClinGen 1000Genomes gnomAD |
|
|
rs1273473394 CA383772819 |
158 | N>S | No |
ClinGen gnomAD |
|
|
CA383772828 rs1344691464 |
159 | K>E | No |
ClinGen gnomAD |
|
|
rs1486969213 CA383772845 |
160 | E>* | No |
ClinGen TOPMed |
|
|
rs1340297913 CA383772866 |
161 | M>I | No |
ClinGen gnomAD |
|
|
rs992784929 CA232533323 |
161 | M>T | No |
ClinGen TOPMed |
|
|
CA383772859 rs1282785980 |
161 | M>V | No |
ClinGen gnomAD |
|
|
rs1439498615 CA383772896 COSM943677 |
163 | K>N | endometrium [Cosmic] | No |
ClinGen cosmic curated gnomAD |
|
rs1251265431 CA383772885 |
163 | K>Q | No |
ClinGen gnomAD |
|
|
rs1196616546 CA383772900 |
164 | R>G | No |
ClinGen gnomAD |
|
|
CA232533334 rs932585824 |
164 | R>K | No |
ClinGen Ensembl |
|
|
CA383772935 rs1308232216 |
166 | H>R | No |
ClinGen TOPMed |
|
|
rs1275362113 CA383772965 |
168 | K>R | No |
ClinGen TOPMed |
|
|
CA232533336 rs376922335 |
169 | K>N | No |
ClinGen Ensembl |
|
|
CA6429861 rs774477338 |
170 | H>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA383773029 rs1454576237 |
172 | R>I | No |
ClinGen gnomAD |
|
|
CA232536110 rs1000835827 |
173 | W>R | No |
ClinGen TOPMed gnomAD |
|
| TCGA novel | 174 | R>K | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1195276652 CA383773767 |
175 | S>A | No |
ClinGen TOPMed gnomAD |
|
|
CA383773865 rs1350012375 |
179 | Q>* | No |
ClinGen TOPMed |
|
|
rs1033363486 CA232536127 |
179 | Q>R | No |
ClinGen Ensembl |
|
|
rs955955665 CA232536132 |
180 | G>D | No |
ClinGen Ensembl |
|
|
rs955955665 CA383773889 |
180 | G>V | No |
ClinGen Ensembl |
|
|
rs1448531706 CA383773915 |
181 | W>* | No |
ClinGen TOPMed gnomAD |
|
|
rs1448531706 CA383773924 |
181 | W>C | No |
ClinGen TOPMed gnomAD |
|
|
rs1592111454 CA383773930 |
182 | S>A | No |
ClinGen Ensembl |
|
|
rs184126538 CA6429875 |
183 | R>* | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA6429876 rs538087276 |
183 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA383773958 rs1592111465 |
184 | T>P | No |
ClinGen Ensembl |
|
| TCGA novel | 185 | P>H | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA383773991 rs1408625352 |
185 | P>L | No |
ClinGen TOPMed |
|
|
rs1024117210 CA232536152 |
186 | A>V | No |
ClinGen Ensembl |
|
|
CA383774012 rs1160291210 |
187 | L>F | No |
ClinGen TOPMed |
|
|
CA383774019 rs1468109251 |
187 | L>P | No |
ClinGen TOPMed |
|
|
CA383774058 rs1471546293 |
189 | K>L | No |
ClinGen TOPMed gnomAD |
|
|
rs1471546293 CA383774047 |
189 | K>S | No |
ClinGen TOPMed gnomAD |
No associated diseases with Q7Z5D8
1 regional properties for Q7Z5D8
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| domain | Homeobox domain | 100 - 160 | IPR001356 |
1 GO annotations of cellular component
| Name | Definition |
|---|---|
| nucleus | A membrane-bounded organelle of eukaryotic cells in which chromosomes are housed and replicated. In most cells, the nucleus contains all of the cell's chromosomes except the organellar chromosomes, and is the site of RNA synthesis and processing. In some species, or in specialized cell types, RNA metabolism or DNA replication may be absent. |
1 GO annotations of molecular function
| Name | Definition |
|---|---|
| DNA binding | Any molecular function by which a gene product interacts selectively and non-covalently with DNA (deoxyribonucleic acid). |
No GO annotations of biological process
| Name | Definition |
|---|---|
| No GO annotations for biological process |
No homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| No homologous proteins | ||||
| 10 | 20 | 30 | 40 | 50 | 60 |
| MHRARWLTPV | IPALWEAEAG | RSRGQEIETI | LANKKQSAMP | WDQDPEQSTG | NYSEDEQNGK |
| 70 | 80 | 90 | 100 | 110 | 120 |
| QKWREEGEAG | RKREREKEEK | NEKELQDEQE | NKRKRENEKQ | KQYPEKRLVS | KSLMHTLWAK |
| 130 | 140 | 150 | 160 | 170 | 180 |
| FKLNRCPTIQ | ESLSLSFEFD | MTHKQISQWF | CKTRKKYNKE | MSKRKHKKKH | MRWRSLCCQG |
| WSRTPALK |