O60870
Gene name |
KIN |
Protein name |
DNA/RNA-binding protein KIN17 |
Names |
Binding to curved DNA, KIN, antigenic determinant of recA protein homolog |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:22944 |
EC number |
|
Protein Class |
|
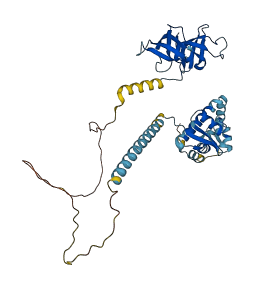
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
5 structures for O60870
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| 2CKK | X-ray | 145 A | A | 268-393 | PDB |
| 2V1N | NMR | - | A | 51-160 | PDB |
| 7ABH | EM | 450 A | 7 | 1-393 | PDB |
| 7ABI | EM | 800 A | 7 | 1-393 | PDB |
| AF-O60870-F1 | Predicted | AlphaFoldDB |
295 variants for O60870
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
rs75813059 CA375964674 CA5403218 |
2 | G>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA202432659 rs900702629 |
3 | K>E | No |
ClinGen TOPMed |
|
|
rs900216480 CA202432650 |
5 | D>E | No |
ClinGen Ensembl |
|
|
rs386740619 CA202432645 |
5 | D>P | No |
ClinGen Ensembl |
|
|
rs770083886 CA5403216 |
7 | L>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1173590662 CA375964565 |
8 | T>I | No |
ClinGen gnomAD |
|
|
rs1588492795 CA375964574 |
8 | T>P | No |
ClinGen Ensembl |
|
|
CA375964555 rs1420470418 |
9 | P>S | No |
ClinGen gnomAD |
|
|
rs144539815 CA5403215 |
10 | K>E | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA375964528 rs1471576117 |
10 | K>N | No |
ClinGen gnomAD |
|
|
rs758064650 CA5403214 |
10 | K>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs758064650 CA5403213 |
10 | K>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA5403212 rs781362469 |
12 | I>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA375964482 rs1211499824 |
13 | A>S | No |
ClinGen gnomAD |
|
|
CA375964450 rs1254313203 |
15 | R>G | No |
ClinGen gnomAD |
|
|
rs1218264652 CA375964442 |
15 | R>K | No |
ClinGen gnomAD |
|
|
rs766426045 CA202432595 |
17 | K>N | No |
ClinGen ExAC gnomAD |
|
|
CA5403209 rs753753404 |
17 | K>T | No |
ClinGen ExAC gnomAD |
|
|
rs267602587 CA202432590 |
18 | S>F | No |
ClinGen Ensembl |
|
|
rs1294513792 CA375964388 |
18 | S>P | No |
ClinGen gnomAD |
|
|
CA5403205 rs767826253 |
25 | R>C | No |
ClinGen ExAC gnomAD |
|
|
CA5403204 rs762135681 |
26 | W>S | No |
ClinGen ExAC gnomAD |
|
|
CA5403203 rs774292015 |
28 | C>F | No |
ClinGen ExAC gnomAD |
|
|
CA375964242 rs1419741886 |
30 | M>K | No |
ClinGen gnomAD |
|
|
rs1474823769 CA375964231 |
31 | C>F | No |
ClinGen gnomAD |
|
|
rs1430382491 CA375964229 |
31 | C>W | No |
ClinGen TOPMed |
|
|
rs764293669 CA5403202 |
33 | K>E | No |
ClinGen ExAC gnomAD |
|
|
rs138658111 CA5403199 |
37 | D>E | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA202430014 rs931036207 |
40 | G>R | No |
ClinGen Ensembl |
|
|
CA375963106 rs1253661916 |
40 | G>V | No |
ClinGen gnomAD |
|
|
CA5403184 rs757408871 |
42 | K>R | No |
ClinGen ExAC gnomAD |
|
|
rs751744621 CA5403183 |
45 | C>G | No |
ClinGen ExAC |
|
|
rs764224607 CA375962970 |
45 | C>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA5403182 rs764224607 |
45 | C>Y | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA375962924 rs1225768269 |
47 | S>A | No |
ClinGen gnomAD |
|
| TCGA novel | 47 | S>F | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA375962801 rs1326353709 |
53 | Q>H | No |
ClinGen gnomAD |
|
|
CA375962777 rs1273963800 |
55 | L>F | No |
ClinGen TOPMed |
|
|
CA375962678 rs1307042728 |
63 | Q>E | No |
ClinGen TOPMed |
|
|
CA5403180 rs752795151 |
66 | D>G | No |
ClinGen ExAC gnomAD |
|
|
rs1388305846 CA375962570 |
67 | Y>C | No |
ClinGen gnomAD |
|
|
CA375962537 rs1202496108 |
68 | F>C | No |
ClinGen TOPMed |
|
|
rs1299875843 CA375962509 |
70 | E>K | No |
ClinGen gnomAD |
|
|
rs773502551 CA5403153 |
72 | F>L | No |
ClinGen ExAC gnomAD |
|
|
rs138994831 CA5403152 |
73 | R>* | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs762761840 COSM1506123 CA5403151 |
73 | R>Q | lung Variant assessed as Somatic; 0.0 impact. [Cosmic, NCI-TCGA] | No |
ClinGen cosmic curated ExAC NCI-TCGA TOPMed gnomAD |
| TCGA novel | 75 | D>R | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs775127489 CA5403150 |
80 | L>V | No |
ClinGen ExAC gnomAD |
|
|
CA202427866 rs968586725 |
82 | R>G | No |
ClinGen gnomAD |
|
|
COSM179955 CA5403149 rs543372718 |
83 | R>C | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated 1000Genomes ExAC NCI-TCGA TOPMed gnomAD |
|
CA202427842 rs897969875 |
83 | R>H | No |
ClinGen TOPMed |
|
|
CA375961358 rs1345714730 |
85 | G>D | No |
ClinGen TOPMed |
|
|
rs767830072 CA5403135 |
92 | N>T | No |
ClinGen ExAC gnomAD |
|
|
CA375961300 rs1335338954 |
93 | I>M | No |
ClinGen gnomAD |
|
|
rs1283691688 CA375961289 |
95 | Y>C | No |
ClinGen gnomAD |
|
|
rs781551176 CA375961273 |
97 | E>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1271165858 COSM3699939 CA375961277 |
97 | E>K | liver Variant assessed as Somatic; impact. [Cosmic, NCI-TCGA] | No |
ClinGen cosmic curated NCI-TCGA gnomAD |
|
rs781551176 CA5403133 |
97 | E>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs765010600 CA5403132 |
102 | R>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA375961237 rs1434620378 |
102 | R>Q | No |
ClinGen TOPMed gnomAD |
|
|
rs1446990753 CA375961228 |
103 | E>D | No |
ClinGen TOPMed |
|
|
CA375961235 rs1386959834 |
103 | E>K | No |
ClinGen gnomAD |
|
|
CA375961222 rs1167501165 |
104 | H>L | No |
ClinGen gnomAD |
|
|
rs1214272698 CA375961218 |
105 | I>V | No |
ClinGen TOPMed |
|
|
rs1239622220 CA375961207 |
106 | H>L | No |
ClinGen TOPMed |
|
|
CA375961204 rs1413619072 |
107 | M>V | No |
ClinGen gnomAD |
|
|
rs1471556667 CA375961179 |
110 | T>S | No |
ClinGen gnomAD |
|
|
rs1483769631 CA375961178 |
110 | T>S | No |
ClinGen TOPMed |
|
|
rs1243323638 CA375961174 |
111 | Q>E | No |
ClinGen gnomAD |
|
|
rs1464127560 CA375961163 |
112 | W>* | No |
ClinGen gnomAD |
|
|
CA5403128 rs746981454 |
114 | T>A | No |
ClinGen ExAC gnomAD |
|
|
rs773042925 CA5403127 |
116 | T>S | No |
ClinGen ExAC gnomAD |
|
|
CA375960977 rs1473655058 |
121 | W>* | No |
ClinGen TOPMed |
|
|
rs747939384 CA5403125 |
122 | L>M | No |
ClinGen ExAC gnomAD |
|
|
CA5403124 rs779061286 |
122 | L>Q | No |
ClinGen ExAC gnomAD |
|
|
CA375960941 rs1224802155 |
123 | G>S | No |
ClinGen gnomAD |
|
|
rs146062558 CA5403123 |
125 | E>K | No |
ClinGen 1000Genomes ESP ExAC TOPMed gnomAD |
|
|
CA375960854 rs1227983684 |
126 | G>S | No |
ClinGen gnomAD |
|
|
rs1564323695 CA375960611 |
127 | L>S | No |
ClinGen Ensembl |
|
|
rs1368153046 CA375960591 |
128 | C>Y | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA gnomAD |
|
rs1175182483 CA375960581 |
129 | K>E | No |
ClinGen gnomAD |
|
|
rs749531176 CA5403101 |
129 | K>R | No |
ClinGen ExAC gnomAD |
|
| TCGA novel | 131 | D>G | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs376422622 CA202426883 |
132 | E>K | No |
ClinGen ESP TOPMed gnomAD |
|
|
CA375960529 rs1378421282 |
133 | T>I | No |
ClinGen TOPMed gnomAD |
|
|
rs1260036864 CA375960503 |
137 | W>L | No |
ClinGen TOPMed |
|
|
rs769696555 CA5403099 |
139 | I>S | No |
ClinGen ExAC gnomAD |
|
|
CA375960473 rs1486158464 |
141 | Y>C | No |
ClinGen TOPMed |
|
|
CA375960475 rs1312058523 |
141 | Y>H | No |
ClinGen Ensembl |
|
|
CA375960468 rs1181345536 |
142 | I>V | No |
ClinGen TOPMed gnomAD |
|
|
rs966939177 CA202426874 |
143 | D>H | No |
ClinGen TOPMed |
|
|
CA5403098 rs745992781 |
146 | P>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA375960437 rs745992781 |
146 | P>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1159178389 CA375960425 |
148 | T>S | No |
ClinGen TOPMed |
|
|
CA375960416 rs1564323597 |
149 | I>M | No |
ClinGen Ensembl |
|
|
CA202426840 rs1019856324 |
149 | I>V | No |
ClinGen TOPMed |
|
|
rs757887066 CA5403095 |
150 | R>C | No |
ClinGen ExAC gnomAD |
|
|
rs751941059 CA5403094 |
150 | R>H | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
CA202426816 rs751941059 |
150 | R>L | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs754659747 CA5403092 |
151 | R>Q | No |
ClinGen ExAC gnomAD |
|
|
COSM920600 rs778349410 CA5403093 |
151 | R>W | endometrium [Cosmic] | No |
ClinGen cosmic curated ExAC TOPMed gnomAD |
|
rs1358158138 CA375960390 |
154 | E>D | No |
ClinGen gnomAD |
|
|
CA375960395 rs1466252442 |
154 | E>K | No |
ClinGen gnomAD |
|
|
rs141967940 CA5403088 |
155 | L>V | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA202426780 rs1037090727 |
157 | K>E | No |
ClinGen TOPMed gnomAD |
|
|
CA375960373 rs1158387568 |
157 | K>R | No |
ClinGen gnomAD |
|
|
rs1222557964 CA375960360 |
159 | K>E | No |
ClinGen TOPMed |
|
|
CA375960357 rs1588484977 |
159 | K>R | No |
ClinGen Ensembl |
|
|
rs1259723412 CA375960333 |
162 | D>G | No |
ClinGen gnomAD |
|
|
CA375960335 rs1471546331 |
162 | D>N | No |
ClinGen gnomAD |
|
|
rs200315206 CA5403086 |
163 | L>P | No |
ClinGen 1000Genomes ExAC |
|
|
CA375960318 rs762812628 |
164 | D>E | No |
ClinGen ExAC gnomAD |
|
|
rs372557040 CA5403084 |
164 | D>G | No |
ClinGen ESP ExAC gnomAD |
|
| TCGA novel | 167 | E>K | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA5403081 rs775536218 |
168 | K>E | No |
ClinGen ExAC gnomAD |
|
|
CA5403080 rs770074660 |
169 | T>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1564323485 CA375960283 |
169 | T>I | No |
ClinGen Ensembl |
|
| rs769387138 | 169 | T>L | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA375960258 rs1337529126 |
173 | I>V | No |
ClinGen gnomAD |
|
|
CA375960247 rs1314270212 |
174 | E>V | No |
ClinGen gnomAD |
|
|
CA5403076 rs771559189 |
176 | Q>* | No |
ClinGen ExAC |
|
|
CA5403075 rs747572646 |
180 | G>D | No |
ClinGen ExAC gnomAD |
|
|
CA202426736 rs3195263 |
181 | L>Q | No |
ClinGen Ensembl |
|
|
CA375960200 rs1436784981 |
182 | E>K | No |
ClinGen gnomAD |
|
|
CA5403074 rs368815639 |
184 | K>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA202426707 rs947944866 |
186 | Q>E | No |
ClinGen Ensembl |
|
|
rs1308448539 CA375972888 |
187 | E>A | No |
ClinGen TOPMed |
|
|
rs747090014 CA5403057 |
188 | V>F | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs747090014 CA375972882 |
188 | V>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA5403056 rs773813197 |
189 | P>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA375972855 rs1450342917 |
190 | T>A | No |
ClinGen gnomAD |
|
|
rs35028405 CA202482061 |
191 | F>C | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen NCI-TCGA gnomAD |
|
CA5403055 rs772653681 |
191 | F>L | No |
ClinGen ExAC gnomAD |
|
|
CA5403054 rs748432497 |
192 | T>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA5403052 rs755708945 |
193 | E>K | No |
ClinGen ExAC gnomAD |
|
|
CA202482025 rs570532492 |
199 | D>V | No |
ClinGen 1000Genomes TOPMed |
|
| TCGA novel | 201 | E>R | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA202482015 rs1031084965 |
202 | K>I | No |
ClinGen TOPMed |
|
| TCGA novel | 203 | V>F | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
CA202482002 rs997909685 |
203 | V>I | No |
ClinGen TOPMed |
|
|
rs146426920 CA5403036 |
204 | T>K | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs146426920 CA5403035 |
204 | T>M | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA375972612 rs1178439555 |
206 | N>K | No |
ClinGen TOPMed |
|
|
rs1471555641 CA375972616 |
206 | N>S | No |
ClinGen TOPMed |
|
| TCGA novel | 207 | L>F | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1278276155 CA375972594 |
208 | S>T | No |
ClinGen gnomAD |
|
|
CA375972581 rs1346623984 |
209 | K>R | No |
ClinGen gnomAD |
|
|
rs749687842 CA5403033 |
211 | A>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA375972565 rs749687842 |
211 | A>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs756954757 CA5403031 |
212 | C>F | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA5403032 rs371796073 |
212 | C>R | No |
ClinGen ESP ExAC gnomAD |
|
|
CA5403029 rs777405277 |
214 | S>* | No |
ClinGen ExAC gnomAD |
|
|
rs1306202813 CA375972511 COSM1297447 |
215 | S>F | Variant assessed as Somatic; 0.0 impact. urinary_tract [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated NCI-TCGA gnomAD |
|
rs771540340 CA5403028 |
215 | S>M | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA202481130 rs985122818 |
216 | G>R | No |
ClinGen TOPMed |
|
|
CA5403026 rs752618588 |
216 | G>V | No |
ClinGen ExAC gnomAD |
|
|
CA375972493 rs1564321346 |
217 | A>V | No |
ClinGen Ensembl |
|
|
CA375972478 rs754778457 |
219 | S>A | No |
ClinGen ExAC gnomAD |
|
|
CA5403024 rs754778457 |
219 | S>P | No |
ClinGen ExAC gnomAD |
|
|
CA5403023 rs574697873 |
221 | K>E | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA5403022 rs766684581 |
221 | K>R | No |
ClinGen ExAC gnomAD |
|
|
rs761907223 CA5403000 |
224 | T>I | No |
ClinGen ExAC gnomAD |
|
|
CA375971457 rs761907223 |
224 | T>S | No |
ClinGen ExAC gnomAD |
|
|
CA5402995 rs201258955 |
227 | P>L | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA5402996 rs201258955 |
227 | P>Q | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA5402997 rs201258955 |
227 | P>R | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA375971347 rs1200603185 |
231 | K>E | No |
ClinGen TOPMed |
|
|
COSM1255877 CA202476250 rs976568227 |
232 | T>M | oesophagus [Cosmic] | No |
ClinGen cosmic curated TOPMed gnomAD |
|
CA202476247 rs1031398099 |
233 | I>T | No |
ClinGen TOPMed |
|
|
CA5402990 rs537183117 |
233 | I>V | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
rs768703107 CA5402989 |
235 | S>N | No |
ClinGen ExAC gnomAD |
|
|
rs375024826 CA202476219 |
240 | K>R | No |
ClinGen ESP TOPMed gnomAD |
|
|
rs780146167 CA5402987 |
241 | R>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs755932799 CA5402986 |
241 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA375971113 rs1295569121 |
246 | Q>* | No |
ClinGen gnomAD |
|
|
CA375971117 rs1295569121 |
246 | Q>K | No |
ClinGen gnomAD |
|
|
rs569891825 CA5402984 |
246 | Q>R | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA375971068 rs1452062421 |
249 | T>A | No |
ClinGen gnomAD |
|
|
CA202476164 rs781650990 |
249 | T>I | No |
ClinGen gnomAD |
|
|
rs1344404432 CA375971046 |
250 | Q>E | No |
ClinGen gnomAD |
|
|
rs1442168090 CA375971027 |
251 | S>A | No |
ClinGen TOPMed |
|
|
rs757464089 CA5402983 |
251 | S>C | No |
ClinGen ExAC gnomAD |
|
|
rs757464089 CA375971020 |
251 | S>F | No |
ClinGen ExAC gnomAD |
|
|
rs1227921882 CA375971010 |
252 | K>N | No |
ClinGen gnomAD |
|
|
CA5402982 rs751656774 |
253 | E>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA5402981 rs764214720 |
254 | K>N | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA375970908 rs1330958934 |
260 | A>S | No |
ClinGen gnomAD |
|
|
rs765763801 CA5402978 |
262 | D>G | No |
ClinGen ExAC gnomAD |
|
|
rs753132094 CA5402979 |
262 | D>H | No |
ClinGen ExAC gnomAD |
|
|
CA202476119 rs200953489 |
265 | M>L | No |
ClinGen ExAC gnomAD |
|
|
CA5402977 rs200953489 |
265 | M>V | No |
ClinGen ExAC gnomAD |
|
|
rs763861851 CA5402953 |
267 | I>V | No |
ClinGen ExAC gnomAD |
|
|
CA375969598 rs1442245894 |
268 | E>* | No |
ClinGen gnomAD |
|
| TCGA novel | 275 | A>G | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs775184486 CA5402950 |
275 | A>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs759453225 CA5402948 |
276 | R>* | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs759453225 CA5402949 |
276 | R>G | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs776641280 CA375969375 |
276 | R>P | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs776641280 CA5402947 |
276 | R>Q | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA5402946 rs555979267 |
278 | D>E | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA375969341 rs1304281475 |
278 | D>N | No |
ClinGen gnomAD |
|
|
CA375969297 rs1486608308 |
279 | Y>C | No |
ClinGen TOPMed gnomAD |
|
|
rs1411826803 CA375969284 |
280 | W>R | No |
ClinGen TOPMed |
|
|
rs866754801 CA202473002 |
282 | Q>* | No |
ClinGen TOPMed gnomAD |
|
|
rs866754801 CA202473008 |
282 | Q>K | No |
ClinGen TOPMed gnomAD |
|
|
rs184496860 CA5402945 |
283 | P>S | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs557034575 CA5402922 |
286 | I>M | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA375968877 rs1396565636 |
286 | I>V | No |
ClinGen TOPMed |
|
|
CA375968864 rs1423467054 |
287 | V>L | No |
ClinGen gnomAD |
|
|
rs1383690152 CA375968795 |
289 | I>N | No |
ClinGen gnomAD |
|
|
rs1450536869 CA375968756 |
290 | I>R | No |
ClinGen gnomAD |
|
|
rs761058408 CA5402921 |
290 | I>V | No |
ClinGen ExAC gnomAD |
|
|
rs1053111545 CA202470906 |
294 | L>P | Variant assessed as Somatic; impact. [NCI-TCGA] | No |
ClinGen Ensembl NCI-TCGA |
|
CA202470908 rs878969522 |
294 | L>V | No |
ClinGen Ensembl |
|
|
CA375968619 rs1311074395 |
295 | G>E | No |
ClinGen Ensembl |
|
|
rs1454440690 CA375968601 |
296 | E>D | No |
ClinGen TOPMed |
|
|
rs1000173401 CA202470867 |
296 | E>K | No |
ClinGen Ensembl |
|
|
CA5402918 rs768580001 |
298 | Y>C | No |
ClinGen ExAC gnomAD |
|
|
CA5402916 rs142416948 |
299 | H>P | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA5402917 rs142416948 |
299 | H>R | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA5402915 rs756688749 |
301 | K>* | No |
ClinGen ExAC gnomAD |
|
|
rs558356048 CA5402914 |
301 | K>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs781729374 CA5402913 |
302 | K>R | No |
ClinGen ExAC gnomAD |
|
|
CA5402912 rs757713279 |
303 | A>G | No |
ClinGen ExAC gnomAD |
|
|
CA5402911 rs374245592 |
304 | I>L | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA375968315 rs1294523128 |
304 | I>T | No |
ClinGen gnomAD |
|
|
CA375968222 rs1395195056 |
306 | K>M | No |
ClinGen gnomAD |
|
|
CA5402910 rs371102519 |
306 | K>Q | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
rs1291642813 CA375967739 |
308 | V>L | No |
ClinGen TOPMed |
|
|
CA375967690 rs1256331165 |
309 | I>T | No |
ClinGen TOPMed gnomAD |
|
|
CA5402885 rs774243588 |
310 | D>Y | No |
ClinGen ExAC gnomAD |
|
|
CA5402884 rs764222333 |
311 | K>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs943943880 CA202469820 |
313 | T>I | No |
ClinGen TOPMed |
|
|
rs763298952 CA375967545 |
315 | V>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs763298952 CA5402883 |
315 | V>D | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs911150533 CA202469796 |
317 | K>N | No |
ClinGen TOPMed |
|
|
rs775591297 CA5402882 |
319 | I>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs769931046 CA5402881 |
320 | D>A | No |
ClinGen ExAC gnomAD |
|
|
CA375967354 rs1391798177 |
321 | S>F | No |
ClinGen TOPMed |
|
|
CA5402880 rs745973707 |
323 | D>N | No |
ClinGen ExAC gnomAD |
|
|
CA375967304 rs1336417828 |
325 | L>V | No |
ClinGen gnomAD |
|
|
rs1391553456 CA375967255 |
329 | Q>E | No |
ClinGen gnomAD |
|
|
CA5402878 rs771610300 |
329 | Q>R | No |
ClinGen ExAC gnomAD |
|
|
CA375967234 rs747302138 |
330 | T>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA5402877 rs747302138 |
330 | T>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA5402876 rs778265485 |
333 | E>D | No |
ClinGen ExAC gnomAD |
|
|
rs754573388 CA5402875 |
334 | T>S | No |
ClinGen ExAC gnomAD |
|
|
CA375967126 rs1425139829 |
336 | I>V | No |
ClinGen gnomAD |
|
|
CA375967067 rs1588471958 |
339 | P>L | No |
ClinGen Ensembl |
|
|
CA5402873 rs779713924 |
339 | P>S | No |
ClinGen ExAC gnomAD |
|
|
CA375966705 rs1588470457 |
341 | K>E | No |
ClinGen Ensembl |
|
|
CA375966693 rs1291378859 COSM1349217 |
342 | R>I | Variant assessed as Somatic; 0.0 impact. large_intestine [NCI-TCGA, Cosmic] | No |
ClinGen cosmic curated NCI-TCGA gnomAD |
|
rs1291378859 CA375966695 |
342 | R>K | No |
ClinGen gnomAD |
|
|
CA375966677 rs1244014778 |
345 | V>L | No |
ClinGen gnomAD |
|
|
rs200833960 CA5402853 |
349 | G>D | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs745379380 CA5402852 |
355 | G>D | No |
ClinGen ExAC gnomAD |
|
|
rs1444046056 CA375966597 |
355 | G>S | No |
ClinGen TOPMed |
|
| TCGA novel | 356 | T>A | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs199577905 CA5402851 |
356 | T>I | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA375966578 rs1588470417 |
357 | L>I | No |
ClinGen Ensembl |
|
|
rs1438691347 CA375966574 |
357 | L>P | No |
ClinGen gnomAD |
|
|
rs777605827 CA375966523 |
361 | N>I | No |
ClinGen ExAC gnomAD |
|
|
rs777605827 CA5402848 |
361 | N>S | No |
ClinGen ExAC gnomAD |
|
|
CA5402847 rs758159893 |
362 | E>G | No |
ClinGen ExAC gnomAD |
|
|
CA375966485 rs1363614650 |
364 | T>A | No |
ClinGen TOPMed |
|
|
rs190127771 CA202467628 |
364 | T>N | No |
ClinGen 1000Genomes gnomAD |
|
| TCGA novel | 366 | S>Q | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs1402298418 CA375966443 |
367 | A>T | No |
ClinGen TOPMed |
|
|
CA5402846 rs145413656 |
367 | A>V | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA5402845 rs765522127 |
369 | I>V | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs376639368 CA5402843 |
370 | V>I | No |
ClinGen ESP ExAC TOPMed gnomAD |
|
|
CA375966392 rs1382932085 |
371 | I>V | No |
ClinGen TOPMed |
|
|
rs763344381 CA5402813 |
374 | G>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA375965761 rs764378394 |
374 | G>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs764378394 CA5402814 |
374 | G>R | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs764378394 CA375965762 |
374 | G>S | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA375965743 rs1408773633 |
377 | K>Q | No |
ClinGen gnomAD |
|
|
rs746493638 CA375965734 |
378 | G>* | No |
ClinGen ExAC gnomAD |
|
|
rs1468741707 CA375965732 |
378 | G>E | No |
ClinGen gnomAD |
|
|
CA5402810 rs746493638 |
378 | G>R | No |
ClinGen ExAC gnomAD |
|
|
rs772662628 CA5402809 |
379 | R>C | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
rs61752337 CA5402808 |
379 | R>H | Variant assessed as Somatic; 0.0 impact. [NCI-TCGA] | No |
ClinGen ExAC NCI-TCGA TOPMed gnomAD |
|
rs200055464 CA5402807 |
381 | V>I | No |
ClinGen ExAC gnomAD |
|
|
rs778997425 CA5402806 |
383 | G>A | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs778997425 CA375965684 |
383 | G>E | No |
ClinGen ExAC TOPMed gnomAD |
|
| TCGA novel | 383 | G>V | Variant assessed as Somatic; impact. [NCI-TCGA] | No | NCI-TCGA |
|
rs754780198 CA5402805 |
386 | Y>C | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA375965659 rs1433540801 |
386 | Y>H | No |
ClinGen gnomAD |
|
|
COSM83991 CA375965649 rs1222864192 |
387 | E>K | pancreas [Cosmic] | No |
ClinGen cosmic curated gnomAD |
|
rs1453181684 CA375965617 |
389 | I>M | No |
ClinGen gnomAD |
|
|
CA375965624 rs1316716525 |
389 | I>V | No |
ClinGen gnomAD |
|
|
CA202464574 rs999018937 |
390 | S>C | No |
ClinGen TOPMed gnomAD |
|
|
CA375965614 rs1381745225 |
390 | S>P | No |
ClinGen gnomAD |
|
|
rs999018937 CA202464578 |
390 | S>Y | No |
ClinGen TOPMed gnomAD |
|
|
CA375965565 rs1161956492 |
394 | A>W | No |
ClinGen gnomAD |
No associated diseases with O60870
Functions
6 GO annotations of cellular component
| Name | Definition |
|---|---|
| cytoplasm | The contents of a cell excluding the plasma membrane and nucleus, but including other subcellular structures. |
| intracellular membrane-bounded organelle | Organized structure of distinctive morphology and function, bounded by a single or double lipid bilayer membrane and occurring within the cell. Includes the nucleus, mitochondria, plastids, vacuoles, and vesicles. Excludes the plasma membrane. |
| nuclear matrix | The dense fibrillar network lying on the inner side of the nuclear membrane. |
| nucleoplasm | That part of the nuclear content other than the chromosomes or the nucleolus. |
| nucleus | A membrane-bounded organelle of eukaryotic cells in which chromosomes are housed and replicated. In most cells, the nucleus contains all of the cell's chromosomes except the organellar chromosomes, and is the site of RNA synthesis and processing. In some species, or in specialized cell types, RNA metabolism or DNA replication may be absent. |
| protein-containing complex | A stable assembly of two or more macromolecules, i.e. proteins, nucleic acids, carbohydrates or lipids, in which at least one component is a protein and the constituent parts function together. |
4 GO annotations of molecular function
| Name | Definition |
|---|---|
| DNA binding | Any molecular function by which a gene product interacts selectively and non-covalently with DNA (deoxyribonucleic acid). |
| double-stranded DNA binding | Binding to double-stranded DNA. |
| metal ion binding | Binding to a metal ion. |
| RNA binding | Binding to an RNA molecule or a portion thereof. |
5 GO annotations of biological process
| Name | Definition |
|---|---|
| cellular response to DNA damage stimulus | Any process that results in a change in state or activity of a cell (in terms of movement, secretion, enzyme production, gene expression, etc.) as a result of a stimulus indicating damage to its DNA from environmental insults or errors during metabolism. |
| DNA recombination | Any process in which a new genotype is formed by reassortment of genes resulting in gene combinations different from those that were present in the parents. In eukaryotes genetic recombination can occur by chromosome assortment, intrachromosomal recombination, or nonreciprocal interchromosomal recombination. Interchromosomal recombination occurs by crossing over. In bacteria it may occur by genetic transformation, conjugation, transduction, or F-duction. |
| DNA repair | The process of restoring DNA after damage. Genomes are subject to damage by chemical and physical agents in the environment (e.g. UV and ionizing radiations, chemical mutagens, fungal and bacterial toxins, etc.) and by free radicals or alkylating agents endogenously generated in metabolism. DNA is also damaged because of errors during its replication. A variety of different DNA repair pathways have been reported that include direct reversal, base excision repair, nucleotide excision repair, photoreactivation, bypass, double-strand break repair pathway, and mismatch repair pathway. |
| DNA replication | The cellular metabolic process in which a cell duplicates one or more molecules of DNA. DNA replication begins when specific sequences, known as origins of replication, are recognized and bound by initiation proteins, and ends when the original DNA molecule has been completely duplicated and the copies topologically separated. The unit of replication usually corresponds to the genome of the cell, an organelle, or a virus. The template for replication can either be an existing DNA molecule or RNA. |
| mRNA processing | Any process involved in the conversion of a primary mRNA transcript into one or more mature mRNA(s) prior to translation into polypeptide. |
No homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| No homologous proteins | ||||
| 10 | 20 | 30 | 40 | 50 | 60 |
| MGKSDFLTPK | AIANRIKSKG | LQKLRWYCQM | CQKQCRDENG | FKCHCMSESH | QRQLLLASEN |
| 70 | 80 | 90 | 100 | 110 | 120 |
| PQQFMDYFSE | EFRNDFLELL | RRRFGTKRVH | NNIVYNEYIS | HREHIHMNAT | QWETLTDFTK |
| 130 | 140 | 150 | 160 | 170 | 180 |
| WLGREGLCKV | DETPKGWYIQ | YIDRDPETIR | RQLELEKKKK | QDLDDEEKTA | KFIEEQVRRG |
| 190 | 200 | 210 | 220 | 230 | 240 |
| LEGKEQEVPT | FTELSRENDE | EKVTFNLSKG | ACSSSGATSS | KSSTLGPSAL | KTIGSSASVK |
| 250 | 260 | 270 | 280 | 290 | 300 |
| RKESSQSSTQ | SKEKKKKKSA | LDEIMEIEEE | KKRTARTDYW | LQPEIIVKII | TKKLGEKYHK |
| 310 | 320 | 330 | 340 | 350 | 360 |
| KKAIVKEVID | KYTAVVKMID | SGDKLKLDQT | HLETVIPAPG | KRILVLNGGY | RGNEGTLESI |
| 370 | 380 | 390 | |||
| NEKTFSATIV | IETGPLKGRR | VEGIQYEDIS | KLA |