B9A014
Gene name |
C21orf140 |
Protein name |
Uncharacterized protein C21orf140 |
Names |
Protein FAM243A |
Species |
Homo sapiens (Human) |
KEGG Pathway |
hsa:101928147 |
EC number |
|
Protein Class |
|
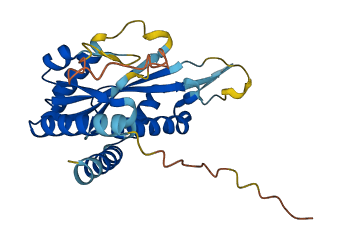
Descriptions
The autoinhibited protein was predicted that may have potential autoinhibitory elements via cis-regPred.
Autoinhibitory domains (AIDs)
Target domain |
|
Relief mechanism |
|
Assay |
cis-regPred |
Accessory elements
No accessory elements
Autoinhibited structure

Activated structure
1 structures for B9A014
| Entry ID | Method | Resolution | Chain | Position | Source |
|---|---|---|---|---|---|
| AF-B9A014-F1 | Predicted | AlphaFoldDB |
133 variants for B9A014
| Variant ID(s) | Position | Change | Description | Diseaes Association | Provenance |
|---|---|---|---|---|---|
|
CA410200820 rs1371376303 |
3 | R>C | No |
ClinGen Ensembl |
|
|
rs754422697 CA320368555 |
3 | R>H | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1445429323 CA410200807 |
5 | A>S | No |
ClinGen gnomAD |
|
|
rs1603073865 CA410200800 |
6 | S>N | No |
ClinGen Ensembl |
|
|
rs1280866362 CA410200794 |
7 | P>A | No |
ClinGen gnomAD |
|
|
rs1280866362 CA410200793 |
7 | P>S | No |
ClinGen gnomAD |
|
|
rs1201060652 CA410200761 |
12 | V>I | No |
ClinGen gnomAD |
|
|
rs887269574 CA320368554 |
13 | I>V | No |
ClinGen TOPMed gnomAD |
|
|
rs1051327945 CA320368553 |
18 | F>S | No |
ClinGen TOPMed |
|
|
rs934229461 CA320368550 |
21 | I>T | No |
ClinGen TOPMed gnomAD |
|
|
CA410200685 rs1277896812 |
22 | K>N | No |
ClinGen gnomAD |
|
|
CA320368549 rs922960529 |
23 | R>G | No |
ClinGen TOPMed |
|
|
CA410200668 rs1343029032 |
25 | Q>* | No |
ClinGen gnomAD |
|
|
rs1335643562 CA410200659 |
26 | C>Y | No |
ClinGen gnomAD |
|
|
rs1482932037 CA410200616 |
32 | T>N | No |
ClinGen gnomAD |
|
|
CA410200582 rs1174176687 |
38 | Y>N | No |
ClinGen gnomAD |
|
|
CA410200569 rs1424080262 |
39 | D>E | No |
ClinGen gnomAD |
|
|
CA320368547 rs1038711910 |
39 | D>V | No |
ClinGen TOPMed gnomAD |
|
|
rs1474563169 CA410200563 |
40 | G>A | No |
ClinGen gnomAD |
|
|
CA410200567 rs1185675742 |
40 | G>R | No |
ClinGen gnomAD |
|
|
CA320368545 rs751023574 |
44 | V>I | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1201085374 CA410200517 |
47 | G>R | No |
ClinGen gnomAD |
|
|
rs1201085374 CA410200516 |
47 | G>W | No |
ClinGen gnomAD |
|
|
CA320368544 rs766006108 |
48 | E>* | No |
ClinGen ExAC gnomAD |
|
|
rs979140055 CA320368542 |
50 | N>S | No |
ClinGen TOPMed gnomAD |
|
|
rs1285559560 CA410200470 |
54 | S>G | No |
ClinGen gnomAD |
|
|
rs1448205243 CA410200461 |
55 | L>F | No |
ClinGen gnomAD |
|
|
rs149449590 CA320368540 |
56 | V>I | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs796488591 CA320368539 |
57 | T>I | No |
ClinGen TOPMed gnomAD |
|
|
CA320368538 rs769554782 |
58 | G>E | No |
ClinGen ExAC gnomAD |
|
|
rs1169543354 CA410200445 |
58 | G>R | No |
ClinGen gnomAD |
|
|
CA410200437 rs1416318836 |
59 | E>V | No |
ClinGen gnomAD |
|
|
CA410200393 rs1182654955 |
65 | Y>C | No |
ClinGen gnomAD |
|
|
rs1241359682 CA410200344 |
72 | W>S | No |
ClinGen gnomAD |
|
|
CA320368533 rs776044416 |
76 | H>L | No |
ClinGen TOPMed gnomAD |
|
|
rs1033985021 CA320368534 |
76 | H>Y | No |
ClinGen TOPMed |
|
|
rs1164231125 CA410200307 |
77 | A>V | No |
ClinGen gnomAD |
|
|
rs138097057 CA320368532 |
78 | A>G | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1232783790 CA410200306 |
78 | A>T | No |
ClinGen gnomAD |
|
|
CA320368531 rs138097057 |
78 | A>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1004251659 CA320368529 |
81 | Q>* | No |
ClinGen TOPMed gnomAD |
|
|
rs1228546012 CA410200277 |
82 | G>A | No |
ClinGen gnomAD |
|
|
rs533145750 CA320368527 |
85 | P>S | No |
ClinGen 1000Genomes |
|
|
CA320368526 rs568957465 |
86 | W>R | No |
ClinGen 1000Genomes |
|
|
rs1448323216 CA410200230 |
89 | R>Q | No |
ClinGen gnomAD |
|
|
rs554245316 CA320368525 |
89 | R>W | No |
ClinGen ExAC gnomAD |
|
|
CA320368523 rs779232574 |
93 | R>T | No |
ClinGen ExAC gnomAD |
|
|
rs1165132827 CA410200194 |
95 | E>K | No |
ClinGen gnomAD |
|
|
rs1165132827 CA410200193 |
95 | E>Q | No |
ClinGen gnomAD |
|
|
CA410200181 rs1424295064 |
97 | C>S | No |
ClinGen gnomAD |
|
|
rs550638488 CA320368520 |
97 | C>Y | No |
ClinGen 1000Genomes |
|
|
rs1383564307 CA410200169 |
98 | I>M | No |
ClinGen gnomAD |
|
|
rs188833962 CA320368519 |
98 | I>T | No |
ClinGen 1000Genomes |
|
|
rs900102228 CA320368518 |
99 | K>N | No |
ClinGen TOPMed gnomAD |
|
|
rs1440362330 CA410200146 |
101 | E>D | No |
ClinGen gnomAD |
|
|
CA410200138 rs1175974322 |
102 | D>E | No |
ClinGen gnomAD |
|
|
CA410200140 rs1250522674 |
102 | D>V | No |
ClinGen gnomAD |
|
|
rs1489719823 CA410200136 |
103 | S>G | No |
ClinGen gnomAD |
|
|
rs1603073721 CA410200132 |
103 | S>I | No |
ClinGen Ensembl |
|
|
rs1222155213 CA410200050 |
115 | A>T | No |
ClinGen gnomAD |
|
|
rs1241777368 CA410200031 |
117 | G>A | No |
ClinGen gnomAD |
|
|
CA320368513 rs756633043 |
118 | K>N | No |
ClinGen ExAC gnomAD |
|
|
rs1222014025 CA410200014 |
120 | V>L | No |
ClinGen gnomAD |
|
|
CA320368510 rs751098555 |
122 | V>M | No |
ClinGen ExAC gnomAD |
|
|
CA320368509 rs781329442 |
123 | V>I | No |
ClinGen ExAC gnomAD |
|
|
CA410199997 rs781329442 |
123 | V>L | No |
ClinGen ExAC gnomAD |
|
|
rs1363985612 CA410199991 |
124 | K>E | No |
ClinGen gnomAD |
|
|
rs913765361 CA320368508 |
124 | K>N | No |
ClinGen TOPMed |
|
|
rs182813268 CA320368506 |
125 | E>D | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA320368505 rs61734923 |
127 | R>S | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs926569227 CA320368503 |
128 | Q>H | No |
ClinGen TOPMed |
|
|
CA320368504 rs750098444 |
128 | Q>R | No |
ClinGen ExAC gnomAD |
|
|
CA320368502 rs981089881 |
129 | Q>* | No |
ClinGen TOPMed gnomAD |
|
|
CA320368501 rs962782339 |
130 | E>Q | No |
ClinGen TOPMed gnomAD |
|
|
CA410199944 rs1426460590 |
131 | E>Q | No |
ClinGen gnomAD |
|
|
CA320368500 rs61740755 |
132 | Q>E | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA410199907 rs1266406756 |
136 | E>K | No |
ClinGen gnomAD |
|
|
CA410199860 rs1233835232 |
142 | G>A | No |
ClinGen gnomAD |
|
|
CA320368498 rs190636133 |
145 | Y>H | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA410199786 rs1487836365 |
153 | A>T | No |
ClinGen Ensembl |
|
|
CA410199772 rs1283811568 |
155 | I>F | No |
ClinGen gnomAD |
|
|
rs1222739741 CA410199737 |
159 | P>L | No |
ClinGen gnomAD |
|
|
rs951480902 CA320368495 |
161 | V>M | No |
ClinGen TOPMed gnomAD |
|
|
rs1279792300 CA410199718 |
162 | A>V | No |
ClinGen gnomAD |
|
|
rs1029680488 CA320368494 |
164 | S>C | No |
ClinGen TOPMed |
|
|
rs1400842940 CA410199683 |
167 | H>Q | No |
ClinGen gnomAD |
|
|
CA410199676 rs1568820384 |
168 | E>D | No |
ClinGen Ensembl |
|
|
rs1384468203 CA410199641 |
174 | S>F | No |
ClinGen gnomAD |
|
|
rs1287241461 CA410199639 |
175 | P>A | No |
ClinGen gnomAD |
|
|
rs1467621053 CA410199600 |
180 | N>I | No |
ClinGen gnomAD |
|
|
rs1360317380 CA410199597 |
181 | P>T | No |
ClinGen gnomAD |
|
|
CA410199582 rs1176323902 |
183 | D>N | No |
ClinGen gnomAD |
|
|
CA410199568 rs1426241947 |
185 | A>D | No |
ClinGen gnomAD |
|
|
rs998369318 CA320368492 |
185 | A>P | No |
ClinGen TOPMed |
|
|
rs1194794606 CA410199562 |
186 | W>* | No |
ClinGen gnomAD |
|
|
CA320368491 rs114036026 |
186 | W>C | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs867239143 CA320368489 |
191 | W>C | No |
ClinGen gnomAD |
|
|
CA320368490 rs1018560326 |
191 | W>L | No |
ClinGen TOPMed |
|
|
rs1184294885 CA410199524 |
192 | F>L | No |
ClinGen gnomAD |
|
|
rs1202974064 CA410199494 |
196 | N>D | No |
ClinGen gnomAD |
|
|
CA320368488 rs768915093 |
196 | N>S | No |
ClinGen Ensembl |
|
|
rs1259785074 CA410199471 |
199 | E>K | No |
ClinGen gnomAD |
|
|
rs573649658 CA320368484 |
206 | D>N | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
CA410199404 rs1336093164 |
208 | G>S | No |
ClinGen gnomAD |
|
|
rs1468733809 CA410199399 |
208 | G>V | No |
ClinGen gnomAD |
|
|
CA410199394 rs1362539590 |
209 | Y>C | No |
ClinGen gnomAD |
|
|
rs118030469 CA320368483 |
213 | C>S | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
CA320368482 rs774722685 |
214 | I>T | No |
ClinGen ExAC gnomAD |
|
|
rs534360016 CA320368481 |
215 | L>I | No |
ClinGen 1000Genomes ExAC gnomAD |
|
|
CA410199286 rs1425125966 |
224 | I>S | No |
ClinGen gnomAD |
|
|
rs766866890 CA320368477 |
224 | I>V | No |
ClinGen Ensembl |
|
|
CA320368476 rs778197787 |
226 | R>K | No |
ClinGen ExAC gnomAD |
|
|
rs778197787 CA320368475 |
226 | R>T | No |
ClinGen ExAC gnomAD |
|
|
CA320368474 rs573396181 |
227 | I>V | No |
ClinGen 1000Genomes ExAC TOPMed gnomAD |
|
|
rs1459964954 CA410199261 |
228 | N>S | No |
ClinGen gnomAD |
|
|
CA320368473 rs538899859 |
229 | A>T | No |
ClinGen ExAC TOPMed gnomAD |
|
|
rs1338490842 CA410199247 |
230 | S>I | No |
ClinGen gnomAD |
|
|
CA410199249 rs1338490842 |
230 | S>N | No |
ClinGen gnomAD |
|
|
CA410199244 rs1249347980 |
231 | K>Q | No |
ClinGen gnomAD |
|
|
CA320368471 rs1045013379 |
240 | R>P | No |
ClinGen TOPMed gnomAD |
|
|
CA410199178 rs1045013379 |
240 | R>Q | No |
ClinGen TOPMed gnomAD |
|
|
rs781502794 CA320368472 |
240 | R>W | No |
ClinGen ExAC TOPMed gnomAD |
|
|
CA320368469 rs185436984 |
242 | W>* | No |
ClinGen 1000Genomes gnomAD |
|
|
CA320368468 rs557340064 |
242 | W>C | No |
ClinGen Ensembl |
|
|
CA320368470 rs941264492 |
242 | W>R | No |
ClinGen TOPMed |
|
|
CA320368466 rs868648670 |
243 | E>* | No |
ClinGen TOPMed |
|
|
rs868648670 CA320368467 |
243 | E>K | No |
ClinGen TOPMed |
|
|
rs982766840 CA320368465 |
243 | E>V | No |
ClinGen TOPMed gnomAD |
|
|
CA410199149 rs1394797521 |
245 | Y>H | No |
ClinGen gnomAD |
|
|
CA410199129 rs1426196775 |
247 | L>R | No |
ClinGen gnomAD |
|
|
rs1385417383 CA410199126 |
248 | G>R | No |
ClinGen gnomAD |
|
|
rs568894882 CA320368462 |
249 | K>R | No |
ClinGen 1000Genomes TOPMed gnomAD |
|
|
rs1442235796 CA410199113 |
250 | F>L | No |
ClinGen gnomAD |
No associated diseases with B9A014
No regional properties for B9A014
| Type | Name | Position | InterPro Accession |
|---|---|---|---|
| No domain, repeats, and functional sites for B9A014 | |||
No GO annotations of cellular component
| Name | Definition |
|---|---|
| No GO annotations for cellular component |
No GO annotations of molecular function
| Name | Definition |
|---|---|
| No GO annotations for molecular function |
No GO annotations of biological process
| Name | Definition |
|---|---|
| No GO annotations for biological process |
No homologous proteins in AiPD
| UniProt AC | Gene Name | Protein Name | Species | Evidence Code |
|---|---|---|---|---|
| No homologous proteins | ||||
| 10 | 20 | 30 | 40 | 50 | 60 |
| MPRFASPLLR | NVIIRSQFDG | IKRKQCLQYL | KTLRTLQYDG | FKTVYFGETN | IPESLVTGED |
| 70 | 80 | 90 | 100 | 110 | 120 |
| ISDGYFIQTP | TWCIVHAAGS | QGWVPWKYRV | FLRDELCIKQ | EDSLFSEFCD | VVRKAYGKCV |
| 130 | 140 | 150 | 160 | 170 | 180 |
| IVVKERRQQE | EQRPKEDREA | EGQFYIPTVI | SLASIMCCPE | VAKSCGHELL | SLPSPCNYLN |
| 190 | 200 | 210 | 220 | 230 | 240 |
| PLDSAWSSLK | WFIINNRNEF | CLQSIDSGYS | YQCILFSNLI | SKGIERINAS | KWRTLTSKVR |
| 250 | |||||
| RWENYYLGKF | S |